Video Musik Buatan AI: Cara Kerjanya dan Alat yang Digunakan
Pelajari apa itu video musik buatan AI, bagaimana pipeline empat tahap membangunnya, dan model serta pemeriksaan apa yang membuatnya berfungsi.
Pencipta musik diproyeksikan memiliki 24% dari pendapatan mereka berisiko pada 2028, menurut studi dampak ekonomi CISAC yang dirangkum oleh GEMA. Proyeksi tersebut menempatkan video musik yang dihasilkan AI dalam sudut pandang yang berbeda: mereka bukan hanya eksperimen visual, tetapi pilihan produksi dengan konsekuensi bagi artis, editor, dan audiens.
Membuatnya secara bertanggung jawab membutuhkan lebih dari sekadar prompt yang menarik. Anda memerlukan rencana produksi berbasis lagu, klip yang dapat Anda perbaiki secara mandiri, pemeriksaan sinkronisasi yang terukur, dan catatan yang jelas tentang apa yang disumbangkan oleh manusia dan model.
Daftar Isi
- Apa Sebenarnya Video Musik Buatan AI Itu
- Empat Tahap dari Lagu hingga Video Selesai
- Model yang Mengubah Prompt dan Gambar Menjadi Gerakan
- Memeriksa Sinkronisasi Bibir dan Penyelarasan Beat
- Masalah Umum dan Cara Memperbaikinya
- Mengungkap Keterlibatan AI Tanpa Kehilangan Kepercayaan
- Uji Klip Pertama Anda Sebelum Berkomitmen pada Lagu Penuh
Apa Sebenarnya Video Musik Buatan AI Itu
Video musik buatan AI adalah video musik yang visualnya, soundtrack-nya, atau keduanya diproduksi dengan model generatif, bukan direkam atau difilmkan sepenuhnya. Misalnya Anda telah merekam lagu tentang meninggalkan rumah: Anda bisa membuat pemandangan jendela kereta, menganimasikan potret penyanyi, dan menyusun bidikan-bidikan tersebut di sekitar rekaman Anda yang sudah ada.
Dalam survei 2026 yang berfokus pada AS terhadap 1,003 pembuat video, musisi, pemasar, dan supervisor musik, 19% menggunakan AI generatif untuk menemukan atau membuat musik untuk video, sementara 32.7% telah menggunakan musik buatan AI sebagai audio akhir dalam konten yang diterbitkan, menurut Berklee. Ukuran-ukuran tersebut berkaitan dengan musik dalam alur kerja video, bukan bagian dari video musik yang sepenuhnya dibuat oleh AI.
Tiga cara proyek dapat menggunakan AI
- Sepenuhnya Sintetis: Baik lagu maupun gambar bergerak berasal dari model generatif, dengan seseorang mengarahkan dan memilih hasilnya.
- Hibrida: Trek yang direkam manusia menemani adegan yang dihasilkan, seperti urutan jendela kereta.
- Dibantu AI: Anda merekam pertunjukan, lalu menggunakan AI untuk pengeditan atau efek. Ini belum tentu video buatan AI dalam arti yang lebih sempit.
Anggap lagu sebagai skor dan prompt sebagai daftar bidikan yang diinterpretasikan oleh model. Anda tetap bertanggung jawab untuk memutuskan apa yang akan ditampilkan di layar.
Teks-ke-video mengubah instruksi tertulis menjadi klip. Gambar-ke-video menganimasikan gambar diam yang disediakan. Segmen adalah bagian lagu yang terbatas, prompt bidikan mengarahkan citranya, dan hasil edit akhir menggabungkan materi yang dipilih.
Sebelum memilih alat, sebutkan bagian-bagian proyek Anda: rekaman, vokal, lirik, gambar referensi, bidikan yang dihasilkan, dan pengeditan. Tandai mana yang dibuat manusia dan mana yang akan Anda hasilkan. Inventaris sederhana itu memberi tahu Anda versi mana yang sedang Anda buat.
Empat Tahap dari Lagu hingga Video Jadi
Produksi sepanjang lagu lebih mudah dikendalikan jika Anda memperlakukannya sebagai kumpulan pekerjaan yang dapat dikelola. Pipeline Dari Suara ke Visual yang diterbitkan mengikuti segmentasi lagu, analisis audio dan pembuatan skrip, pembuatan teks-ke-video, dan perakitan akhir.
Alur kerja di bawah ini memisahkan keputusan kreatif dari tugas rendering.
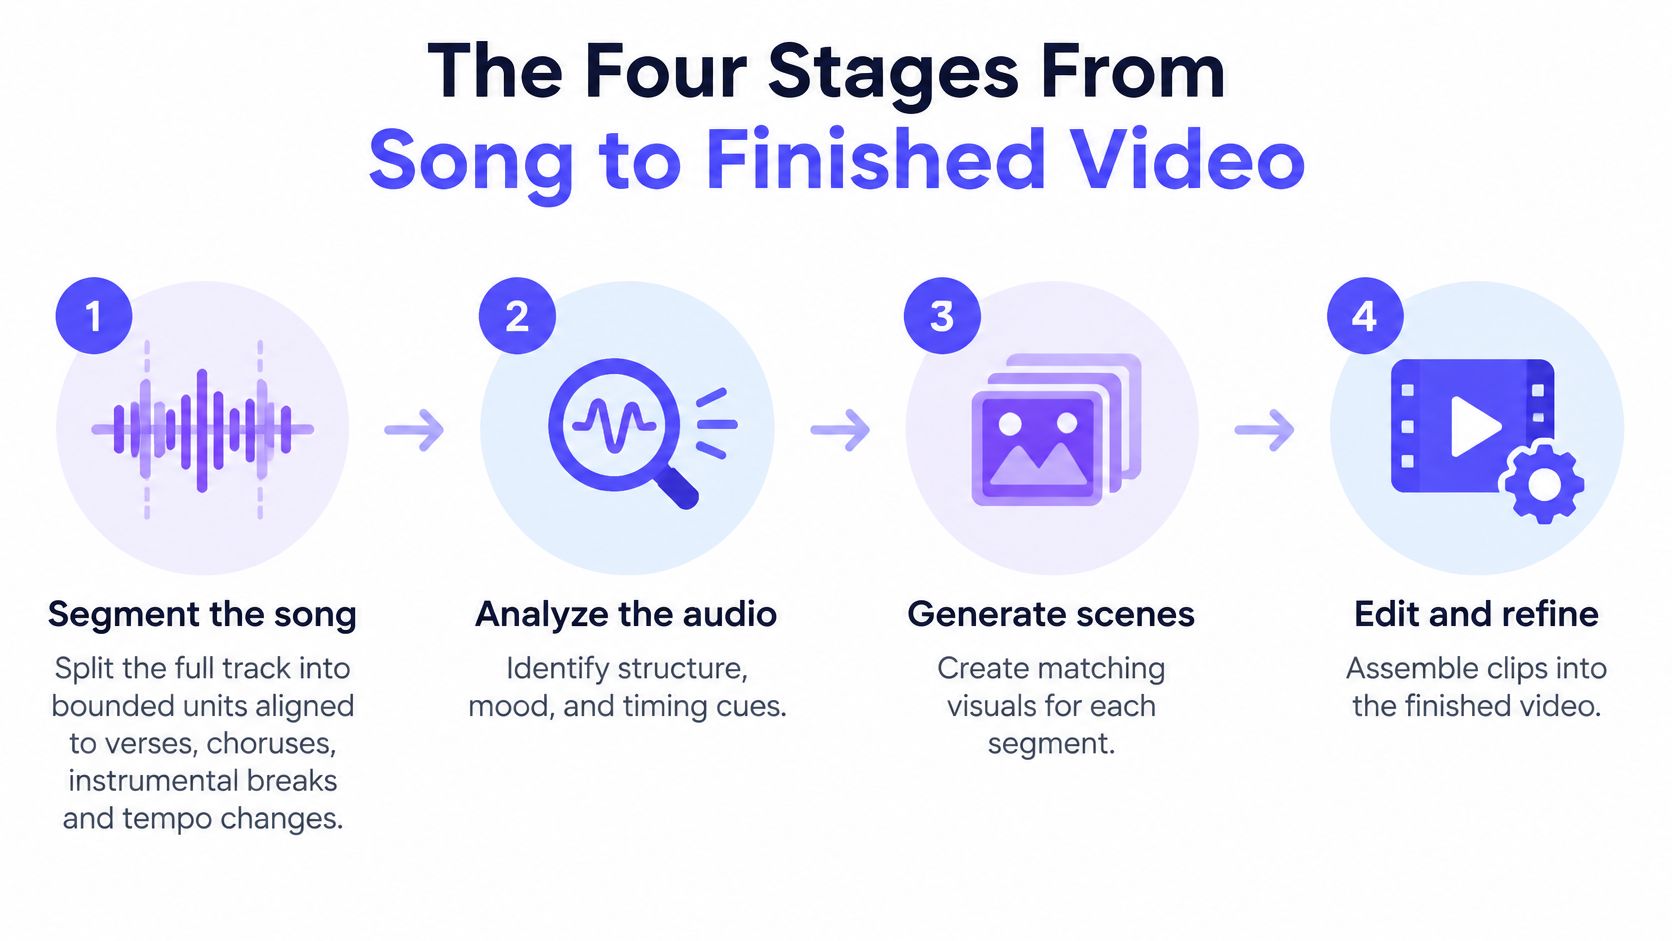
Bangun berdasarkan struktur musik
Segmentasikan lagu. Tandai bait, chorus, bagian instrumental saja, dan perubahan tempo, lalu bagi menjadi unit generasi yang terbatas. Satu bagian musik dapat berisi beberapa shot, jadi jangan salah mengira label chorus sebagai persyaratan untuk menghasilkan satu klip berkelanjutan.
Analisis audio dan tulis skrip visual. Identifikasi tempo, energi, bagian vokal, dan perubahan suasana hati, lalu tetapkan shot prompt untuk setiap segmen. Untuk lagu tentang meninggalkan rumah, bait yang tenang mungkin menggunakan adegan platform yang diam, sementara chorus memperkenalkan gerakan maju.
Hasilkan klip. Gunakan text-to-video untuk adegan yang dijelaskan secara independen atau image-to-video di mana referensi visual yang disediakan penting. Tinjau setiap hasil terhadap tujuan yang ditetapkan sebelum menerimanya ke dalam editan.
Rakitan editan akhir. Tempatkan klip yang disetujui dalam urutan deterministik terhadap trek master. Standardisasi frame rate, resolution, aspect ratio, dan loudness akhir agar output campuran berperilaku seperti satu produksi.
Tahap pipeline, input, dan output
| Tahap | Input | Output |
|---|---|---|
| 1. Segmentasikan lagu | Trek penuh dengan timestamp | Segmen terbatas dengan timecode dan label |
| 2. Analisis audio dan tulis skrip | Segmen, tempo, isyarat vokal | Satu shot prompt per segmen |
| 3. Hasilkan klip | Shot prompt, gambar referensi opsional | Satu klip pendek per segmen, dengan seed dan versi model disimpan |
| 4. Rakitan editan akhir | Klip dan trek asli | Satu render pada frame rate konstan dengan loudness yang dinormalisasi |
Buat setiap segmen dapat dipulihkan
Klip terbatas membantu membatasi temporal drift, di mana objek, identitas, atau tindakan berubah seiring berlanjutnya urutan yang dihasilkan. Ini juga memungkinkan Anda mengganti shot yang lemah tanpa membuang urutan yang berhasil.
Simpan manifes produksi yang berisi timecode, label lirik atau instrumental saja, tempo, energi, shot prompt, seed, versi model, dan lokasi output setiap segmen. Simpan pengidentifikasi gambar referensi bersama catatan tersebut jika berlaku. Seed membantu mendokumentasikan sebuah proses, tetapi bukan jaminan hasil yang identik di seluruh pembaruan model.
Aturan produksi: Perlakukan manifes segmen sebagai proyek yang dapat Anda edit, bukan hanya log unduhan yang selesai.
Sebagai panduan praktis untuk perencanaan dan perakitan, panduan produksi video musik AIMVG menyediakan referensi alur kerja yang berguna. Developer yang mengimplementasikan lapisan rendering dapat menggunakan panduan API pembuatan video AI untuk menghubungkan catatan segmen tersebut ke tugas generasi.
Model yang Mengubah Prompt dan Gambar Menjadi Gerakan
Text-to-video memberi Anda ruang untuk berkreasi; image-to-video memberi Anda titik awal visual. Perbedaan itu lebih penting daripada memilih satu model untuk keseluruhan lagu.
Dengan text-to-video, Anda mendeskripsikan subjek, latar, aksi, kamera, dan pencahayaan. Ini berguna untuk pemandangan, citra simbolis, dan establishing shots di mana wajah yang berulang persis tidak penting. Generasi independen dapat menafsirkan deskripsi yang sama secara berbeda, jadi pengulangan kata saja tidak boleh menjadi strategi kontrol identitas Anda.
Image-to-video dimulai dengan gambar diam yang Anda berikan. Ini dapat menjadi jangkar pakaian, komposisi, dan penampilan wajah, tetapi tidak mengunci setiap frame berikutnya. Gerakan atau sudut kamera yang sulit masih dapat menghasilkan perubahan yang tidak diinginkan.
Sesuaikan input dengan shot
Untuk penyanyi yang berulang, siapkan gambar referensi yang bersih dengan wajah tanpa halangan dan pakaian yang jelas. Synchronicity Labs tentang image-to-video adalah panduan yang berguna saat memutuskan cara mengubah gambar diam menjadi shot bergerak yang terarah.
Keluarga model berikut menyediakan kandidat awal, bukan peringkat kualitas. Perlakukan setiap peran sebagai sesuatu yang perlu diuji dengan materi Anda sendiri, dan verifikasi input yang didukung endpoint saat ini sebelum mengirimkan.
Keluarga model berdasarkan mode input dan peran dalam video musik
| Model | Mode input | Peran umum dalam video musik | Perhatikan |
|---|---|---|---|
| Kling 3.0 Standard | Text to video atau image to video | Shots serbaguna dan kandidat awal | Periksa batas durasi klip sebelum merencanakan segmen |
| Veo 3.1 Fast | Text to video | Iterasi suasana hati dan establishing shots | Verifikasi resolusi dan opsi audio saat ini |
| Seedance 2.0 | Image to video | Shots artis atau karakter yang berlabuh pada gambar diam | Membutuhkan gambar referensi yang bersih |
| Wan 2.6 | Text to video | Segmen instrumental dan abstrak | Periksa kontinuitas gerakan sebelum menerima |
| PixVerse V5.6 | Text to video | Segmen bergaya atau eksperimental | Pastikan stylization mempertahankan detail yang diperlukan |
Pisahkan penampilan dari performa
Wajah yang konsisten secara visual tidak secara otomatis berarti performa menyanyi. Model lip-sync dan audio-driven menangani gerakan mulut sesuai audio yang diberikan; animasi gambar biasa tidak boleh diasumsikan melakukan pekerjaan itu.
Kombinasi praktis adalah text-to-video untuk bagian atmosfer, image-to-video untuk shots artis yang berulang, dan langkah audio-driven untuk nyanyian yang terlihat. Anda juga dapat menghindari close-up performa sepenuhnya jika konsepnya lebih cocok sebagai narasi atau visualizer.
Fokuskan prompt pada aksi yang dapat diamati. Panduan prompting text-to-video dapat membantu menerjemahkan suasana abstrak menjadi arah kamera dan gerakan subjek. Batas klip, opsi resolusi, dan waktu generasi berubah antar rilis, jadi pilih model berdasarkan persyaratan segmen, bukan familiaritas merek.
Memeriksa Sinkronisasi Bibir dan Penyelarasan Ketukan
Wajah yang cantik pun masih bisa menyanyikan suku kata yang salah. Fidelitas visual dan sinkronisasi audiovisual adalah kriteria penerimaan yang terpisah: makalah evaluasi sinkronisasi bibir](https://arxiv.org/pdf/2505.21448) memeriksa 615 klip yang dihasilkan dan menggunakan ukuran termasuk Landmark Distance (LMD) dan Lip Sync Error–Confidence (LSE-C) untuk menilai gerakan mulut dan kesesuaian audio.
LMD mengukur kesalahan landmark area mulut terhadap gerakan yang diharapkan. LSE-C memperkirakan keyakinan bahwa gerakan bibir cocok dengan trek ucapan. Keduanya tidak boleh diperlakukan sebagai skor artistik yang lengkap, dan ukuran yang berorientasi pada ucapan memerlukan interpretasi yang cermat ketika diterapkan pada nyanyian yang berkelanjutan, vokal latar, atau bentuk mulut yang ekspresif.
Jalankan pemeriksaan secara berurutan
- Ekstrak stempel waktu ketukan dan awal. Gunakan alat analisis audio untuk mengidentifikasi posisi ritmis dan serangan nada. Tandai peristiwa mana yang memerlukan potongan atau aksen gerakan, daripada memaksakan setiap ketukan menjadi transisi.
- Tandai segmen vokal. Identifikasi di mana seorang penampil yang terlihat seharusnya bernyanyi. Gunakan kutipan vokal yang benar dan pertahankan offset-nya relatif terhadap trek master.
- Nilai dan periksa setiap klip. Terapkan ukuran terkait mulut pada nyanyian yang terlihat, lalu nilai waktu dan kesesuaian musikal. Tonton dengan kecepatan normal serta bingkai demi bingkai.
- Hasilkan ulang hanya segmen yang gagal. Catat apakah kegagalan tersebut berkaitan dengan waktu, artikulasi, kualitas gambar, atau interpretasi musikal sebelum meminta penggantian.
Pemeriksaan sinkronisasi dan di mana masing-masing berlaku
| Pemeriksaan | Apa yang Diukur | Berlaku Untuk |
|---|---|---|
| Kesalahan landmark mulut (LMD) | Jarak landmark area mulut dari gerakan yang diharapkan | Segmen vokal |
| Keyakinan sinkronisasi bibir (LSE-C) | Apakah gerakan bibir cocok dengan trek ucapan | Segmen vokal |
| Penyelarasan ketukan atau awal | Apakah potongan dan aksen gerakan jatuh pada peristiwa musikal | Setiap batas segmen |
| Kesesuaian ritme dan suasana hati | Apakah kecepatan dan nada gerakan mengikuti trek | Segmen instrumental |
Definisikan gerbang sebelum render akhir
Tidak ada skor kelulusan universal yang disediakan untuk setiap penyanyi, gaya, atau model. Kalibrasi gerbang Anda menggunakan klip yang telah Anda tinjau dan terima, lalu pertahankan pengaturan tersebut konsisten dalam proyek.
- Gerbang gerakan mulut: Tolak nyanyian yang terlihat dengan kesalahan artikulasi yang tidak dapat diterima atau keyakinan sinkronisasi yang lemah.
- Gerbang waktu: Tolak kesalahan yang tidak disengaja pada peristiwa musikal yang ditentukan.
- Gerbang konsistensi gerakan: Tolak gerakan yang bertentangan dengan kecepatan, suasana hati, atau subjek yang dimaksudkan.
- Gerbang persepsi: Tolak distorsi wajah yang mengganggu bahkan ketika skor numerik terlihat dapat diterima.
Misalkan mulut penyanyi mengikuti kata-kata yang benar tetapi seluruh penampilan dimulai terlambat. Koreksi offset klip sebelum memesan penampilan baru. Jika waktunya tepat tetapi mulut mengartikulasikan suara yang berbeda, pengeditan saja tidak akan memperbaikinya.
Potongan yang disengaja sebelum ketukan bisa berhasil. Potongan yang tidak disengaja setelah aksen yang dimaksud adalah kesalahan produksi.
Simpan skor dan catatan tinjauan dengan catatan segmen. Itu memberi Anda alasan untuk setiap penolakan dan membuat pemilihan pengganti menjadi tidak terlalu sewenang-wenang.
Masalah Umum dan Cara Memperbaikinya
Ketika karakter berganti pakaian atau wajah di antara bidikan, pertama, periksa materi sumber dan instruksi pembuatan. Jangan mencoba menyembunyikan setiap ketidakcocokan identitas dengan transisi. Putuskan apakah masalahnya berasal dari referensi, performa yang dihasilkan, atau perakitan.
Diagnosis sebelum membuat ulang
Masalah produksi umum, penyebab dan perbaikan
| Gejala | Penyebab Mungkin | Perbaikan |
|---|---|---|
| Karakter berubah di antara bidikan | Pergeseran prompt di seluruh segmen independen | Gunakan image-to-video dengan satu gambar referensi tetap per karakter |
| Mulut tidak sinkron dengan vokal | Waktu segmen tidak cocok dengan stem vokal | Buat ulang segmen dengan timecode yang dikoreksi dan periksa kembali kepercayaan diri lip-sync |
| Potongan tidak sesuai irama | Batas diatur secara visual, bukan oleh onset yang terdeteksi | Potong ulang berdasarkan timestamp onset selama perakitan |
| Kedipan atau perubahan bentuk pada klip panjang | Klip lebih panjang dari yang dapat dipertahankan stabil oleh model | Gunakan segmen yang lebih pendek dan gabungkan dalam pengeditan |
| Warna atau frame rate berbeda antar klip | Pengaturan output campuran | Normalisasi frame rate, resolusi, dan rasio aspek saat perakitan; cocokkan warna secara terpisah |
| Kenyaringan tidak merata antar potongan | Tidak ada normalisasi kenyaringan pada mix akhir | Normalisasi kenyaringan di seluruh pengeditan |
| Satu klip gagal setelah crash | Pengulangan seluruh proyek digunakan alih-alih pemulihan segmen | Buat ulang hanya segmen tersebut dari seed dan metadata yang tersimpan |
Pisahkan perbaikan pengeditan dari perubahan desain
Perbaikan perakitan meliputi memindahkan potongan, mengoreksi offset, menyesuaikan warna, atau memperbaiki pengaturan ekspor. Coba ini sebelum membayar untuk citra baru. Pemotongan dapat menyelesaikan ketidakcocokan framing, tetapi pratinjau hasilnya dengan hati-hati agar Anda tidak menghilangkan tangan penyanyi atau memotong aksi penting.
Perbaikan pembuatan membutuhkan klip baru karena konten sebenarnya salah. Contohnya termasuk wajah yang berubah bentuk, artikulasi yang salah, atau gerakan kamera yang mengaburkan subjek. Ubah instruksi spesifik yang gagal daripada menulis ulang seluruh prompt.
Perbaikan konsep membutuhkan pemikiran ulang yang lebih luas. Jika setiap bidikan bergantung pada koreografi kompleks yang tidak dapat dipertahankan oleh pendekatan pilihan Anda, sederhanakan performa atau beralih ke perlakuan naratif.
Untuk pekerjaan berbasis referensi, panduan screenshot-to-video menawarkan titik awal yang berguna untuk mengubah gambar yang disiapkan menjadi gerakan. Periksa gambar diam terlebih dahulu: blur yang sudah ada, wajah yang terhalang, dan anatomi yang membingungkan adalah dasar yang buruk untuk animasi.
Pertahankan lagu sebagai master track berkelanjutan kecuali jika aransemen Anda sengaja berubah. Audio klip yang tidak disengaja dapat menyebabkan lonjakan kenyaringan bahkan ketika rekaman aslinya konsisten. Setelah crash, pulihkan file yang selesai dan lanjutkan dari segmen yang gagal daripada menganggap seluruh produksi hilang.
Mengungkap Keterlibatan AI Tanpa Kehilangan Kepercayaan
Dibantu AI dan Dihasilkan AI menggambarkan kontribusi yang berbeda. Pertunjukan manusia dengan pembersihan AI tidak sama dengan vokalis sintetis, dan label umum dapat mengaburkan perbedaan itu daripada memperjelasnya.
Simpan catatan kontribusi perekaman dan pengeditan saat Anda bekerja.
Dalam 2025 eksperimen dengan 120 partisipan, audio identik menerima peringkat kesukaan, keterlibatan, dampak emosional, dan kualitas yang lebih tinggi ketika dikaitkan dengan pianis manusia, dan 79% melaporkan adanya perbedaan, menurut studi kepengarangan audiovisual. Itu adalah alasan untuk menulis pengungkapan dengan hati-hati, bukan pembenaran untuk menyembunyikan kontribusi material.
Beri label kontribusinya, bukan hanya proyeknya
- Musik dan lirik: Nyatakan secara terpisah apakah komposisi atau lirik dihasilkan.
- Vokal: Identifikasi suara nyanyian sintetis daripada menyiratkan pertunjukan manusia yang direkam.
- Visual: Bedakan adegan yang dihasilkan dari rekaman yang difilmkan.
- Pengeditan: Jelaskan pembersihan atau efek AI tanpa menyiratkan bahwa pertunjukan dasarnya adalah sintetis.
Untuk proyek hibrida, deskripsi dapat menyatakan bahwa artis menulis dan membawakan lagu, sementara visual dihasilkan AI dan diedit manusia. Untuk penyanyi sintetis, buat fakta itu cukup menonjol sehingga penonton tidak akan salah mengira pertunjukan itu sebagai rekaman orang yang digambarkan.
Prinsip Pengungkapan: Bersikaplah spesifik tentang apa yang dihasilkan dan sama spesifiknya tentang apa yang dibuat orang.
Gunakan judul ketika kepengarangan sintetis adalah inti dari premis, deskripsi untuk detail kontribusi, dan kredit atau kartu akhir untuk catatan produksi yang lebih lengkap. Ikuti persyaratan platform yang berlaku daripada memperlakukan penempatan sebagai pilihan pemasaran semata.
Sebagai referensi tontonan tambahan, video tersemat tersedia di bawah.
Uji kata-kata yang jujur terhadap waktu tonton, penyelesaian, komentar, dan kepercayaan audiens, pasar demi pasar. Pertahankan fakta-fakta yang mendasari tidak berubah di seluruh pengujian. Label yang meningkatkan klik tetapi membuat penonton bingung tentang vokalis bukanlah pengungkapan yang berhasil.
Uji Klip Pertamamu Sebelum Berkomitmen pada Lagu Penuh
Mulailah dengan bagian yang dapat mengungkap masalah produksi tersulitmu. Bagian chorus dengan nyanyian yang terlihat jelas dan aksen ritmis yang tegas lebih informatif daripada pemandangan atmosferik jika video yang selesai bergantung pada close-up penampilan.
Jalankan uji penerimaan kecil
Pilih cuplikan yang representatif. Misalnya, kamu bisa menguji bagian chorus berdurasi sepuluh hingga lima belas detik, asalkan endpoint yang dipilih mendukung durasi tersebut. Sertakan frasa vokal dan peristiwa musikal yang ingin kamu tekankan.
Pilih pendekatan input. Kami merekomendasikan Kling 3.0 Standard sebagai model video pertama untuk memulai, menggunakan text-to-video atau image-to-video. Pilih bidikan berbasis referensi saat pengenalan sangat penting.
Tulis satu prompt bidikan yang terfokus. Tentukan subjek, aksi, framing, gerakan kamera, dan pencahayaan. Hindari menggabungkan perubahan lokasi, perubahan kostum, dan penampilan kompleks dalam percobaan yang sama.
Hasilkan dan lacak tugas. Job gambar dan video kami mengembalikan tugas yang bisa kamu polling, atau kamu bisa mengatur webhook untuk memberi tahu aplikasimu saat hasilnya siap. Dalam alat web, gunakan tampilan progresnya alih-alih mengirimkan job duplikat saat menunggu.
Terapkan pemeriksaan penerimaan. Periksa nyanyian yang terlihat jelas, aksen ketukan yang ditentukan, identitas, dan artefak yang mengganggu. Catat kategori kegagalan daripada menerima klip hanya karena terlihat mengesankan.
Skalakan hanya setelah penerimaan. Bawa struktur prompt yang berhasil dan pilihan referensi ke dalam rencana segmenmu. Simpan hasil uji sebagai perbandingan untuk bidikan selanjutnya.
Gunakan antarmuka untuk memeriksa kontrol yang tersedia sebelum mengirimkan permintaan generasi.
Periksa biaya sebelum penskalaan
Tinjau kebijakan harga dan kegagalan sebelum mengirimkan. Balasan kami terhadap permintaan video menyatakan biaya maksimum sebelum generasi dimulai; video yang selesai ditagih dengan harga akhirnya, dan generasi yang gagal tidak ditagih.
Jika uji lolos baik pemeriksaan lip-sync yang relevan maupun pemeriksaan ketukan yang kamu tentukan, lanjutkan ke rencana segmen penuh. Jika gagal, perbaiki kesalahan waktu terlebih dahulu, lalu ubah model atau gambar referensi di mana konten yang dihasilkan menjadi masalah. Uji ulang sebelum menerapkan pilihan tersebut ke seluruh lagu.
UberLLM menawarkan akses ke model video, gambar, musik, dan ucapan melalui API terpadu, sehingga kamu dapat membangun tahapan terpisah dari pipeline video musik tanpa perlu memelihara integrasi yang berbeda untuk setiap penyedia. Kunjungi UberLLM untuk membandingkan opsi model dan menjalankan klip representatif sebelum berkomitmen pada produksi lagu penuh.