Video Musicale Generato dall'IA: Come Funziona e Strumenti Utilizzati
Scopri cos'è un video musicale generato dall'IA, come la pipeline a quattro fasi ne costruisce uno e quali modelli e controlli lo fanno funzionare.
I creatori di musica si prevede che avranno 24% delle loro entrate a rischio entro il 2028, secondo lo studio sull'impatto economico del CISAC riassunto da GEMA. Questa proiezione mette i video musicali generati dall'IA sotto una luce diversa: non sono solo esperimenti visivi, ma scelte di produzione con conseguenze per artisti, editor e pubblico.
Realizzarne uno in modo responsabile richiede più di un prompt convincente. Hai bisogno di un piano di produzione basato sulla canzone, clip che puoi riparare in modo indipendente, controlli di sincronizzazione misurabili e un resoconto chiaro di ciò che persone e modelli hanno contribuito.
Indice dei contenuti
- Cos'è in realtà un video musicale generato dall'IA
- Le quattro fasi dal brano al video finito
- Modelli che trasformano prompt e immagini in movimento
- Verifica della sincronizzazione labiale e dell'allineamento del ritmo
- Problemi comuni e come risolverli
- Rivelare il coinvolgimento dell'IA senza perdere la fiducia
- Testa la tua prima clip prima di impegnarti in un brano completo
Che cos'è un video musicale generato dall'IA
Un video musicale generato dall'IA è un video musicale le cui immagini, colonna sonora, o entrambi, sono prodotti con modelli generativi anziché essere interamente registrati o filmati. Diciamo che hai registrato una canzone sull'abbandono di casa: potresti generare scenari dal finestrino di un treno, animare un ritratto del cantante e assemblare quelle riprese attorno alla tua registrazione esistente.
In un sondaggio focalizzato sugli Stati Uniti 2026 su 1,003 creatori di video, musicisti, esperti di marketing e supervisori musicali, 19% hanno utilizzato l'IA generativa per trovare o creare musica per video, mentre 32.7% avevano utilizzato musica generata dall'IA come audio finale in contenuti pubblicati, secondo Berklee. Queste misure riguardano la musica all'interno dei flussi di lavoro video, non la quota di video musicali generati interamente dall'IA.
Tre modi in cui un progetto può usare l'IA
- Completamente sintetico: Sia la canzone che le immagini in movimento provengono da modelli generativi, con una persona che dirige e seleziona i risultati.
- Ibrido: Una traccia registrata da un essere umano accompagna scene generate, come la sequenza dal finestrino del treno.
- Assistito dall'IA: Filmi la performance, quindi usi l'IA per l'editing o gli effetti. Questo non è necessariamente un video generato dall'IA nel senso più stretto.
Pensa alla canzone come alla colonna sonora e ai prompt come a una lista di riprese che un modello interpreta. Sei comunque responsabile di decidere cosa appartiene allo schermo.
Text-to-video trasforma le istruzioni scritte in una clip. Image-to-video anima un'immagine fissa fornita. Un segmento è una parte delimitata della canzone, un shot prompt dirige le sue immagini, e il final edit combina il materiale selezionato.
Prima di scegliere gli strumenti, nomina le parti del tuo progetto: registrazione, voci, testi, immagini di riferimento, riprese generate ed editing. Segna quali sono fatte dall'uomo e quali genererai. Questo semplice inventario ti dice quale versione stai realizzando.
Le Quattro Fasi Dalla Canzone al Video Finito
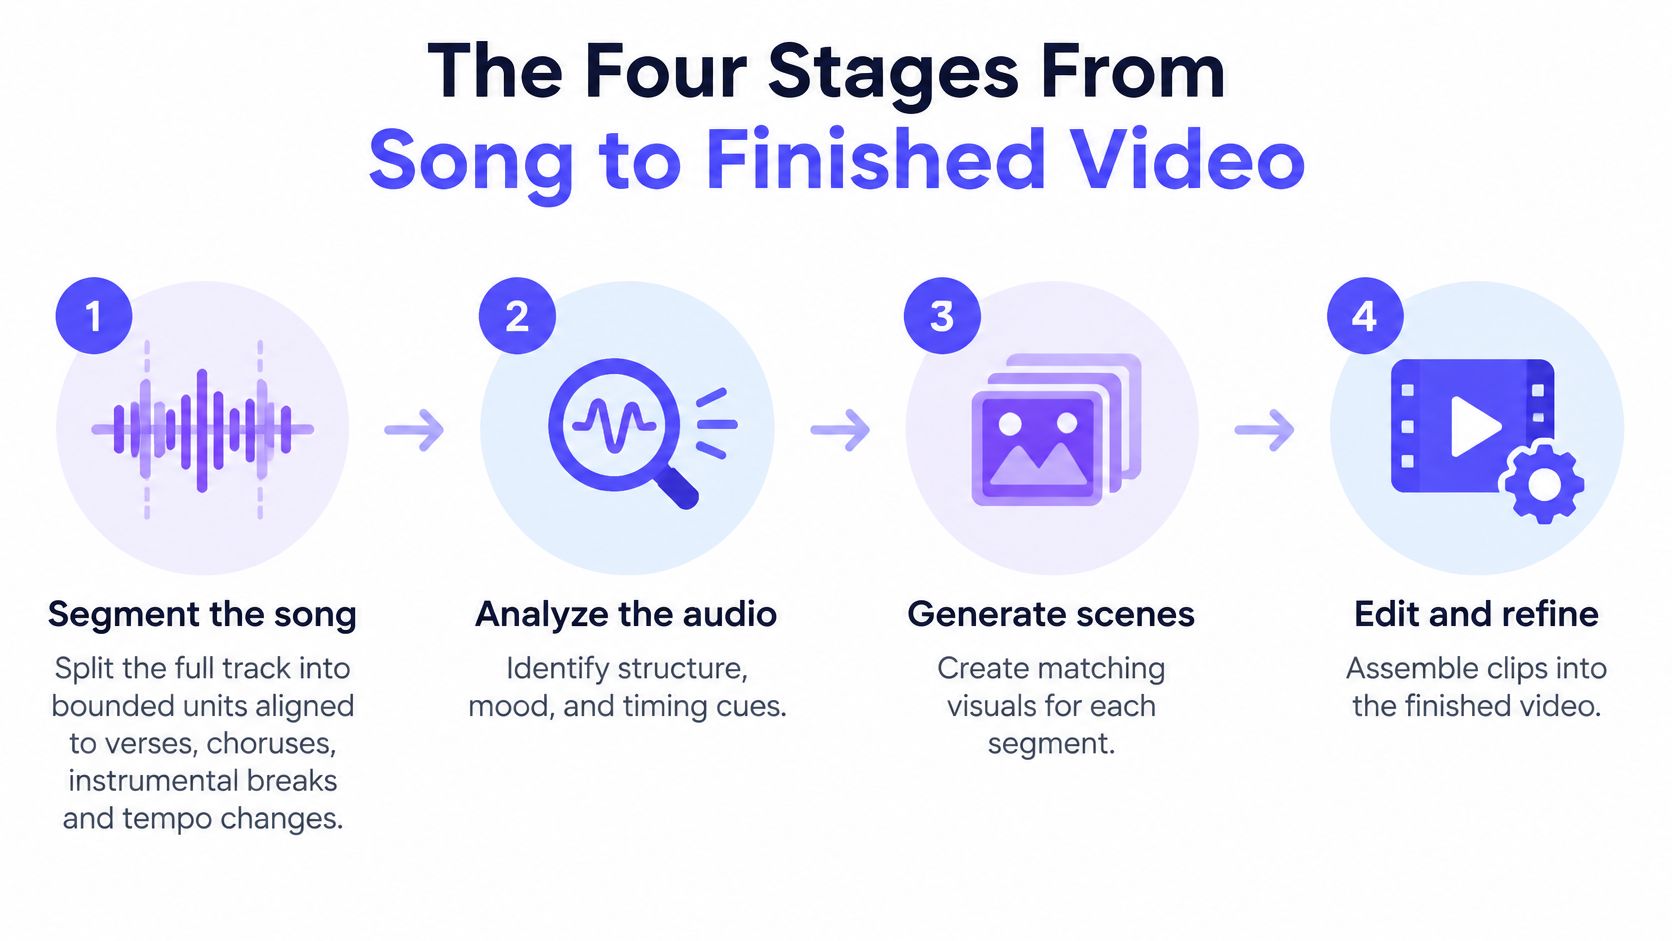
Una produzione della durata di una canzone è più facile da controllare se la si tratta come una collezione di lavori gestibili. La pipeline From Sound to Sight pubblicata segue la segmentazione della canzone, l'analisi audio e la generazione dello script, la generazione da testo a video e l'assemblaggio finale.
Il flusso di lavoro seguente separa le decisioni creative dai compiti di rendering.
Costruire attorno alla struttura musicale
Segmenta la canzone. Contrassegna strofe, ritornelli, pause solo musicali e cambiamenti di tempo, quindi dividili in unità di generazione delimitate. Una sezione musicale può contenere diverse inquadrature, quindi non confondere un'etichetta di ritornello con il requisito di generare un clip continuo.
Analizza l'audio e scrivi lo script visivo. Identifica tempo, energia, passaggi vocali e cambiamenti di umore, quindi assegna un prompt di inquadratura a ogni segmento. Per la canzone di addio a casa, una strofa tranquilla potrebbe usare una scena di piattaforma statica, mentre il ritornello introduce un movimento in avanti.
Genera i clip. Usa text-to-video per scene descritte indipendentemente o image-to-video dove un riferimento visivo fornito è importante. Rivedi ogni risultato rispetto al suo scopo assegnato prima di accettarlo nell'editing.
Assembla l'editing finale. Posiziona i clip approvati in ordine deterministico rispetto alla traccia master. Standardizza frame rate, risoluzione, aspect ratio e loudness finale in modo che gli output misti si comportino come un'unica produzione.
Fasi della pipeline, input e output
| Fase | Input | Output |
|---|---|---|
| 1. Segmenta la canzone | Traccia completa con timestamp | Segmenti delimitati con timecode ed etichette |
| 2. Analizza l'audio e scrivi lo script | Segmenti, tempo, segnali vocali | Un prompt di inquadratura per segmento |
| 3. Genera i clip | Prompt di inquadratura, fermo immagine di riferimento opzionali | Un breve clip per segmento, con seed e versione del modello memorizzati |
| 4. Assembla l'editing finale | Clip e la traccia originale | Un render a frame rate costante con loudness normalizzato |
Rendi ogni segmento recuperabile
I clip delimitati aiutano a limitare il temporal drift, dove oggetti, identità o azioni cambiano man mano che una sequenza generata continua. Ti permettono anche di sostituire un'inquadratura debole senza scartare una sequenza di successo.
Memorizza un manifesto di produzione contenente il timecode, l'etichetta solo lirica o musicale, il tempo, l'energia, il prompt di inquadratura, il seed, la versione del modello e la posizione di output di ogni segmento. Conserva gli identificatori delle immagini di riferimento insieme a quel record, quando applicabile. Un seed aiuta a documentare un'esecuzione, ma non è una garanzia di risultati identici attraverso gli aggiornamenti del modello.
Regola di produzione: Tratta il manifesto dei segmenti come il tuo progetto modificabile, non solo come un registro di download completati.
Per un accompagnamento pratico alla pianificazione e all'assemblaggio, il walkthrough di produzione di video musicali di AIMVG fornisce un utile riferimento per il flusso di lavoro. Gli sviluppatori che implementano il livello di rendering possono usare la guida API per la generazione di video AI per connettere quei record di segmenti ai compiti di generazione.
Modelli che trasformano prompt e immagini in movimento
Il text-to-video ti dà spazio per inventare; l'image-to-video ti offre un punto di partenza visivo. Questa distinzione è più importante che scegliere un solo modello per un'intera canzone.
Con il text-to-video, descrivi il soggetto, l'ambientazione, l'azione, la telecamera e l'illuminazione. È utile per scenari, immagini simboliche e inquadrature di apertura dove un volto ricorrente esatto non è essenziale. Generazioni indipendenti possono interpretare la stessa descrizione in modo diverso, quindi la sola ripetizione delle parole non dovrebbe essere la tua strategia di controllo dell'identità.
L'image-to-video parte da un'immagine fissa che fornisci. Può ancorare abbigliamento, composizione e aspetto facciale, ma non blocca ogni fotogramma successivo. Un movimento difficile o un'angolazione della telecamera possono comunque produrre cambiamenti indesiderati.
Abbina l'input all'inquadratura
Per un cantante ricorrente, prepara un'immagine di riferimento pulita con un volto senza ostacoli e abiti leggibili. Synchronicity Labs sull'image-to-video è un utile compagno quando decidi come trasformare un'immagine fissa in un'inquadratura in movimento diretta.
Le seguenti famiglie forniscono candidati iniziali, non una classifica di qualità. Tratta ogni ruolo come qualcosa da testare con il tuo materiale e verifica gli input supportati dall'endpoint attuale prima di inviare.
Famiglie di modelli per modalità di input e ruolo nel video musicale
| Modello | Modalità di input | Ruolo tipico in un video musicale | Fai attenzione a |
|---|---|---|---|
| Kling 3.0 Standard | Text to video o image to video | Inquadrature generiche e un candidato iniziale | Verifica i limiti di lunghezza dei clip prima di pianificare i segmenti |
| Veo 3.1 Fast | Text to video | Iterazione sull'atmosfera e inquadrature di apertura | Verifica la risoluzione attuale e le opzioni audio |
| Seedance 2.0 | Image to video | Inquadrature dell'artista o del personaggio ancorate a un'immagine fissa | Richiede un'immagine di riferimento pulita |
| Wan 2.6 | Text to video | Segmenti strumentali e astratti | Ispeziona la continuità del movimento prima di accettare |
| PixVerse V5.6 | Text to video | Segmenti stilizzati o sperimentali | Verifica che la stilizzazione preservi i dettagli richiesti |
Separa l'aspetto dalla performance
Un volto visivamente coerente non è automaticamente una performance canora. I modelli di lip-sync e audio-driven gestiscono il movimento della bocca in base all'audio fornito; l'animazione ordinaria delle immagini non dovrebbe essere data per scontata per svolgere quel compito.
Una combinazione pratica è il text-to-video per passaggi atmosferici, l'image-to-video per inquadrature ricorrenti dell'artista e un passaggio audio-driven per il canto visibile. Puoi anche evitare completamente i primi piani della performance se il concetto funziona meglio come narrazione o visualizzatore.
Mantieni i prompt focalizzati sull'azione osservabile. La guida ai prompt text-to-video può aiutare a tradurre un'atmosfera astratta in direzione della telecamera e movimento del soggetto. I limiti dei clip, le opzioni di risoluzione e il tempo di generazione cambiano tra le release, quindi scegli il modello in base ai requisiti del segmento, non alla familiarità con il brand.
Verifica della sincronizzazione labiale e dell'allineamento al ritmo
Un bel viso può comunque cantare la sillaba sbagliata. La fedeltà visiva e la sincronizzazione audiovisiva sono criteri di accettazione separati: il documento di valutazione del lip-sync esamina 615 clip generate e utilizza misure come la Landmark Distance (LMD) e la Lip Sync Error–Confidence (LSE-C) per valutare il movimento della bocca e la corrispondenza audio.
LMD misura l'errore dei punti di riferimento della regione della bocca rispetto al movimento atteso. LSE-C stima la fiducia che il movimento delle labbra corrisponda alla traccia vocale. Nessuna delle due dovrebbe essere trattata come un punteggio artistico completo, e una misura orientata al parlato richiede un'attenta interpretazione se applicata a canto prolungato, cori o forme espressive della bocca.
Esegui i controlli in ordine
- Estrai i timestamp di battito e attacco. Usa uno strumento di analisi audio per identificare le posizioni ritmiche e gli attacchi delle note. Contrassegna quali eventi richiedono un taglio o un accento di movimento, piuttosto che forzare ogni battito in una transizione.
- Contrassegna i segmenti vocali. Identifica dove un performer visibile dovrebbe cantare. Usa l'estratto vocale corretto e preserva il suo offset rispetto alla traccia master.
- Valuta e ispeziona ogni clip. Applica misure relative alla bocca al canto visibile, quindi valuta il tempismo e l'adattamento musicale. Guarda a velocità normale e fotogramma per fotogramma.
- Rigenera solo i segmenti falliti. Registra se il fallimento riguarda il tempismo, l'articolazione, la qualità dell'immagine o l'interpretazione musicale prima di richiedere una sostituzione.
Controlli di sincronizzazione e dove si applicano
| Controllo | Cosa Misura | Si Applica A |
|---|---|---|
| Errore dei punti di riferimento della bocca (LMD) | Distanza dei punti di riferimento della regione della bocca dal movimento atteso | Segmenti vocali |
| Fiducia nella sincronizzazione labiale (LSE-C) | Se il movimento delle labbra corrisponde alla traccia vocale | Segmenti vocali |
| Allineamento battito o attacco | Se tagli e accenti di movimento cadono su eventi musicali | Ogni confine di segmento |
| Corrispondenza ritmo e atmosfera | Se il ritmo e il tono del movimento seguono la traccia | Segmenti strumentali |
Definisci i gate prima del rendering finale
Non esiste un punteggio di superamento universale fornito per ogni cantante, stile o modello. Calibra i tuoi gate usando clip che hai revisionato e accettato, quindi mantieni quelle impostazioni coerenti all'interno del progetto.
- Gate di movimento della bocca: Rifiuta il canto visibile con errori di articolazione inaccettabili o scarsa fiducia nella sincronizzazione.
- Gate di tempismo: Rifiuta mancate intenzionali in eventi musicali designati.
- Gate di coerenza del movimento: Rifiuta movimenti che contraddicono il ritmo, l'atmosfera o il soggetto intesi.
- Gate percettivo: Rifiuta la distorsione facciale che distrae anche quando un punteggio numerico sembra accettabile.
Supponiamo che la bocca del cantante segua le parole corrette ma l'intera performance inizi in ritardo. Correggi l'offset della clip prima di commissionare una nuova performance. Se il tempismo è corretto ma la bocca articola suoni diversi, una semplice modifica non lo riparerà.
Un taglio deliberato prima del battito può funzionare. Un taglio accidentale dopo l'accento inteso è un errore di produzione.
Salva i punteggi e le note di revisione con il record del segmento. Questo ti dà una ragione per ogni rifiuto e rende la selezione della sostituzione meno arbitraria.
Problemi Comuni e Come Risolverli
Quando un personaggio cambia abito o volto tra le inquadrature, ispeziona prima il materiale sorgente e le istruzioni di generazione. Non cercare di nascondere ogni discrepanza di identità con una transizione. Decidi se il problema appartiene al riferimento, alla performance generata o all'assemblaggio.
Diagnostica prima di rigenerare
Problemi di produzione comuni, cause e soluzioni
| Sintomo | Causa Probabile | Soluzione |
|---|---|---|
| I personaggi cambiano tra le inquadrature | Deriva del prompt tra segmenti indipendenti | Usa l'image-to-video con un'immagine di riferimento fissa per personaggio |
| Bocca non sincronizzata con le voci | La tempistica del segmento non corrisponde alla traccia vocale | Rigenera il segmento con timecode corretti e ricontrolla la confidenza del lip-sync |
| I tagli non cadono a tempo | Confini impostati a occhio, non da attacchi rilevati | Ritaglio sui timestamp degli attacchi durante l'assemblaggio |
| Sfarfallio o morphing in clip lunghe | Clip più lunga di quanto il modello rimanga stabile | Usa segmenti più brevi e uniscili nel montaggio |
| Colore o frame rate diversi tra le clip | Impostazioni di output miste | Normalizza frame rate, risoluzione e aspect ratio in fase di assemblaggio; abbina il colore separatamente |
| Loudness irregolare tra i tagli | Nessuna normalizzazione del loudness nel mix finale | Normalizza il loudness su tutto il montaggio |
| Una clip è fallita dopo un crash | Riesecuzione dell'intero progetto usata invece del recupero del segmento | Rigenera solo quel segmento dal suo seed e metadata memorizzati |
Separa le riparazioni di montaggio dalle modifiche di design
Riparazioni di assemblaggio includono spostare un taglio, correggere un offset, abbinare il colore o sistemare un'impostazione di esportazione. Prova queste soluzioni prima di pagare per nuove immagini. Il cropping può risolvere una discrepanza di inquadratura, ma visualizza l'anteprima del risultato con attenzione per non rimuovere le mani di un cantante o tagliare un'azione importante.
Riparazioni di generazione richiedono una nuova clip perché il contenuto effettivo è sbagliato. Esempi includono un volto che si deforma, un'articolazione errata o un movimento di camera che oscura il soggetto. Modifica l'istruzione specifica fallita piuttosto che riscrivere l'intero prompt.
Riparazioni di concetto richiedono un ripensamento più ampio. Se ogni inquadratura dipende da una coreografia complessa che l'approccio scelto non può preservare, semplifica la performance o passa a un trattamento narrativo.
Per lavori basati su riferimento, la guida screenshot-to-video offre un utile punto di partenza per trasformare un'immagine preparata in movimento. Ispeziona prima l'immagine fissa: sfocature incorporate, volti ostruiti e anatomia confusa sono basi scadenti per l'animazione.
Mantieni la canzone come traccia master continua a meno che il tuo arrangiamento non cambi intenzionalmente. L'audio accidentale della clip può introdurre salti di loudness anche quando la registrazione originale è coerente. Dopo un crash, recupera i file completati e riprendi dal segmento fallito piuttosto che considerare l'intera produzione persa.
Dichiarare il coinvolgimento dell'IA senza perdere la fiducia
Assistito dall'IA e Generato dall'IA descrivono contributi diversi. Un'esibizione umana con pulizia IA non è la stessa cosa di un cantante sintetico, e un'etichetta generica può oscurare quella distinzione invece di chiarirla.
Tieni traccia dei contributi di registrazione e montaggio mentre lavori.
In un esperimento del 2025 con 120 partecipanti, un audio identico ha ricevuto valutazioni più alte di piacevolezza, coinvolgimento, impatto emotivo e qualità quando attribuito a un pianista umano, e 79% hanno riferito di aver notato differenze, secondo lo studio sull'attribuzione autoriale audiovisiva. È un motivo per scrivere la dichiarazione con attenzione, non una giustificazione per nascondere contributi materiali.
Etichetta il contributo, non solo il progetto
- Musica e testi: Indica separatamente se la composizione o le parole sono state generate.
- Voce: Identifica una voce di canto sintetica invece di lasciar intendere un'esibizione umana registrata.
- Immagini: Distingui le scene generate dalle riprese filmate.
- Montaggio: Descrivi la pulizia IA o gli effetti senza suggerire che l'esibizione di base fosse sintetica.
Per un progetto ibrido, una descrizione potrebbe indicare che l'artista ha scritto ed eseguito la canzone, mentre gli elementi visivi sono stati generati dall'IA e modificati da una persona. Per un cantante sintetico, rendi quel fatto così evidente che gli spettatori non scambino l'esibizione per una registrazione della persona raffigurata.
Principio di dichiarazione: Sii specifico su ciò che è stato generato e altrettanto specifico su ciò che le persone hanno creato.
Usa il titolo quando la paternità sintetica è centrale per la premessa, la descrizione per i dettagli dei contributi, e i crediti o una schermata finale per il resoconto di produzione più completo. Segui i requisiti applicabili della piattaforma invece di considerare il posizionamento una scelta puramente di marketing.
Per un ulteriore riferimento di visione, il video incorporato è disponibile qui sotto.
Testa una formulazione veritiera rispetto a tempo di visione, completamento, commenti e fiducia del pubblico, mercato per mercato. Mantieni invariati i fatti di base tra i test. Un'etichetta che migliora i clic ma lascia gli spettatori confusi sul cantante non è una dichiarazione riuscita.
Testa la tua prima clip prima di impegnarti in una canzone completa
Inizia con un passaggio che possa rivelare il tuo problema di produzione più difficile. Un ritornello con canto visibile e un chiaro accento ritmico è più informativo di uno scenario atmosferico se il video finito dipende da primi piani della performance.
Esegui un piccolo test di accettazione
Scegli un estratto rappresentativo. Ad esempio, potresti testare un passaggio del ritornello di dieci-quindici secondi, a condizione che l'endpoint selezionato supporti tale durata. Includi sia una frase vocale che un evento musicale che intendi enfatizzare.
Scegli l'approccio di input. Raccomandiamo Kling 3.0 Standard come primo modello video da cui iniziare, usando text-to-video o image-to-video. Scegli un'inquadratura guidata da riferimento quando la riconoscibilità è essenziale.
Scrivi un prompt per un'inquadratura mirata. Specifica soggetto, azione, inquadratura, movimento della telecamera e illuminazione. Evita di combinare un cambio di location, un cambio di costume e una performance complessa nello stesso tentativo.
Genera e traccia il compito. I nostri job di immagine e video restituiscono un compito che puoi poll, oppure puoi impostare un webhook per notificare la tua app quando il risultato è pronto. In uno strumento web, usa la sua vista di progresso invece di inviare job duplicati mentre aspetti.
Applica i controlli di accettazione. Ispeziona il canto visibile, gli accenti ritmici designati, l'identità e gli artefatti che distraggono. Registra la categoria di fallimento piuttosto che accettare una clip perché sembra impressionante.
Scala solo dopo l'accettazione. Trasporta la struttura del prompt e le scelte di riferimento riuscite nel tuo piano di segmenti. Conserva il risultato del test come confronto per le inquadrature successive.
Usa l'interfaccia per ispezionare i controlli disponibili prima di inviare una richiesta di generazione.
Controlla il costo prima di scalare
Rivedi i prezzi e le politiche di fallimento prima di inviare. La nostra risposta a una richiesta video indica il costo massimo prima che la generazione inizi; un video completato viene fatturato al suo prezzo finale e le generazioni fallite non vengono fatturate.
Se il test supera sia il pertinente controllo di lip-sync che i tuoi controlli ritmici designati, procedi al piano di segmenti completo. Se fallisce, correggi prima gli errori di temporizzazione, quindi cambia il modello o l'immagine di riferimento dove il contenuto generato è il problema. Ripeti il test prima di moltiplicare quella scelta per tutta la canzone.
UberLLM offre accesso a modelli video, immagine, musica e voce tramite un'API unificata, così puoi costruire le diverse fasi di una pipeline di video musicali senza mantenere un'integrazione diversa per ogni provider. Visita UberLLM per confrontare le opzioni dei modelli ed eseguire una clip rappresentativa prima di impegnarti in una produzione di una canzone completa.