KI-generiertes Musikvideo: Wie es funktioniert und welche Tools verwendet werden
Erfahren Sie, was ein KI-generiertes Musikvideo ist, wie die vierstufige Pipeline eines erstellt und welche Modelle und Prüfungen es zum Laufen bringen.
Musikschaffende werden voraussichtlich bis 2028 24% ihrer Einnahmen gefährdet sehen, laut der von GEMA zusammengefassten CISAC-Wirtschaftsfolgenstudie. Diese Prognose rückt KI-generierte Musikvideos in ein anderes Licht: Sie sind nicht nur visuelle Experimente, sondern Produktionsentscheidungen mit Konsequenzen für Künstler, Editoren und Publikum.
Eines davon verantwortungsvoll zu erstellen, erfordert mehr als einen überzeugenden Prompt. Man braucht einen songbasierten Produktionsplan, unabhängig reparierbare Clips, messbare Synchronisationsprüfungen und eine klare Aufschlüsselung dessen, was Menschen und Modelle beigetragen haben.
Inhaltsverzeichnis
- Was ein KI-generiertes Musikvideo tatsächlich ist
- Die vier Phasen vom Song zum fertigen Video
- Modelle, die Prompts und Bilder in Bewegung verwandeln
- Lippensynchronisation und Beat-Ausrichtung prüfen
- Häufige Probleme und wie man sie behebt
- KI-Beteiligung offenlegen, ohne Vertrauen zu verlieren
- Deinen ersten Clip testen, bevor du dich einem ganzen Song widmest
Was ein KI-generiertes Musikvideo tatsächlich ist
Ein KI-generiertes Musikvideo ist ein Musikvideo, dessen visuelle Elemente, Soundtrack oder beides mit generativen Modellen produziert werden, anstatt vollständig aufgenommen oder gefilmt zu werden. Nehmen wir an, Sie haben ein Lied über das Verlassen der Heimat aufgenommen: Sie könnten Zugfenster-Szenen generieren, ein Porträt des Sängers animieren und diese Aufnahmen um Ihre bestehende Aufnahme herum zusammenfügen.
In einer auf die USA fokussierten 2026 Umfrage unter 1,003 Videokünstlern, Musikern, Marketingfachleuten und Musiksupervisoren nutzten 19% generative KI, um Musik für Videos zu finden oder zu erstellen, während 32.7% KI-generierte Musik als endgültiges Audio in veröffentlichten Inhalten verwendet hatten, laut Berklee]. Diese Messungen betreffen Musik innerhalb von Video-Workflows, nicht den Anteil der vollständig von KI generierten Musikvideos.
Drei Wege, wie ein Projekt KI nutzen kann
- Vollständig synthetisch: Sowohl das Lied als auch die bewegten Bilder stammen von generativen Modellen, wobei eine Person die Ergebnisse steuert und auswählt.
- Hybrid: Ein von Menschen aufgenommener Track begleitet generierte Szenen, wie die Zugfenster-Sequenz.
- KI-unterstützt: Sie filmen die Performance und nutzen dann KI für Bearbeitung oder Effekte. Dies ist nicht unbedingt ein KI-generiertes Video im engeren Sinne.
Stellen Sie sich das Lied als Partitur und die Prompts als Shotlist vor, die ein Modell interpretiert. Sie sind immer noch dafür verantwortlich zu entscheiden, was auf dem Bildschirm zu sehen ist.
Text-to-video verwandelt schriftliche Anweisungen in einen Clip. Image-to-video animiert ein bereitgestelltes Standbild. Ein segment ist ein abgegrenzter Teil des Liedes, ein shot prompt steuert dessen Bildmaterial, und der final edit kombiniert das ausgewählte Material.
Bevor Sie Tools auswählen, benennen Sie die Teile Ihres Projekts: Aufnahme, Gesang, Texte, Referenzbilder, generierte Aufnahmen und Bearbeitung. Markieren Sie, welche von Menschen erstellt wurden und welche Sie generieren werden. Dieses einfache Inventar verrät Ihnen, welche Version Sie erstellen.
Die vier Phasen vom Song zum fertigen Video
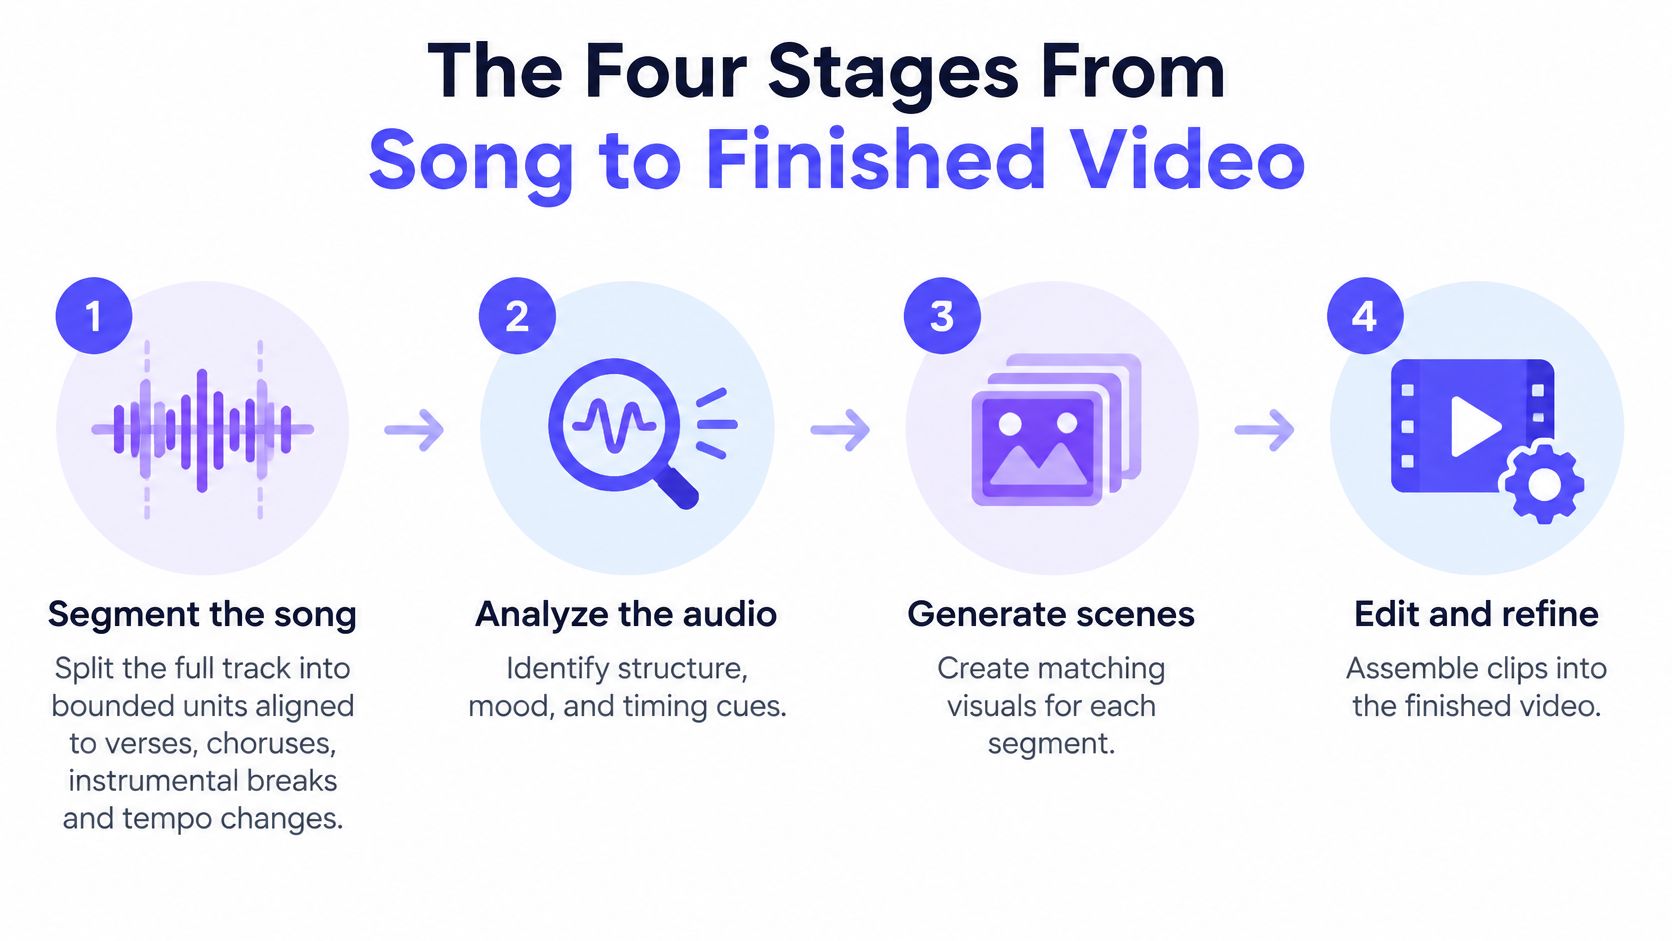
Eine Produktion in Songlänge lässt sich leichter steuern, wenn du sie als Sammlung überschaubarer Aufgaben behandelst. Die veröffentlichte From Sound to Sight-Pipeline folgt dem Ablauf aus Song-Segmentierung, Audioanalyse und Skripterstellung, Text-to-Video-Generierung und finaler Montage.
Der folgende Workflow trennt kreative Entscheidungen von Rendering-Aufgaben.
Baue auf der musikalischen Struktur auf
Segmentiere den Song. Markiere Strophen, Refrains, Instrumental-Breaks und Tempoänderungen und teile sie dann in abgegrenzte Generierungseinheiten auf. Ein musikalischer Abschnitt kann mehrere Shots enthalten, also verwechsle ein Refrain-Label nicht mit der Anforderung, einen durchgehenden Clip zu generieren.
Analysiere das Audio und schreibe das visuelle Skript. Erkenne Tempo, Energie, Gesangspassagen und Stimmungswechsel und weise dann jedem Segment einen Shot-Prompt zu. Für den Song über das Verlassen des Zuhauses könnte eine ruhige Strophe eine statische Bahnsteigszene verwenden, während der Refrain eine Vorwärtsbewegung einführt.
Generiere die Clips. Nutze Text-to-Video für unabhängig beschriebene Szenen oder Image-to-Video, wenn eine bereitgestellte visuelle Referenz wichtig ist. Prüfe jedes Ergebnis anhand seines zugewiesenen Zwecks, bevor du es in den Schnitt übernimmst.
Stelle den finalen Schnitt zusammen. Ordne die freigegebenen Clips in deterministischer Reihenfolge passend zum Master-Track an. Vereinheitliche Bildrate, Auflösung, Seitenverhältnis und finale Lautheit, damit gemischte Ausgaben sich wie eine einzige Produktion verhalten.
Pipeline-Phasen, Eingaben und Ausgaben
| Phase | Eingabe | Ausgabe |
|---|---|---|
| 1. Song segmentieren | Kompletter Track mit Zeitstempeln | Abgegrenzte Segmente mit Timecodes und Labels |
| 2. Audio analysieren und Skript schreiben | Segmente, Tempo, Gesangs-Cues | Ein Shot-Prompt pro Segment |
| 3. Clips generieren | Shot-Prompts, optionale Referenz-Stills | Ein kurzer Clip pro Segment, mit gespeichertem Seed und gespeicherter Modellversion |
| 4. Finalen Schnitt zusammenstellen | Clips und der Original-Track | Ein Render mit konstanter Bildrate und normalisierter Lautheit |
Jedes Segment wiederherstellbar machen
Abgegrenzte Clips helfen, temporal drift zu begrenzen, wobei sich Objekte, Identitäten oder Aktionen ändern, während eine generierte Sequenz weiterläuft. Sie ermöglichen es dir außerdem, einen schwachen Shot zu ersetzen, ohne eine erfolgreiche Sequenz zu verwerfen.
Speichere ein Produktionsmanifest, das für jedes Segment Timecode, Label für Lyrics oder reine Musik, Tempo, Energie, Shot-Prompt, Seed, Modellversion und Ausgabeort enthält. Bewahre Referenzbild-IDs zusammen mit diesem Datensatz auf, sofern zutreffend. Ein Seed hilft, einen Lauf zu dokumentieren, ist aber keine Garantie für identische Ergebnisse über Modell-Updates hinweg.
Produktionsregel: Behandle das Segment-Manifest als dein bearbeitbares Projekt, nicht nur als Protokoll abgeschlossener Downloads.
Für eine praktische Ergänzung zu Planung und Montage bietet AIMVGs Musikvideo-Produktions-Walkthrough eine nützliche Workflow-Referenz. Entwickler, die die Rendering-Schicht implementieren, können den API-Leitfaden zur KI-Videogenerierung nutzen, um diese Segmentdatensätze mit Generierungsaufgaben zu verbinden.
Modelle, die Prompts und Bilder in Bewegung verwandeln
Text-to-video gibt Ihnen Raum zum Erfinden; image-to-video bietet Ihnen einen visuellen Ausgangspunkt. Diese Unterscheidung ist wichtiger, als ein einziges Modell für ein ganzes Lied zu wählen.
Mit Text-to-video beschreiben Sie das Motiv, die Umgebung, die Aktion, die Kamera und die Beleuchtung. Es ist nützlich für Landschaften, symbolische Bilder und Establishing Shots, bei denen ein exakt wiederkehrendes Gesicht nicht wesentlich ist. Unabhängige Generierungen können dieselbe Beschreibung unterschiedlich interpretieren, daher sollte eine alleinige Wiederholung des Wortlauts nicht Ihre Strategie zur Identitätskontrolle sein.
Image-to-video beginnt mit einem Standbild, das Sie bereitstellen. Es kann Kleidung, Komposition und das Aussehen des Gesichts verankern, aber es fixiert nicht jedes spätere Bild. Eine schwierige Bewegung oder ein Kamerawinkel kann immer noch unerwünschte Änderungen hervorrufen.
Passen Sie den Input an die Aufnahme an
Für einen wiederkehrenden Sänger bereiten Sie ein sauberes Referenzbild mit einem unverdeckten Gesicht und lesbarer Kleidung vor. Synchronicity Labs zu image-to-video ist ein nützlicher Begleiter, wenn Sie entscheiden, wie Sie ein Standbild in eine gerichtete Bewegungsaufnahme verwandeln.
Die folgenden Familien bieten Startkandidaten, keine Qualitätsrangliste. Behandeln Sie jede Rolle als etwas, das Sie mit Ihrem eigenen Material testen sollten, und überprüfen Sie die unterstützten Inputs des aktuellen endpoints, bevor Sie sie einreichen.
Modellfamilien nach Input-Modus und Musikvideo-Rolle
| Modell | Input-Modus | Typische Rolle in einem Musikvideo | Achten Sie auf |
|---|---|---|---|
| Kling 3.0 Standard | Text to video oder image to video | Allzweckaufnahmen und ein erster Kandidat | Check clip length limits before planning segments |
| Veo 3.1 Fast | Text to video | Iteration von Stimmung und Establishing Shots | Verify current resolution and audio options |
| Seedance 2.0 | Image to video | Künstler- oder Charakteraufnahmen, die an einem Standbild verankert sind | Benötigt ein sauberes Referenzbild |
| Wan 2.6 | Text to video | Instrumentale und abstrakte Segmente | Inspect motion continuity before accepting |
| PixVerse V5.6 | Text to video | Stylized oder experimental segments | Check that stylization preserves required details |
Trennen Sie Aussehen von Performance
Ein visuell konsistentes Gesicht ist nicht automatisch eine Gesangsperformance. Lip-sync und audio-driven models adressieren die Mundbewegung im Verhältnis zum bereitgestellten Audio; gewöhnliche Bildanimation sollte nicht als Ersatz dafür angenommen werden.
Eine praktische Kombination ist text-to-video für atmosphärische Passagen, image-to-video für wiederkehrende Künstleraufnahmen und ein audio-driven Schritt für sichtbaren Gesang. Sie können auch ganz auf Performance-Nahaufnahmen verzichten, wenn das Konzept besser als Erzählung oder Visualizer funktioniert.
Halten Sie prompts auf beobachtbare Aktionen fokussiert. Der text-to-video prompting guide kann helfen, eine abstrakte Stimmung in Kameraregie und Subjektbewegung zu übersetzen. Clip limits, resolution options und generation time ändern sich zwischen den Veröffentlichungen, wählen Sie das Modell daher nach Segmentanforderungen, nicht nach Markenvertrautheit.
Überprüfung von Lippensynchronisation und Beat-Ausrichtung
Ein schönes Gesicht kann trotzdem die falsche Silbe singen. Visuelle Wiedergabetreue und audiovisuelle Synchronisation sind separate Akzeptanzkriterien: das Lip-Sync-Evaluierungspapier untersucht 615 generierte Clips und verwendet Maße wie Landmark Distance (LMD) und Lip Sync Error–Confidence (LSE-C), um die Mundbewegung und die Audio-Übereinstimmung zu bewerten.
LMD misst den Landmark-Fehler im Mundbereich im Vergleich zur erwarteten Bewegung. LSE-C schätzt die Zuversicht, dass die Lippenbewegung der Sprachspur entspricht. Keines davon sollte als vollständige künstlerische Bewertung behandelt werden, und ein sprachorientiertes Maß erfordert eine sorgfältige Interpretation, wenn es auf anhaltenden Gesang, Hintergrundgesang oder ausdrucksstarke Mundformen angewendet wird.
Führen Sie die Prüfungen der Reihe nach durch
- Takt- und Einsatzzeitstempel extrahieren. Verwenden Sie ein Audioanalyse-Tool, um rhythmische Positionen und Notenanschläge zu identifizieren. Markieren Sie, welche Ereignisse einen Schnitt oder eine Bewegungsakzentuierung erfordern, anstatt jeden Takt in einen Übergang zu zwingen.
- Gesangssegmente markieren. Identifizieren Sie, wo ein sichtbarer Darsteller singen sollte. Verwenden Sie den korrekten Gesangsausschnitt und bewahren Sie dessen Versatz relativ zur Masterspur.
- Jeden Clip bewerten und prüfen. Wenden Sie mundbezogene Maße auf sichtbaren Gesang an und bewerten Sie dann Timing und musikalische Passung. Sehen Sie sich das Video sowohl mit normaler Geschwindigkeit als auch Bild für Bild an.
- Nur fehlgeschlagene Segmente neu generieren. Halten Sie fest, ob der Fehler Timing, Artikulation, Bildqualität oder musikalische Interpretation betrifft, bevor Sie einen Ersatz anfordern.
Synchronisationsprüfungen und wo sie jeweils angewendet werden
| Prüfung | Was gemessen wird | Anwenden auf |
|---|---|---|
| Mund-Landmark-Fehler (LMD) | Abstand der Mundregion-Landmarks von der erwarteten Bewegung | Gesangssegmente |
| Lippensynchronisations-Zuversicht (LSE-C) | Ob die Lippenbewegung der Sprachspur entspricht | Gesangssegmente |
| Takt- oder Einsatz-Ausrichtung | Ob Schnitte und Bewegungsakzente auf musikalischen Ereignissen landen | Jede Segmentgrenze |
| Rhythmus- und Stimmungsübereinstimmung | Ob Bewegungstempo und Ton der Spur folgen | Instrumentalsegmente |
Gates vor dem finalen Render definieren
Es gibt keine universelle Bestehensbewertung für jeden Sänger, Stil oder jedes Modell. Kalibrieren Sie Ihre Gates anhand von Clips, die Sie überprüft und akzeptiert haben, und halten Sie diese Einstellungen dann innerhalb des Projekts konsistent.
- Mundbewegungs-Gate: Sichtbaren Gesang mit inakzeptablem Artikulationsfehler oder schwacher Synchronisationszuversicht ablehnen.
- Timing-Gate: Unbeabsichtigte Fehlschläge bei festgelegten musikalischen Ereignissen ablehnen.
- Bewegungskonsistenz-Gate: Bewegungen ablehnen, die dem beabsichtigten Tempo, der Stimmung oder dem Thema widersprechen.
- Wahrnehmungs-Gate: Ablenkende Gesichtsverzerrungen ablehnen, selbst wenn ein numerischer Wert akzeptabel aussieht.
Angenommen, der Mund des Sängers folgt den richtigen Worten, aber die gesamte Darbietung beginnt zu spät. Korrigieren Sie den Clip-Offset, bevor Sie eine neue Darbietung in Auftrag geben. Wenn das Timing stimmt, der Mund aber andere Töne artikuliert, wird eine Bearbeitung allein das Problem nicht beheben.
Ein bewusster Schnitt vor dem Takt kann funktionieren. Ein versehentlicher Schnitt nach dem beabsichtigten Akzent ist ein Produktionsfehler.
Speichern Sie die Bewertungen und Überprüfungsnotizen zusammen mit der Segmentaufzeichnung. Das gibt Ihnen einen Grund für jede Ablehnung und macht die Auswahl des Ersatzes weniger willkürlich.
Häufige Probleme und wie man sie behebt
Wenn ein Charakter zwischen den Aufnahmen Mantel oder Gesicht wechselt, überprüfen Sie zuerst das Quellmaterial und die Generierungsanweisungen. Versuchen Sie nicht, jede Identitätsabweichung mit einer Überblendung zu verbergen. Entscheiden Sie, ob das Problem zur Referenz, zur generierten Performance oder zur Montage gehört.
Diagnose vor der Neugenerierung
Häufige Produktionsprobleme, Ursachen und Lösungen
| Symptom | Wahrscheinliche Ursache | Lösung |
|---|---|---|
| Charaktere wechseln zwischen Aufnahmen | Prompt-Drift über unabhängige Segmente hinweg | Verwenden Sie Bild-zu-Video mit einem festen Referenzbild pro Charakter |
| Mund nicht synchron mit Gesang | Segment-Timing stimmt nicht mit dem Gesangsstamm überein | Generieren Sie das Segment mit korrigierten Timecodes neu und überprüfen Sie die Lippensynchronisations-Sicherheit erneut |
| Schnitte liegen nicht im Takt | Grenzen nach Augenmaß gesetzt, nicht nach erkannten Einsätzen | Neu schneiden nach Einsatz-Zeitstempeln während der Montage |
| Flimmern oder Morphing in langen Clips | Clip länger als das Modell stabil bleibt | Verwenden Sie kürzere Segmente und fügen Sie sie im Schnitt zusammen |
| Farbe oder Bildrate unterscheiden sich zwischen Clips | Gemischte Ausgabeeinstellungen | Normalisieren Sie Bildrate, Auflösung und Seitenverhältnis bei der Montage; passen Sie die Farbe separat an |
| Ungleichmäßige Lautstärke zwischen Schnitten | Keine Lautstärke-Normalisierung im finalen Mix | Normalisieren Sie die Lautstärke über den gesamten Schnitt |
| Ein Clip ist nach einem Absturz fehlgeschlagen | Gesamtes Projekt neu ausgeführt statt Segmentwiederherstellung | Generieren Sie nur dieses Segment aus seinem gespeicherten Seed und Metadaten neu |
Schnittreparaturen von Designänderungen trennen
Montagereparaturen umfassen das Verschieben eines Schnitts, das Korrigieren eines Offsets, das Anpassen der Farbe oder das Beheben einer Exporteinstellung. Probieren Sie diese aus, bevor Sie für neues Bildmaterial bezahlen. Zuschneiden kann eine Rahmenabweichung beheben, aber überprüfen Sie das Ergebnis sorgfältig, damit Sie nicht die Hände eines Sängers entfernen oder wichtige Aktionen durchschneiden.
Generierungsreparaturen erfordern einen neuen Clip, da der tatsächliche Inhalt falsch ist. Beispiele sind ein sich morphingendes Gesicht, falsche Artikulation oder eine Kamerabewegung, die das Motiv verdeckt. Ändern Sie die spezifische fehlgeschlagene Anweisung, anstatt den gesamten Prompt neu zu schreiben.
Konzeptreparaturen erfordern ein umfassenderes Umdenken. Wenn jede Aufnahme von komplexer Choreografie abhängt, die Ihr gewählter Ansatz nicht bewahren kann, vereinfachen Sie die Performance oder wechseln Sie zu einer narrativen Behandlung.
Für referenzbasierte Arbeiten bietet der Screenshot-zu-Video-Leitfaden einen nützlichen Ausgangspunkt, um ein vorbereitetes Bild in Bewegung zu versetzen. Überprüfen Sie zuerst das Standbild: Eingebettete Unschärfe, verdeckte Gesichter und verwirrende Anatomie sind schlechte Grundlagen für die Animation.
Behalten Sie das Lied als durchgehende Master-Spur bei, es sei denn, Ihr Arrangement ändert sich absichtlich. Versehentliches Clip-Audio kann Lautstärkesprünge verursachen, selbst wenn die Originalaufnahme konsistent ist. Nach einem Absturz stellen Sie abgeschlossene Dateien wieder her und setzen die Arbeit ab dem fehlgeschlagenen Segment fort, anstatt die gesamte Produktion als verloren zu betrachten.
KI-Beteiligung offenlegen, ohne Vertrauen zu verlieren
KI-unterstützt und KI-generiert beschreiben unterschiedliche Beiträge. Eine menschliche Darbietung mit KI-Bereinigung ist nicht dasselbe wie ein synthetischer Sänger, und eine pauschale Bezeichnung kann diesen Unterschied eher verschleiern als klären.
Führen Sie während Ihrer Arbeit Aufzeichnungen über die Aufnahme- und Bearbeitungsbeiträge.
In einem 2025 Experiment mit 120 Teilnehmern erhielt identisches Audio höhere Bewertungen für Sympathie, Engagement, emotionalen Einfluss und Qualität, wenn es einem menschlichen Pianisten zugeschrieben wurde, und 79% gaben an, Unterschiede bemerkt zu haben, laut der audiovisuellen Urheberschaftsstudie. Das ist ein Grund, die Offenlegung sorgfältig zu formulieren, keine Rechtfertigung, wesentliche Beiträge zu verbergen.
Bezeichnen Sie den Beitrag, nicht nur das Projekt
- Musik und Texte: Geben Sie separat an, ob Komposition oder Worte generiert wurden.
- Gesang: Identifizieren Sie eine synthetische Gesangsstimme, anstatt eine aufgenommene menschliche Darbietung zu implizieren.
- Visuelles: Unterscheiden Sie generierte Szenen von gefilmtem Material.
- Bearbeitung: Beschreiben Sie KI-Bereinigung oder -Effekte, ohne zu suggerieren, dass die zugrunde liegende Darbietung synthetisch war.
Für ein Hybridprojekt könnte eine Beschreibung angeben, dass der Künstler das Lied geschrieben und aufgeführt hat, während die visuellen Elemente KI-generiert und von Menschen bearbeitet wurden. Bei einem synthetischen Sänger machen Sie diese Tatsache prominent genug, damit die Zuschauer die Darbietung nicht mit einer Aufnahme der abgebildeten Person verwechseln.
Offenlegungsprinzip: Seien Sie spezifisch darüber, was generiert wurde, und ebenso spezifisch darüber, was Menschen geschaffen haben.
Verwenden Sie den Titel, wenn die synthetische Urheberschaft zentral für die Prämisse ist, die Beschreibung für Beitragsdetails und Credits oder eine Endkarte für den vollständigeren Produktionsnachweis. Befolgen Sie die geltenden Plattformanforderungen, anstatt die Platzierung als reine Marketingentscheidung zu behandeln.
Als zusätzliche Referenz ist das eingebettete Video unten verfügbar.
Testen Sie wahrheitsgemäße Formulierungen anhand von Wiedergabezeit, Abschlussrate, Kommentaren und Zuschauervertrauen, Markt für Markt. Halten Sie die zugrunde liegenden Fakten über alle Tests hinweg unverändert. Eine Bezeichnung, die Klicks verbessert, aber die Zuschauer über den Sänger verwirrt, ist keine erfolgreiche Offenlegung.
Teste deinen ersten Clip, bevor du dich für einen ganzen Song entscheidest
Beginne mit einer Passage, die dein schwierigstes Produktionsproblem aufdecken kann. Ein Refrain mit sichtbarem Gesang und einem klaren rhythmischen Akzent ist informativer als atmosphärische Szenen, wenn das fertige Video von Performance-Nahaufnahmen abhängt.
Führe einen kleinen Abnahmetest durch
Wähle einen repräsentativen Ausschnitt. Du könntest zum Beispiel eine zehn- bis fünfzehnsekündige Refrainpassage testen, vorausgesetzt, der gewählte endpoint unterstützt diese Dauer. Füge sowohl eine Gesangsphrase als auch ein musikalisches Ereignis hinzu, das du hervorheben möchtest.
Wähle den Eingabeansatz. Wir empfehlen Kling 3.0 Standard als erstes Video-Modell für den Start, unter Verwendung von Text-zu-Video oder Bild-zu-Video. Wähle eine referenzbasierte Aufnahme, wenn Wiedererkennbarkeit entscheidend ist.
Schreibe einen fokussierten Shot-Prompt. Gib Subjekt, Aktion, Bildausschnitt, Kamerabewegung und Beleuchtung an. Vermeide es, einen Ortswechsel, Kostümwechsel und eine komplexe Performance im selben Versuch zu kombinieren.
Generiere und verfolge die Aufgabe. Unsere Bild- und Video-Jobs geben eine Aufgabe zurück, die du abfragen kannst, oder du kannst einen webhook einrichten, um deine app zu benachrichtigen, wenn das Ergebnis bereit ist. Verwende in einem Web-Tool die Fortschrittsanzeige, anstatt doppelte Jobs einzureichen, während du wartest.
Wende die Abnahmekontrollen an. Überprüfe sichtbaren Gesang, festgelegte Beat-Akzente, Identität und störende Artefakte. Notiere die Fehlerkategorie, anstatt einen Clip zu akzeptieren, nur weil er beeindruckend aussieht.
Skaliere erst nach der Abnahme. Übertrage die erfolgreiche prompt-Struktur und Referenzauswahl in deinen Segmentplan. Bewahre das Testergebnis als Vergleich für spätere Aufnahmen auf.
Nutze die Oberfläche, um die verfügbaren Steuerelemente zu überprüfen, bevor du eine Generierungsanfrage sendest.
Kosten vor der Skalierung prüfen
Überprüfe die Preisgestaltung und Fehlerrichtlinien vor dem Absenden. Unsere Antwort auf eine Videoanfrage gibt die maximalen Kosten an, bevor die Generierung beginnt; ein fertiggestelltes Video wird zum Endpreis abgerechnet, und fehlgeschlagene Generierungen werden nicht berechnet.
Wenn der Test sowohl die relevante Lippensynchronisationsprüfung als auch deine festgelegten Beat-Prüfungen besteht, fahre mit dem vollständigen Segmentplan fort. Wenn er fehlschlägt, korrigiere zuerst Timing-Fehler und ändere dann das Modell oder das Referenzbild, wenn der generierte Inhalt das Problem ist. Teste erneut, bevor du diese Wahl auf den gesamten Song anwendest.
UberLLM bietet Zugang zu Video-, Bild-, Musik- und Sprachmodellen über eine einheitliche API, sodass du die einzelnen Phasen einer Musikvideo-Pipeline aufbauen kannst, ohne für jeden Anbieter eine andere Integration pflegen zu müssen. Besuche UberLLM, um Modelloptionen zu vergleichen und einen repräsentativen Clip auszuführen, bevor du dich für eine vollständige Songproduktion entscheidest.