KI-Videogenerierungs-API: Jobs, Modelle und Kosten
Erfahren Sie, wie eine KI-Videogenerierungs-API funktioniert, von asynchronen Jobs und Webhooks bis hin zur Modellauswahl, Ausgabeprüfungen und den tatsächlichen Kosten pro nutzbarem Clip.
Ihre Chat-Antwort kommt in 400 Millisekunden zurück, also gehen Sie bei Video auf die gleiche Weise vor: ein POST, warten, die Bytes sammeln. Vier Minuten später läuft die Verbindung ab, der Clip wird trotzdem fertig, und Sie haben für einen Job bezahlt, den niemand abgeholt hat.
Diese Lücke ist der Punkt, an dem die meisten AI-Videogenerierungs-API-Projekte schiefgehen. Die Dokumentation lässt Video wie ein langsameres Chat-Modell aussehen, und Preistabellen drängen Sie dazu, Cents pro Sekunde zu vergleichen, als ob eine Sekunde generiertes Material eine Einheit wäre, die Sie immer behalten können. Der Markt expandiert schnell genug, dass sich der Fehler ausbreitet. Research and Markets bewertete den globalen Markt für AI-Videogeneratoren und -editoren im Jahr 2024 auf USD 623 Millionen und prognostiziert bis 2034 USD 3.51 Milliarden mit einer 18.64% jährlichen Wachstumsrate (Research and Markets, Dezember 2024).
Die nützliche Frage ist nicht, welche API pro Sekunde am günstigsten ist. Es ist, was ein nutzbarer, heruntergeladener, archivierter Clip kostet nach den Fehlern, den Wiederholungsversuchen und dem Modell, das vier Versuche benötigte.
Inhaltsverzeichnis
- Funktionen zur Videogenerierung und Anfragetypen
- Wie ein Videoauftrag von der Einreichung zur Datei gelangt
- Polling oder Webhooks für fertige Videoergebnisse
- Auswahl eines Videomodells nach Anwendungsfall
- Kosten pro nutzbarem Clip im Vergleich zum beworbenen Preis
- Anfragefelder und Ausgabemetadaten zur Überprüfung
- Integration der Videogenerierung in bestehenden SDK-Code
- Produktionsfehler und wie man Duplikate verhindert
- Führen Sie einen Modell-Benchmark durch, bevor Sie sich festlegen
Videogenerierungsfunktionen und Anfragetypen
Eine Chat-Antwort ist eine Nachricht. Ein Video-job ist eine Datei, die später ankommt, und der von Ihnen gewählte Anfragetyp entscheidet, was der Anbieter erfinden muss und was er zurückgibt.
Text zu Video ist die reinste Form. Sie senden einen prompt und einen model identifier, und das Modell generiert jedes Pixel aus der Beschreibung. Bild zu Video fügt ein Referenzbild hinzu, sodass Motiv, Bildausschnitt und Beleuchtung vom Bild stammen, während der prompt die Bewegung liefert. Diese einzige Änderung beseitigt den Großteil der Identitätsverschiebung, die reine Text-clips für Produktaufnahmen und Charakterarbeiten unbrauchbar macht.
| Anfragetyp | Eingabe | Ausführung | Ausgabe |
|---|---|---|---|
| Text zu Video | Text prompt und model identifier | Asynchroner job | Neuer MP4 clip |
| Bild zu Video | Referenzbild und prompt | Asynchroner job | MP4 clip, der am Bild verankert ist |
| Video-Upscaling | Bestehende Videodatei | Asynchroner job | MP4 mit höherer Auflösung |
| Video mit Audio | Prompt plus Audio-Einstellung | Asynchroner job | MP4 mit einer Audiospur, wo das Modell dies unterstützt |
Video-Upscaling ist der einzige Typ, bei dem der Inhalt feststeht und sich nur die Auflösung ändert, daher ist es am einfachsten zu kalkulieren und am schwierigsten, Fehler zu machen. Audio teilt sich in zwei Bereiche auf. Einige Modelle geben einen Soundtrack zusammen mit dem Bild zurück, wenn Sie Audio einschalten, während Musik und Soundeffekte separate Modalitäten sind, die dieselbe request shape und dieselbe job mechanics verwenden.
Drei Eingaben erscheinen in jeder Zeile: der prompt oder die Quellmedien, der model identifier sowie die gewünschte Länge und Auflösung. Integrieren Sie diese drei frühzeitig in Ihr eigenes request schema, und der spätere Wechsel von Anbietern wird zu einer Konfigurationsänderung.
Legen Sie die Zeiterwartung fest, bevor Sie etwas entwickeln. Eine Chat-Antwort kommt in Sekunden an, während eine Video-Anfrage zuerst angenommen und später abgeschlossen wird, wobei ein typischer Durchlauf etwa 30 Sekunden bis mehrere Minuten dauert. Die Antwort, die Sie sofort zurückerhalten, ist ein job, kein clip.
Der Weg eines Video-Jobs von der Einreichung zur Datei
Jede produktionsreife Video-API folgt einem Muster, und es ist das Muster, das OpenAI in seinem Video-API-Leitfaden dokumentiert: einen Job erstellen, seinen Status lesen und dann den Inhalt abrufen, sobald der Status einen terminalen Erfolgszustand erreicht hat. Modellieren Sie diesen Ablauf als asynchrones Job-System, niemals als synchronen Medien-Download.
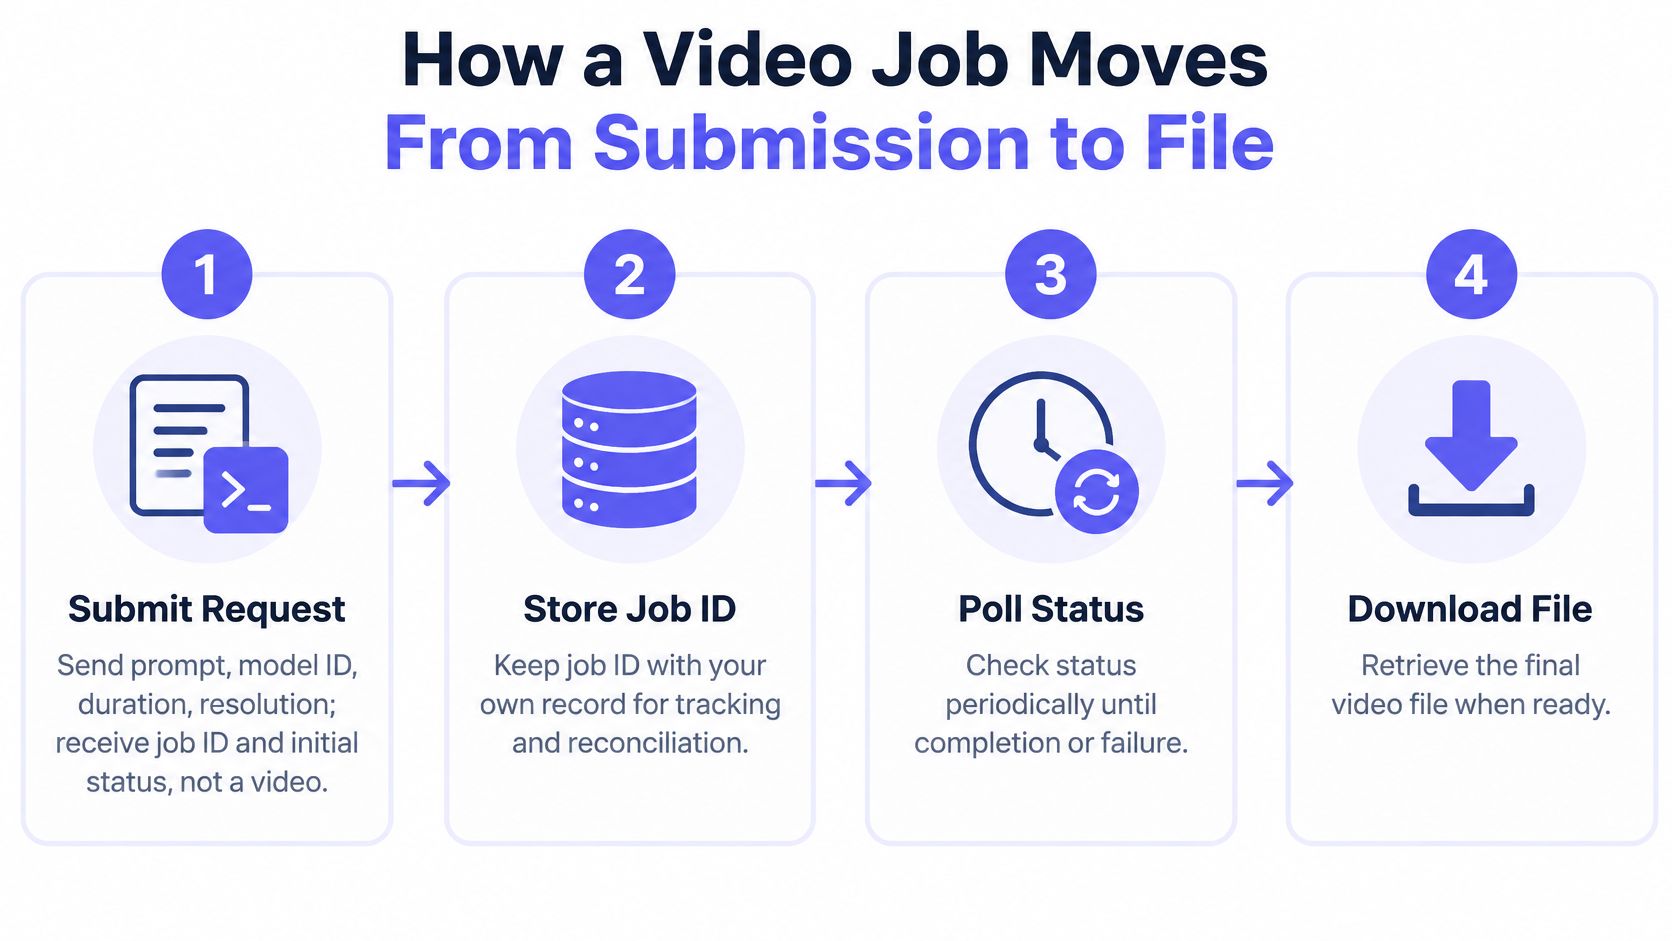
- Anfrage senden. Senden Sie den Prompt, den Modell-Identifier, die Dauer und die Auflösung. Die Antwort enthält eine Job-ID und einen initialen Status wie 'queued'. Speichern Sie diese, bevor Sie etwas anderes tun, da ein Prozessneustart sonst den einzigen Verweis auf bereits bezahlte Arbeit verlieren würde.
- Job-ID Ihrem Datensatz zuordnen. Halten Sie Ihre interne Anfrage-ID, den zugehörigen Benutzer oder Tenant, die gesendeten Parameter und die Verkäufer- oder Anbieterroute fest. Wenn drei Tage später eine Abrechnungsfrage auftaucht, ist diese Zeile die Antwort.
- Status-Ressource überwachen. Pollen Sie sie oder warten Sie auf ein Ereignis und protokollieren Sie jeden Übergang mit einem Zeitstempel. Queued, running, succeeded, failed. Die Lücke zwischen 'queued' und 'running' ist die 'queue wait' (Wartezeit in der Warteschlange), und das ist die Zahl, die Beschwerden über ein "langsames Modell" erklärt, die nichts mit dem Modell zu tun haben.
- Auf einen terminalen Zustand warten. Erfolg und Fehler sind beide terminal. Ein Timeout ist es nicht, und eine unterbrochene Verbindung auch nicht, behandeln Sie also keines von beiden als Ergebnis.
- Datei nur bei Erfolg abrufen. Fordern Sie den Speicherort des Inhalts an, streamen Sie ihn in Ihren eigenen Speicher und protokollieren Sie die Prüfsumme. Dies im Fehlerfall zu tun, verschwendet Aufrufe und kann einen echten Fehler als Download-Problem verschleiern.
- Fehler im Fehlerfall lesen. Entscheiden Sie, ob die Lösung ein geänderter Parameter, ein anderes Modell oder eine Nachricht an den Benutzer ist. Das erneute Senden identischer Parameter nach einer Inhaltsablehnung verbrennt nur Geld.
Wie gesunde Job-Logs aussehen
Eine Job-ID, ein sauberer Durchlauf von 'queued' über 'running' zu 'succeeded' und genau ein Download. Alles andere im Log ist ein messbarer Fehler: zwei Downloads bedeuten einen doppelten Webhook, den Sie nicht dedupliziert haben, und ein Erfolg, der nach dem Aufgeben Ihres Clients protokolliert wurde, bedeutet, dass Sie eine Abstimmung benötigen.
Definieren Sie 'cancellation', 'timeout', 'retry' und 'expiration' in Ihrem eigenen Job-Datensatz. Diese Semantik gehört zu Ihrem Gateway, nicht zu dem Upstream, der den Clip gerendert hat. Wenn der Anrufer während des Renderns die Verbindung trennt, lassen Sie den Job beenden und gleichen Sie ihn später ab. 'Cancellation' ist eine explizite Statusänderung, die Sie senden, keine HTTP-Verbindung, die zufällig geschlossen wird.
Polling oder Webhooks für fertige Videoergebnisse
Beide Signale beantworten dieselbe Frage, und sie unterscheiden sich darin, wer die Initiative ergreift. Polling bedeutet, dass Ihr Code wiederholt den Status der Ressource abfragt, bis der Job einen Endzustand erreicht. Webhooks bedeuten, dass der Anbieter Sie mit einem abgeschlossenen oder fehlgeschlagenen Ereignis aufruft und Ihr Endpoint reagiert.
| Frage | Polling | Webhooks |
|---|---|---|
| Wie Sie das Ergebnis erfahren | Wiederholtes Abfragen des Status bis zum Endzustand | Ein abgeschlossenes oder fehlgeschlagenes Ereignis |
| Wann Sie es bemerken | Beim nächsten Intervall | Wenn das Ereignis zugestellt wird |
| Zusätzliche Last | Ein Status-Abruf pro Intervall | Fast keine, plus ein seltener Abgleich |
| Am besten geeignet für | Batch-Rendering und einen einfachen ersten Build | Langlaufende, ereignisgesteuerte Generierung |
| Hauptfehler | Erkennung wartet auf das Intervall | Verpasste oder doppelte Zustellung |
| Sicherheitskontrolle | Backoff von etwa 15 Sekunden auf 60 Sekunden | Signatur verifizieren, nach Job ID persistieren, Zustellung als at-least-once behandeln, wiederholten Download und Abrechnung überspringen |
Für Generierungen, die in Minuten gemessen werden, gewinnen Ereignisse sowohl bei Kosten als auch bei Latenz. Das Anfragevolumen durch das Polling jedes Jobs alle paar Sekunden summiert sich über eine Warteschlange, und derselbe Traffic verzögert Ihre Erkennung bis zum nächsten Intervall. Der Vergleich von Webhooks mit direktem API-Polling zeigt auf, wo jedes Muster passt.
Erstellen Sie den Handler mit fünf Prüfungen in dieser Reihenfolge:
- Verifizieren Sie die Signatur, wenn der Anbieter eine bereitstellt, und lehnen Sie unsignierte Zustellungen am Edge ab.
- Persistieren Sie das Ereignis anhand der Provider Job ID, bevor ein Download, eine Abrechnung oder Benachrichtigungsarbeit ausgeführt wird.
- Gehen Sie von einer at-least-once Zustellung aus, da dasselbe abgeschlossene Ereignis legitim zweimal ankommen kann.
- Machen Sie den Handler idempotent, sodass eine zweite Zustellung einen gespeicherten Endzustand sieht und den Download und die Gebühr überspringt.
- Behandeln Sie das fehlgeschlagene Ereignis als echtes Ergebnis, nicht als Timeout, das blind wiederholt werden soll.
Fügen Sie dann das Sicherheitsnetz hinzu. Wenn kein Ereignis bis zu einer Frist eintrifft, die aus Ihrer gemessenen Latenz abgeleitet wurde, fragen Sie die Job ID mit Backoff ab, beginnend bei etwa 15 Sekunden und sich auf 60 Sekunden erstreckend. Testen Sie beide Fehlerpfade vor dem Start: erzwingen Sie ein doppeltes Ereignis, unterdrücken Sie dann ein Ereignis vollständig, und bestätigen Sie, dass der Benutzer am Ende ein Video und eine Gebühr erhält.
Praktische Regel: ein Webhook ist eine Optimierung für den Happy Path. Ihr Abgleichs-Polling ist das, was das System korrekt macht.
Ein Videomodell nach Anwendungsfall auswählen
Erstellen Sie eine engere Auswahl von Kandidaten anhand von fünf Kriterien, bevor Sie sich eine Bestenliste ansehen: die benötigte Modalität, die maximale Dauer und Auflösung, Audio-Unterstützung, die gemessene Generierungszeit und die Abrechnungseinheit des Anbieters. Diese fünf Kriterien eliminieren die meisten Optionen schneller als jedes Qualitätsranking.
| Modellfamilie | Modalität | Abrechnungseinheit zum Vergleich | Bekannte Zeit oder Preis |
|---|---|---|---|
| Kling 3.0 Standard | Text und Bild zu Video | Pro Sekunde | Etwa 80 Sekunden für einen 5-Sekunden-Clip |
| Veo 3.1 Fast | Text zu Video | Pro Sekunde bei 1080p ohne Ton | Messen Sie die Latenz in Ihrem eigenen Test, da die Warteschlangenlast sie beeinflusst |
| Veo 3.1 Full | Text zu Video | Pro Auftrag | $0.22 pro Auftrag gegenüber einem Listenpreis von $0.44 |
| Seedance 2.0 Fast | Bild zu Video bei 480p, 5 Sekunden | Pro Clip | $0.35 pro Clip gegenüber einem Konkurrenzangebot von $0.29 |
| LTX 2.3 | Text zu Video bei 1080p | Pro Sekunde | $0.06 pro Sekunde bei 1080p |
| Wan 2.6 | Text zu Video | Pro Auftrag | $0.16 pro Auftrag |
Die Abrechnungseinheit ist genauso wichtig wie die Zahl. Ein Preis pro Sekunde eignet sich für Clips variabler Länge und bestraft lange Clips, während ein Preis pro Auftrag einen Clip fester Länge vorhersehbar macht und einen längeren Clip kostenlos macht. Vergleichen Sie zwei Modelle mit der gleichen Dauer und Auflösung, sonst ist der Vergleich bedeutungslos.
Die Generierungszeit entscheidet, ob Sie das Modell einer Person präsentieren können. Ein 5-Sekunden-Kling 3.0-Clip dauerte in einem Test auf 29. Oktober 2026 etwa 80 Sekunden, was für einen kurzen Clip respektabel ist und sich nicht hinter einem Spinner ohne Fortschrittsanzeige verstecken lässt. Ein 5-Sekunden-Clip, der 80 Sekunden dauert, benötigt einen sichtbaren Status, eine geschätzte Wartezeit und eine Möglichkeit, die Seite zu verlassen und zurückzukehren.
Beschränken Sie sich auf zwei oder drei Modelle in dieser Reihenfolge: zuerst die Modalität, dann Auflösung und Audio, dann die Geschwindigkeit und Abrechnungseinheit, mit der Sie leben können. Behalten Sie mindestens eine Ausweichoption in der engeren Auswahl, auch nachdem Sie eine Standardoption gewählt haben. Ein Modell, das zu Ihrem visuellen Stil passt, kann immer noch zu langsam für Ihre Benutzeroberfläche sein, und Sie möchten die Alternative bereits getestet haben, wenn das auftaucht. Die vollständige Liste der über einen endpoint verfügbaren KI-Modelle] ist ein vernünftiger Ausgangspunkt für die engere Auswahl, anstatt neun Anbieterkonten zu eröffnen.
Kosten pro nutzbarem Clip gegenüber beworbenem Preis
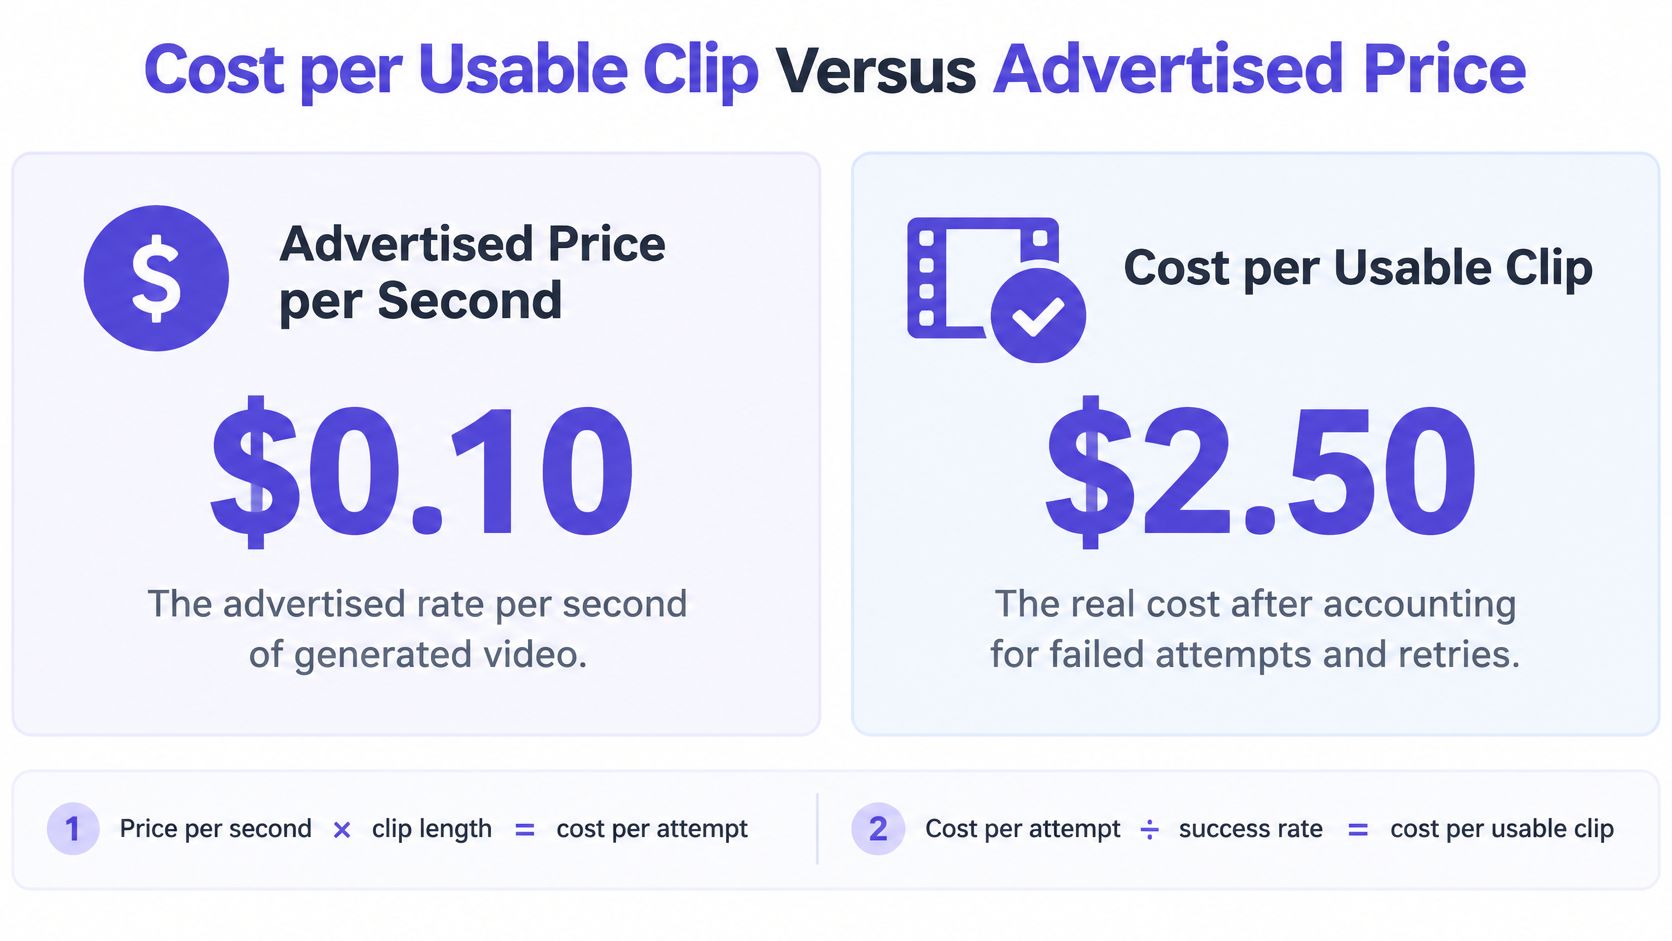
Der beworbene Preis pro Sekunde sagt Ihnen, was ein Versuch kostet. Er sagt nichts darüber aus, was ein nutzbarer Clip kostet, und das ist die Zahl, die Ihr Finanzteam interessiert.
Rechnen Sie es an einem konkreten Beispiel durch. Bei $0.10 pro Sekunde kostet ein 5-sekündiger Clip $0.50 pro Versuch. Wenn einer von vier Versuchen Ihre Qualitätsanforderungen erfüllt, kostet der akzeptierte Clip $2.00. Ein Konkurrent bei $0.07 pro Sekunde kostet $0.35 pro Versuch, und wenn einer von zwei Versuchen nutzbar ist, kostet der akzeptierte Clip $0.70. Das günstiger aussehende Modell gewinnt um fast das Dreifache, und die Pro-Sekunden-Tabelle zeigte die umgekehrte Rangfolge.
Was die Preistabellen weglassen
Veröffentlichte Preise liegen laut Runway's Preisvergleich für AI-Video-APIs] ungefähr zwischen $0.02 und $1 pro generierter Sekunde, und diese Spanne wird gemessen, bevor die Kosten berücksichtigt werden, die über reale Budgets entscheiden. Dieselbe Analyse weist darauf hin, dass ein günstigeres Modell am Ende teurer sein kann, wenn es vier Versuche statt nur einen benötigt. Fügen Sie diese zu Ihrem Modell hinzu:
- Fehlgeschlagene und moderierte Aufträge. Eine Ablehnung verbraucht eine Anfrage und liefert nichts Verwendbares, daher gehört sie in den Nenner Ihrer Erfolgsquote, nicht außerhalb davon.
- Von Ihnen gewählte Wiederholungen. Jede erneute Einreichung ist ein weiterer Versuchskostenpunkt, weshalb die Anzahl der Versuche in die Formel gehört und nicht in eine separate Anmerkung.
- Einstellungen, die den Preis beeinflussen. Auflösung und Audio ändern den Preis pro Sekunde, daher nennt ein Benchmark-Lauf mit Standardeinstellungen einen Preis, den Sie möglicherweise nie zahlen.
- Standarddauern, die Sie nicht festgelegt haben. Eine Standardeinstellung des Anbieters von 8 Sekunden, wenn Sie 5 wollten, erhöht die Kosten pro Clip um 60%.
- Speicherung und erneutes Hosting. Ein Ergebnislink ist temporär. Das Kopieren der Datei in Ihren eigenen Bucket ist Teil der Kosten für den akzeptierten Clip.
Abrechnungsregeln prägen auch die Berechnung. Ein Video wird zu seinem Endpreis abgerechnet, sobald die Generierung abgeschlossen ist, und die Antwort auf eine Anfrage gibt den Höchstbetrag an, den der Auftrag kosten kann, bevor das Video beginnt, was es Ihnen ermöglicht, ein Budgetlimit pro Auftrag und pro Mandanten festzulegen. Diese beiden Regeln verwandeln eine vage monatliche Schätzung in eine pro-Anfrage-Obergrenze, die Sie im Code durchsetzen können.
Definieren Sie die Akzeptanz eng. Ein Auftrag, der Erfolg meldet, ist kein nutzbarer Clip. Zählen Sie ihn nur, wenn er die Prompt-Adhärenz besteht, zeitliche Konsistenz aufweist, die Subjektidentität beibehält und keine offensichtlichen Bewegungs- oder Physikfehler zeigt. Für eine vollständigere Aufschlüsselung, wie sich die Pro-Sekunden- und Pro-Auftrag-Preise über verschiedene Routen vergleichen lassen, behandelt der Leitfaden zu wie AI-Preismodelle funktionieren] die Abrechnungseinheiten.
Ein Status von Erfolg bedeutet, dass das Rendering abgeschlossen ist. Es bedeutet nicht, dass der Clip versandwürdig ist, und nur der zweite geht in den Zähler.
Anfragefelder und Ausgabe-Metadaten zur Prüfung
Eine Videoanfrage enthält mehr als nur einen Prompt. Jedes Feld wählt entweder die Route, beeinflusst den Preis oder entscheidet, ob ein gutes Ergebnis später reproduziert werden kann. Senden Sie diese sieben:
- Der Modell-Identifikator, der die Provider-Route auswählt. Identifikatoren haben eine Struktur, sodass
fal-ai/kling-video/v3/standard/text-to-videoProvider, Familie, Version, Stufe und Modalität in einem String kodiert. Bewahren Sie ihn in der Konfiguration auf, niemals fest in der Anfragelogik kodiert. - Der Prompt, und für Bild-zu-Video das Referenzbild oder dessen hochgeladener Speicherort.
- Die Dauer in Sekunden, da Preis und Generierungszeit beide damit skalieren.
- Auflösung und Seitenverhältnis, da beides in den Pro-Sekunden-Tarif einfließt.
- Die Audio-Einstellung, sofern das Modell Audio unterstützt.
- Ein Seed, wenn das Modell einen akzeptiert, damit ein gutes Ergebnis reproduziert werden kann.
- Ihre eigene Anfrage-ID, damit der Job des Providers auf Ihren Datensatz zurückgeführt werden kann.
Ausgabefelder, die bei jeder abgeschlossenen Aufgabe zu speichern sind
Containerformat, Video-Codec, Abmessungen, Bildrate, Dauer, Audio-Präsenz und -Codec, Bitrate (falls verfügbar), Dateigröße und eine dauerhafte Inhalts-URL oder Objekt-ID. Speichern Sie die Metadaten neben der Datei, denn die Datei allein wird Ihnen im nächsten Quartal nicht verraten, welche Einstellungen sie erzeugt haben.
Erfassen Sie diese Metadaten, anstatt davon auszugehen, dass jedes Ergebnis gleichwertig ist. Zwei Clips mit der gleichen Dauer können in verschiedenen Codecs, mit unterschiedlichen Bitraten, mit oder ohne Audiospur ankommen. Die W3C WebCodecs Spezifikation definiert die Schnittstellen für die Kodierung und Dekodierung von Audio und Video, ohne einen Codec oder eine Kodierungsmethode vorzuschreiben, sodass nichts garantiert, dass zwei Renderings im selben Format zurückkommen.
Liefern Sie ein konservatives MP4-Profil für Browser und Apps und bewahren Sie die provider-eigene Datei auf, wenn die Qualität für eine spätere Bearbeitung wichtig ist. Validieren Sie dann vor dem Erfolg. Überprüfen Sie die dekodierte Dauer und die Bildanzahl anhand der Anfrage, denn eine Datei mit falscher Länge ist ein Fehler, selbst wenn die API Erfolg meldet. Ein 4-Sekunden-Clip, bei dem Sie 5 angefordert haben, unterbricht eine Timeline genauso stark wie ein fehlgeschlagener Job, und es ist weitaus schwieriger zu bemerken.
Video-Generierung in bestehenden SDK-Code integrieren
Eine bestehende Textintegration lässt sich ohne Neuschreiben anpassen. Halten Sie Text und Video auf separaten Routen, damit beide einen API key, eine base URL und ein Guthaben teilen können, und lassen Sie den SDK wrapper unverändert. Das Verschieben eines OpenAI- oder Anthropic-kompatiblen Clients ist eine Änderung des endpoint und der Anmeldeinformationen, und das Wechseln von Modellen ist eine Änderung des Identifikators.
Vier Teile eines schlanken Videodienstes
Eine Erstellungsfunktion validiert die Eingabe, ruft die Generierungsroute auf und gibt sofort Ihre eigene interne job ID zurück. Ihre Aufrufer sehen niemals eine provider ID, was einen späteren Failover für sie unsichtbar macht.
Eine Job-Tabelle ordnet interne IDs provider job IDs, Status, Route, Zeitstempeln und Ausgabe-Metadaten zu. Behandeln Sie sie als die Quelle der Wahrheit für die Rechnungsabstimmung, nicht als das Dashboard des Anbieters.
Ein Worker fragt ab oder empfängt webhooks, treibt die Zustandsmaschine voran und wendet die von Ihnen definierten Wiederholungs- und Fristregeln an. Ein Worker verarbeitet beide Signale, sodass ein verpasstes Ereignis und eine langsame Abfrage auf demselben code path zusammenlaufen.
Ein Speicherschritt kopiert die fertige MP4 in Ihren eigenen bucket, berechnet eine Prüfsumme und schreibt die Metadatenzeile. Dies ist der Schritt, den Teams überspringen und dann nach ihrem ersten abgelaufenen Link neu aufbauen.
Beschränken Sie jeden API key auf eine Umgebung und halten Sie Schlüssel widerrufbar, damit ein durchgesickerter Staging-Schlüssel keine Produktionskapazität erreichen kann. Für große Quellbilder oder Videodateien laden Sie diese über eine signed URL hoch, anstatt Bytes in den request body einzubetten, da eine Multi-Megabyte-JSON payload ein eigener Fehlerfall ist.
Führen Sie dann den Test durch, nach dem ein Senior Engineer fragen wird. Senden Sie eine Anfrage, die auf dem Client ein timeout verursacht, und bestätigen Sie, dass das System mit genau einer gespeicherten Aufgabe, einem eventuellen Download und keiner doppelten Übermittlung endet. Wenn dieser Test bestanden wird, ist der Rest der Integration Detail.
Produktionsfehler und wie man Duplikate verhindert
Eine Generierungs-API ist kein Funktionsaufruf, und sie als solchen zu behandeln, ist die Ursache für Duplikate. Bei einer synchronen Text-API bedeutet ein Timeout fast immer, dass die Arbeit nie stattgefunden hat. Bei Video bedeutet ein Timeout nur, dass Sie aufgehört haben zuzuhören. Der Job kann immer noch in der Warteschlange sein, immer noch laufen und Ihnen im Moment seiner Fertigstellung immer noch zum Endpreis in Rechnung gestellt werden. Das Bild unten zeigt die operative Version dieser Idee: eine Pipeline, die sich selbst repariert, mit jemandem, der sie besitzt, anstatt einer Warteschlange, die niemand überwacht.
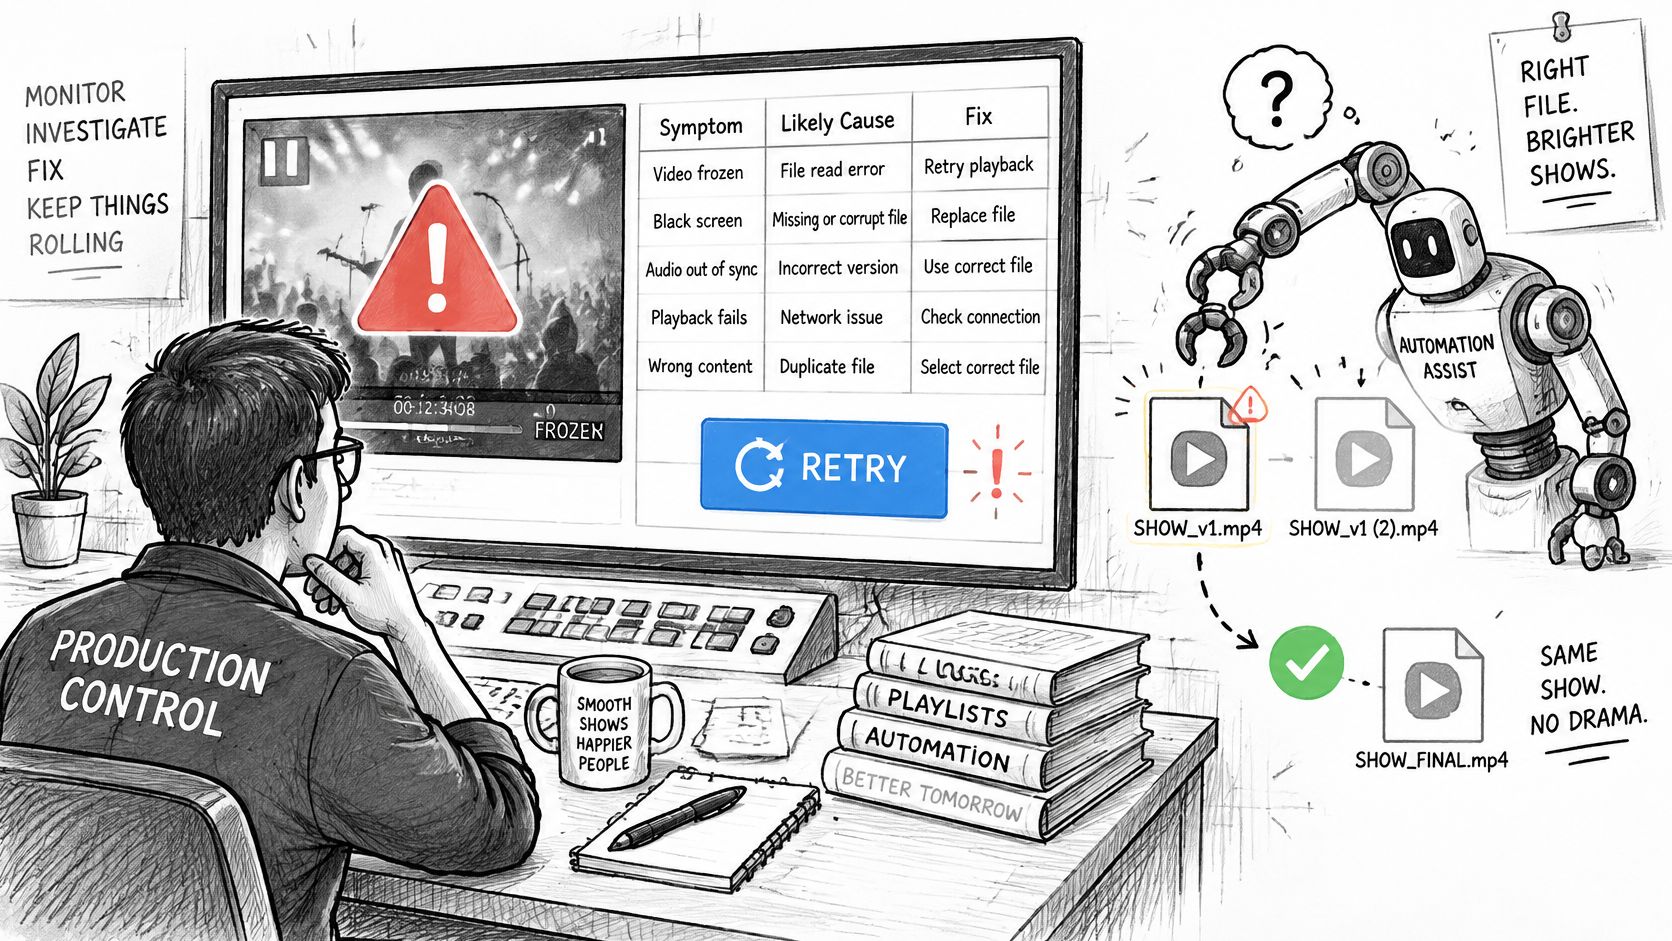
Sieben Symptome sind für die meisten Videointegrationsfehler verantwortlich, und jedes lässt sich einer Ursache und einer Lösung zuordnen.
| Symptom | Wahrscheinliche Ursache | Lösung |
|---|---|---|
| Webhook kommt nie an | Zustellfehler oder Endpoint-Timeout | Job-ID nach einer Frist abfragen und den Status abgleichen |
| Derselbe Clip zweimal erstellt oder abgerechnet | Wiederholung einer nicht-idempotenten Generierung | Einen idempotency key pro Benutzeranfrage senden und die gespeicherte Job-ID wiederverwenden |
| Job meldet Erfolg, aber Datei hat falsche Länge | Output-Validierung übersprungen | Dekodierte Dauer und Frame-Anzahl prüfen, bevor Erfolg markiert wird |
| Moderationsablehnung sieht aus wie ein generischer Fehler | Sicherheitsfilter hat den Job gestoppt | Fehlercode lesen, prompt ändern, dieselbe Eingabe nicht wiederholen |
| Download schlägt Stunden später fehl | Ergebnis-URL ist abgelaufen | Sofort herunterladen, Datei mit einem Checksum speichern und archivieren |
| Output-Stil ändert sich nach Failover | Ein anderes model oder Anbieter hat den Job bedient | Das model für passende Clips festlegen und Failover nur zwischen getesteten Äquivalenten zulassen |
| Viele Anfragen erscheinen langsam | Rate limit oder Warteschlangenwartezeit | Warteschlangenzeit separat von Generierungszeit verfolgen und pro-Job-Fristen setzen |
Warum automatisches Failover Sie Geld kosten kann
Failover ist eine Textgewohnheit, die sich nicht sauber auf Video übertragen lässt. An einem Chat-Endpoint ist das Wiederholen einer zeitüberschreitenden Anfrage günstig, und die Antwort ist in jedem Fall identisch. An einem Video-Endpoint ist jede erneute Übermittlung ein neuer kostenpflichtiger Job, der pro Sekunde Output berechnet wird, und eine Umleitung zu einem anderen model kann Bewegung, Identitätskonsistenz, Sicherheitsergebnisse oder Clip-Dauer ändern. Vergleichende Berichte über die besten KI-Video-Generierungs-APIs nennen Concurrency limits, Rate limits, queue behaviour und slow outliers als die großen Unterschiede zwischen Anbietern, und die durchschnittliche Latenz verbirgt genau die Tail-Delays, die interaktive Produkte zerstören.
Behandeln Sie Wiederholungen und Failover daher als Kosten- und Konsistenzrisiken, nicht als kostenlose Sicherheitsnetze. Jede doppelte Übermittlung erhöht Ihre Kosten pro akzeptiertem Clip, ohne die Akzeptanz zu erhöhen. Legen Sie das model für jede Reihe von Clips fest, die übereinstimmen müssen, und erlauben Sie Failover nur zwischen models, die Sie mit Ihren eigenen prompts als äquivalent getestet haben. Behandeln Sie eine Moderationsablehnung als Ergebnis und nicht als vorübergehenden Fehler: Lesen Sie den code, ändern Sie den prompt und senden Sie dieselbe Eingabe nicht automatisch erneut.
Der Fehlermodus, der erfahrene Teams überrascht, ist subtiler: Ein Job kann erfolgreich abgeschlossen werden, nachdem Ihre Client-Anfrage bereits ein Timeout hatte. Wenn Sie erneut senden, anstatt den gespeicherten Job abzugleichen, zahlen Sie zweimal für denselben Clip. Ergebnis-Links sind ebenfalls temporär und können ablaufen, laden Sie die fertige Datei also sofort herunter, speichern Sie sie mit einem Checksum und schreiben Sie die Archivzeile. Dieser Schritt ist eine Kontrolle, keine Hausarbeit. UberLLM bewahrt Ergebnisdateien für etwa 3 Stunden auf, nachdem ein Video- oder Musik-Job abgeschlossen ist, was lang genug für eine Retry-Schleife ist, aber bei weitem nicht lang genug, um Ihren eigenen bucket zu ersetzen.
Die Exactly-once-Abrechnung setzt sich aus Teilen zusammen, von denen jeder für sich klein ist: ein idempotency key pro Benutzeranfrage, dauerhafter Task-Status, verifizierte webhooks, Abgleich-Polling nach einer Frist, Checksums auf abgeschlossenen Medien und unveränderliche Archivierung jeder fertigen Datei. Überspringen Sie einen davon, und irgendein Edge Case wird irgendwann die Lücke finden.
Die Tag-Eins-Regel: Jeder Video-Job muss einen gespeicherten Status haben, den Sie abgleichen können, ohne die Arbeit erneut zu berechnen oder einzureichen. Wenn Sie aus Ihrer eigenen Datenbank nicht beantworten können, "was dieser Job gekostet hat und ob wir ihn geliefert haben", ist die Integration nicht abgeschlossen.
Führen Sie einen Modell-Benchmark durch, bevor Sie sich festlegen
Sie können die Modellwahl mit einem Test klären, der in einen Nachmittag passt. Wählen Sie einen Standard und einen Herausforderer mit einer anderen Kosteneinheit oder einem anderen Geschwindigkeitsprofil. Kling 3.0 Standard ist ein praktischer erster Standard für Text-zu-Video und Bild-zu-Video, und Veo 3.1 Fast ist ein nützlicher Kosten-Herausforderer. Dann:
- Verwenden Sie die festen Prompts, Dauer, Auflösung, Audioeinstellung und Akzeptanzregel aus Ihrem Kostenmodell wieder. Identische Eingaben sind die einzige Möglichkeit, wie ein Vergleich aussagekräftig ist.
- Führen Sie mindestens 10 Jobs pro Modell aus, genug, um eine Fehlerrate zu sehen, anstatt eines Glückstreffers.
- Ermitteln Sie nur vier Zahlen: Erfolgsrate, mediane Latenz, Tail-Latenz und Kosten pro akzeptiertem Clip.
- Überprüfen Sie den Tarif auf der Route, die Sie aufrufen werden. Für dasselbe Text-zu-Video-Profil bei 1080p ohne Ton kostet Veo 3.1 Fast $0.075 pro Sekunde auf UberLLM gegenüber $0.10 pro Sekunde auf fal.ai, und Lücken dieser Größe ändern, welches Modell gewinnt.
- Halten Sie die Infrastruktur getrennt: Videoanfragen gehen an
/v1/video/generationsund Chatanfragen bleiben auf/v1/chat/completions, selbst wenn ein API key und eine base URL beides abdecken.
Das Wechseln des Kandidaten ist eine Änderung des Modell-Identifikators, sodass der Benchmark Sie Prompts und Zeit kostet, nicht eine Migration. Wählen Sie die Route mit den niedrigsten Kosten pro akzeptiertem Clip, die immer noch Ihre Latenz- und Qualitätsanforderungen erfüllt, fixieren Sie sie für jede Serie, die übereinstimmen muss, und führen Sie denselben 10-Job-Set jeden Monat erneut aus, wenn sich Preise und Warteschlangenbedingungen ändern.
UberLLM leitet die Videogenerierung über verschiedene Anbieter hinter einem OpenAI- und Anthropic-kompatiblen Endpoint, sodass Sie einen Job einmal einreichen und das Gateway den Anbieter, die Job ID und den Callback-Vertrag handhaben lassen können. Text-zu-Video-, Bild-zu-Video- und Upscaling-Modelle befinden sich neben Ihren Chat-Modellen auf demselben Key und Prepaid-Guthaben, und fehlgeschlagene Generierungen werden nicht berechnet. Richten Sie Ihren nächsten Video-Benchmark auf UberLLM und vergleichen Sie die Kosten pro akzeptiertem Clip anstatt die Kosten pro Sekunde.