API de génération de vidéos IA : Tâches, modèles et coûts
Découvrez comment fonctionne une API de génération de vidéos IA, des tâches asynchrones et des webhooks au choix du modèle, aux vérifications de sortie et au coût réel par clip utilisable.
Votre complétion de chat revient en 400 millisecondes, alors vous traitez la vidéo de la même manière : un POST, attendez, collectez les octets. Quatre minutes plus tard, la connexion expire, le clip se termine quand même, et vous avez payé pour un travail que personne n'a récupéré.
C'est dans cet écart que la plupart des projets d'API de génération de vidéo par IA échouent. La documentation fait ressembler la vidéo à un modèle de chat plus lent, et les tableaux de prix vous incitent à comparer des centimes par seconde comme si une seconde de métrage généré était une unité que vous pouviez toujours conserver. Le marché se développe assez rapidement pour que l'erreur s'amplifie. Research and Markets a évalué le marché mondial des générateurs et éditeurs de vidéo par IA à USD 623 millions en 2024 et prévoit USD 3.51 milliards d'ici 2034 avec un taux de croissance annuel composé de 18.64% (Research and Markets, décembre 2024).
La question utile n'est pas de savoir quelle API est la moins chère par seconde. C'est ce que coûte un clip utilisable, téléchargé et archivé après les échecs, les tentatives répétées et le modèle qui a nécessité quatre essais.
Table des matières
- Capacités de génération vidéo et types de requêtes
- Comment un travail vidéo passe de la soumission au fichier
- Interrogation (Polling) ou Webhooks pour les résultats vidéo finis
- Choisir un modèle vidéo par cas d'utilisation
- Coût par clip utilisable versus prix annoncé
- Champs de requête et métadonnées de sortie à vérifier
- Intégrer la génération vidéo dans le code SDK existant
- Échecs de production et comment prévenir les doublons
- Exécuter un benchmark de modèle avant de vous engager
Capacités de génération vidéo et types de requêtes
Une réponse de chat est un message. Un travail vidéo est un fichier livré ultérieurement, et le type de requête que vous choisissez détermine ce que le fournisseur doit créer et ce qu'il vous renvoie.
Texte vers vidéo est la forme la plus pure. Vous envoyez un prompt et un identifiant de modèle, et le modèle génère chaque pixel à partir de la description. Image vers vidéo ajoute une image de référence, de sorte que le sujet, le cadrage et l'éclairage proviennent de l'image tandis que le prompt fournit le mouvement. Ce seul changement élimine la majeure partie de la dérive d'identité qui rend les clips textuels inutilisables pour les prises de vue de produits et le travail de personnages.
| Type de requête | Entrée | Exécution | Sortie |
|---|---|---|---|
| Texte vers vidéo | Prompt textuel et identifiant de modèle | Tâche asynchrone | Nouveau clip MP4 |
| Image vers vidéo | Image de référence et prompt | Tâche asynchrone | Clip MP4 ancré à l'image |
| Mise à l'échelle vidéo | Fichier vidéo existant | Tâche asynchrone | MP4 en plus haute résolution |
| Vidéo avec audio | Prompt plus réglage audio | Tâche asynchrone | MP4 avec une piste audio là où le modèle le prend en charge |
La mise à l'échelle vidéo est le seul type où le contenu est fixe et seule la résolution change, il est donc le plus facile à estimer et le plus difficile à rater. L'audio se divise en deux. Certains modèles renvoient une bande-son avec l'image lorsque vous activez l'audio, tandis que la musique et les effets sonores sont des modalités distinctes utilisant la même forme de requête et les mêmes mécanismes de travail.
Trois entrées apparaissent dans chaque ligne : le prompt ou le média source, l'identifiant du modèle, et la durée et la résolution que vous souhaitez. Intégrez ces trois éléments dans votre propre schéma de requête dès le début et le changement de fournisseur deviendra plus tard un simple changement de configuration.
Définissez les attentes de délai avant de construire quoi que ce soit. Une réponse de chat arrive en quelques secondes, tandis qu'une requête vidéo est d'abord acceptée et se termine plus tard, avec une exécution typique prenant environ 30 secondes à plusieurs minutes. La réponse que vous recevez immédiatement est un travail, pas un clip.
Comment une tâche vidéo passe de la soumission au fichier
Chaque API vidéo prête pour la production suit un modèle, et c'est le modèle qu'OpenAI documente dans son guide de l'API vidéo : créer une tâche, lire son statut, puis récupérer le contenu une fois que le statut atteint un état de succès terminal. Modélisez ce flux comme un système de tâches asynchrones, jamais comme un téléchargement de média synchrone.
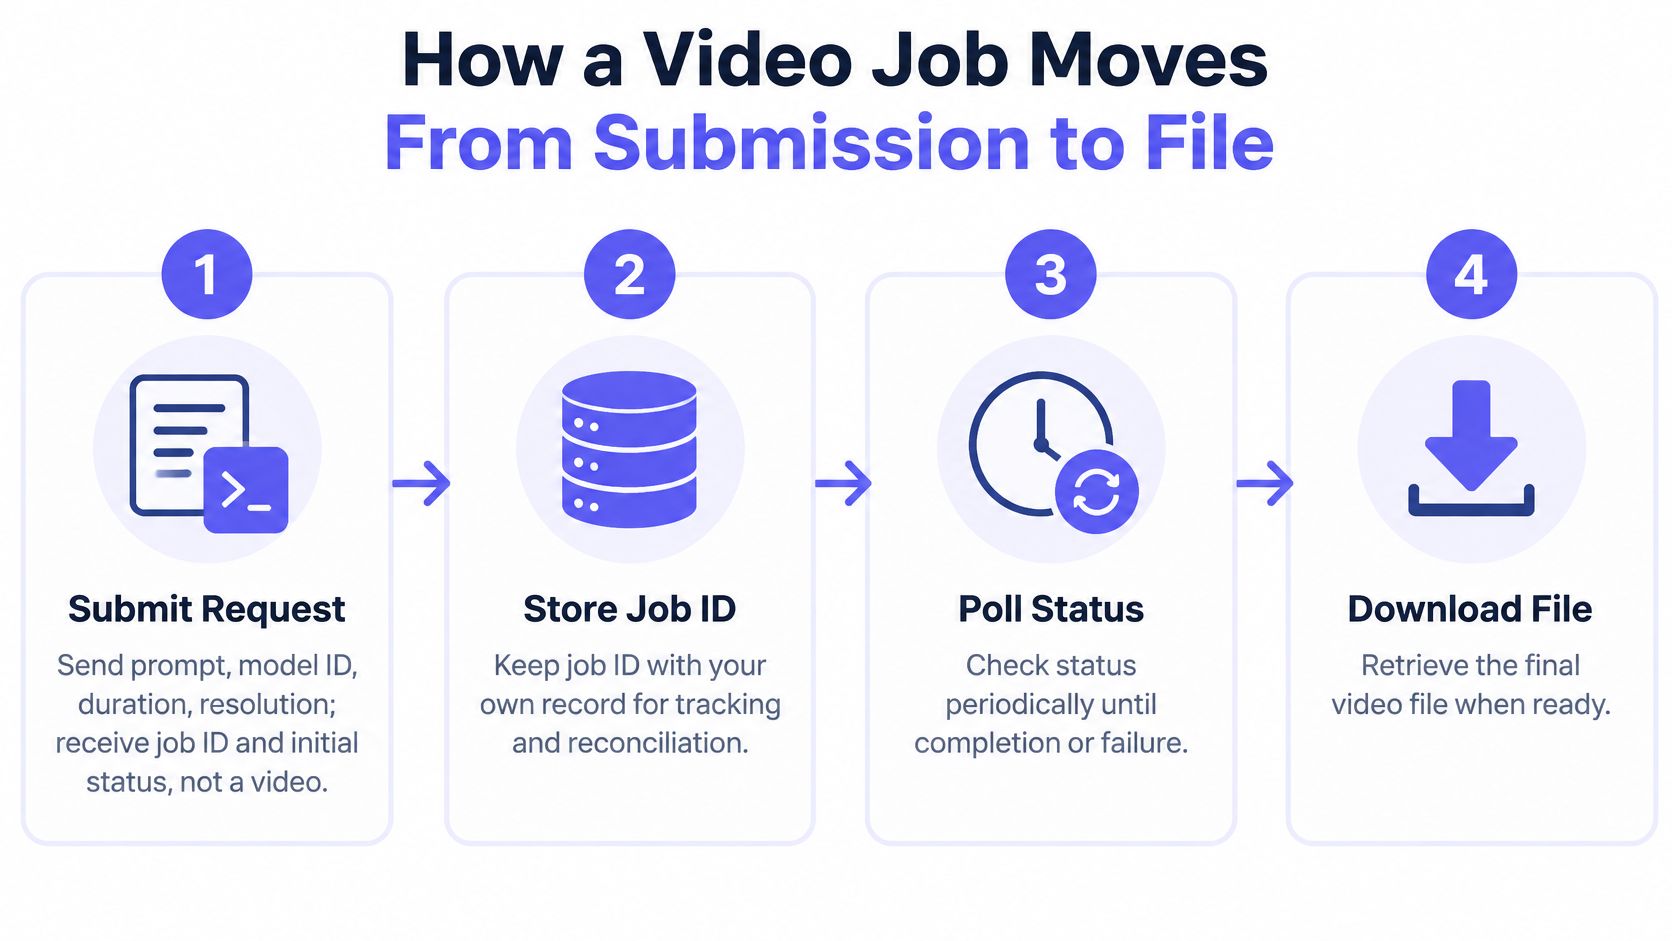
- Soumettez la requête. Envoyez le prompt, l'identifiant du modèle, la durée et la résolution. La réponse contient un job ID et un statut initial tel que queued. Stockez-le avant de faire quoi que ce soit d'autre, car un redémarrage du processus perdrait sinon la seule référence sur le travail que vous avez déjà payé.
- Associez le job ID à votre propre enregistrement. Conservez votre ID de requête interne, l'utilisateur ou le locataire auquel il appartient, les paramètres que vous avez envoyés, et la route du vendeur ou du fournisseur. Lorsqu'une question de facturation arrive trois jours plus tard, cette ligne est la réponse.
- Surveillez la ressource de statut. Interrogez-la ou attendez un événement, et enregistrez chaque transition avec un horodatage. Queued, running, succeeded, failed. L'écart entre queued et running est le temps d'attente en file (queue wait), et c'est le chiffre qui explique les plaintes de "modèle lent" qui n'ont rien à voir avec le modèle.
- Attendez un état terminal. Le succès et l'échec sont tous deux terminaux. Un timeout ne l'est pas, pas plus qu'une connexion interrompue, ne traitez donc jamais l'un ou l'autre comme un résultat.
- Récupérez le fichier uniquement en cas de succès. Demandez l'emplacement du contenu, streamez-le vers votre propre stockage, et enregistrez le checksum. Faire cela en cas d'échec gaspille des appels et peut masquer une erreur réelle comme un problème de téléchargement.
- Lisez l'erreur en cas d'échec. Décidez si la correction est un paramètre modifié, un modèle différent ou un message à l'utilisateur. Soumettre à nouveau des paramètres identiques après un rejet de contenu ne fait que gaspiller de l'argent.
À quoi ressemblent des logs de tâches sains
Un job ID, une exécution propre de queued à running à succeeded, et exactement un téléchargement. Tout autre élément dans le log est un bug que vous pouvez mesurer : deux téléchargements signifient un webhook en double que vous n'avez pas dédoublé, et un succès enregistré après que votre client a abandonné signifie que vous avez besoin d'une réconciliation.
Définissez la cancellation, le timeout, le retry et l'expiration sur votre propre enregistrement de tâche. Ces sémantiques appartiennent à votre gateway, pas à l'upstream qui a rendu le clip. Si l'appelant se déconnecte en plein rendu, laissez la tâche se terminer et réconciliez-la plus tard. La cancellation est un changement de statut explicite que vous envoyez, pas une connexion HTTP qui se ferme par hasard.
Sondage ou Webhooks pour les résultats vidéo terminés
Ces deux signaux répondent à la même question, et ils diffèrent par qui prend l'initiative. Le sondage signifie que votre code lit de manière répétée la ressource de statut jusqu'à ce que la tâche atteigne un état terminal. Les webhooks signifient que le fournisseur vous appelle avec un événement terminé ou échoué, et votre endpoint réagit.
| Question | Sondage | Webhooks |
|---|---|---|
| Comment vous apprenez le résultat | Lectures de statut répétées jusqu'à l'état terminal | Un événement terminé ou échoué |
| Quand vous le remarquez | Au prochain intervalle | Quand l'événement est livré |
| Charge supplémentaire | Un appel de statut par intervalle | Presque aucune, plus une rare réconciliation |
| Meilleure adéquation | Rendu par lots et une première version simple | Génération longue, basée sur les événements |
| Défaillance principale | La détection attend l'intervalle | Livraison manquée ou en double |
| Contrôle de sécurité | Reculer d'environ 15 secondes vers 60 secondes | Vérifier la signature, persister par ID de tâche, traiter la livraison comme 'au moins une fois', ignorer un téléchargement et une facturation répétés |
Pour les générations mesurées en minutes, les événements l'emportent sur le coût et la latence. Le volume de requêtes provenant du sondage de chaque tâche toutes les quelques secondes s'accumule dans une file d'attente, et le même trafic retarde votre détection jusqu'au prochain intervalle. La comparaison des webhooks avec le sondage direct d'API expose où chaque modèle s'adapte.
Construisez le gestionnaire avec cinq vérifications dans cet ordre :
- Vérifiez la signature lorsque le fournisseur en fournit une, et rejetez les livraisons non signées à la périphérie.
- Persistez l'événement par rapport à l'ID de tâche du fournisseur avant que tout travail de téléchargement, de facturation ou de notification ne s'exécute.
- Supposez une livraison 'au moins une fois', car le même événement terminé peut légitimement arriver deux fois.
- Rendez le gestionnaire idempotent, de sorte qu'une deuxième livraison voit un état terminal stocké et ignore le téléchargement et la facturation.
- Traitez l'événement échoué comme un résultat réel, non comme un timeout à retenter aveuglément.
Ajoutez ensuite le filet de sécurité. Si aucun événement n'arrive avant une date limite définie à partir de votre latence mesurée, sondez l'ID de tâche avec un backoff, commençant autour de 15 secondes et s'étendant vers 60 secondes. Testez les deux chemins de défaillance avant le lancement : forcez un événement en double, puis supprimez entièrement un événement, et confirmez que l'utilisateur se retrouve avec une seule vidéo et une seule facturation.
Règle pratique : un webhook est une optimisation pour le chemin nominal. Votre sondage de réconciliation est ce qui rend le système correct.
Choisir un modèle vidéo par cas d'utilisation
Présélectionnez les candidats selon cinq critères avant de consulter un classement : la modalité dont vous avez besoin, la durée et la résolution maximales, la prise en charge audio, le temps de génération mesuré et l'unité de coût facturée par le fournisseur. Ces cinq critères éliminent la plupart des options plus rapidement que n'importe quel classement de qualité.
| Famille de modèles | Modalité | Unité de coût à comparer | Temps ou prix connu |
|---|---|---|---|
| Kling 3.0 Standard | Texte et image vers vidéo | Par seconde | Environ 80 secondes pour un clip de 5 secondes |
| Veo 3.1 Fast | Texte vers vidéo | Par seconde à 1080p sans son | Enregistrez la latence dans votre propre test, car la charge de la file d'attente la fait varier |
| Veo 3.1 Full | Texte vers vidéo | Par tâche | $0.22 par tâche contre un prix catalogue de $0.44 |
| Seedance 2.0 Fast | Image vers vidéo à 480p, 5 secondes | Par clip | $0.35 par clip contre une offre concurrente de $0.29 |
| LTX 2.3 | Texte vers vidéo à 1080p | Par seconde | $0.06 par seconde à 1080p |
| Wan 2.6 | Texte vers vidéo | Par tâche | $0.16 par tâche |
L'unité de coût est aussi importante que le chiffre. Un prix par seconde convient aux clips de longueur variable et pénalise les clips longs, tandis qu'un prix par tâche rend un clip de longueur fixe prévisible et un clip plus long gratuit. Comparez deux modèles sur la même durée et résolution, sinon la comparaison n'a aucun sens.
Le temps de génération détermine si vous pouvez présenter le modèle à une personne. Un clip Kling 3.0 de 5 secondes a pris environ 80 secondes lors d'un test sur 29 octobre 2026, ce qui est respectable pour un clip court et impossible à cacher derrière un spinner sans état d'avancement. Un clip de 5 secondes qui prend 80 secondes nécessite un statut visible, une attente estimée et un moyen de quitter la page et de revenir.
Réduisez la sélection à deux ou trois modèles dans cet ordre : la modalité d'abord, puis la résolution et l'audio, puis la vitesse et l'unité de coût avec lesquelles vous pouvez composer. Gardez au moins une solution de repli dans la présélection même après avoir choisi une option par défaut. Un modèle qui correspond à votre style visuel peut toujours être trop lent pour votre interface, et vous voulez que l'alternative soit déjà évaluée lorsque cela se produit. La liste complète des modèles d'IA disponibles via un seul endpoint est un endroit raisonnable pour commencer la présélection plutôt que d'ouvrir neuf comptes fournisseurs.
Coût par clip utilisable versus prix annoncé
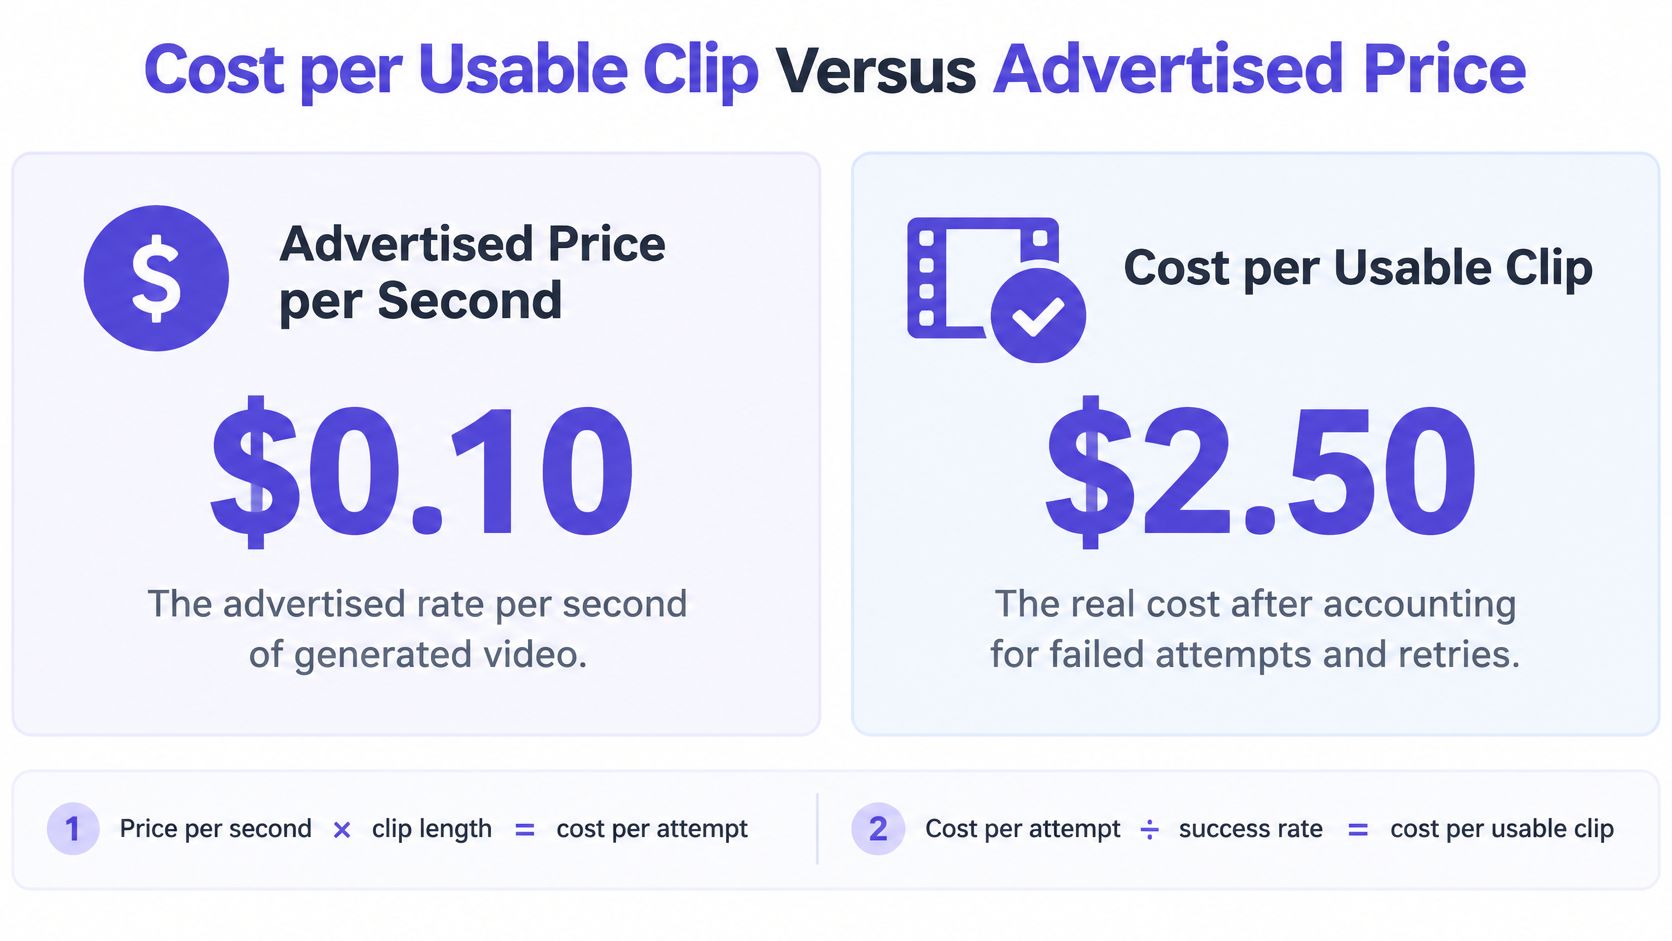
Le tarif annoncé par seconde vous indique le coût d'une tentative. Il ne dit rien sur le coût d'un clip utilisable, et c'est ce chiffre qui intéresse votre équipe financière.
Faisons le calcul avec un cas concret. À $0.10 par seconde, un clip de 5 secondes coûte $0.50 par tentative. Si une tentative sur quatre passe votre barre de qualité, le clip accepté coûte $2.00. Un concurrent à $0.07 par seconde coûte $0.35 par tentative, et si une tentative sur deux est utilisable, le clip accepté coûte $0.70. Le modèle qui semblait moins cher l'emporte de près de trois fois, et le tableau par seconde montrait le classement inverse.
Ce que les tableaux de prix omettent
Les tarifs publiés se situent entre environ $0.02 et $1 par seconde générée, selon la comparaison des prix de Runway pour les API vidéo IA, et cet écart est mesuré avant les coûts qui déterminent les budgets réels. La même analyse note qu'un modèle moins cher peut finir par coûter plus cher lorsqu'il nécessite quatre tentatives au lieu d'une. Ajoutez ceux-ci à votre modèle :
- Tâches échouées et modérées. Un rejet consomme une requête et ne renvoie rien d'utilisable, il doit donc figurer au dénominateur de votre taux de réussite, et non en dehors.
- Nouvelles tentatives que vous avez choisies. Chaque nouvelle soumission est un coût de tentative supplémentaire, c'est pourquoi le nombre de tentatives doit figurer dans la formule plutôt que dans une note séparée.
- Paramètres qui modifient le tarif. La résolution et l'audio modifient le prix par seconde, donc un test de référence exécuté avec les paramètres par défaut indique un prix que vous ne paierez peut-être jamais.
- Durées par défaut que vous n'avez pas définies. Une durée par défaut du fournisseur de 8 secondes alors que vous vouliez 5 augmente le coût par clip de 60%.
- Stockage et réhébergement. Un lien de résultat est temporaire. Copier le fichier vers votre propre bucket fait partie du coût du clip accepté.
Les règles de facturation façonnent également l'arithmétique. Une vidéo est facturée à son prix final une fois la génération terminée, et la réponse à une requête indique le coût maximal de la tâche avant le début de la vidéo, ce qui vous permet de définir un plafond budgétaire par tâche et par locataire. Ces deux règles transforment une estimation mensuelle vague en un plafond par requête que vous pouvez appliquer dans le code.
Définissez l'acceptation de manière stricte. Une tâche qui signale un succès n'est pas un clip utilisable. Comptez-le uniquement lorsqu'il respecte l'adhérence au prompt, maintient la cohérence temporelle, conserve l'identité du sujet et ne présente aucune erreur de mouvement ou de physique évidente. Pour une analyse plus complète de la comparaison des tarifs par seconde et par tâche entre les différentes routes, le guide sur le fonctionnement des modèles de tarification de l'IA couvre les unités de facturation.
Un statut de succès signifie que le rendu est terminé. Cela ne signifie pas que le clip vaut la peine d'être livré, et seul le second va au numérateur.
Champs de requête et métadonnées de sortie à vérifier
Une requête vidéo contient plus qu'une simple invite (prompt). Chaque champ sélectionne l'itinéraire, modifie le prix ou détermine si un bon résultat peut être reproduit ultérieurement. Envoyez ces sept éléments :
- L'identifiant du modèle, qui sélectionne l'itinéraire du fournisseur. Les identifiants sont structurés, donc
fal-ai/kling-video/v3/standard/text-to-videoencode le fournisseur, la famille, la version, le niveau et la modalité en une seule chaîne de caractères. Gardez-le dans la configuration, ne le codez jamais en dur dans la logique de la requête. - Le prompt, et pour l'image-vers-vidéo, l'image de référence ou son emplacement de téléchargement.
- La durée en secondes, car le prix et le temps de génération évoluent tous deux avec elle.
- La résolution et le rapport d'aspect, car tous deux influencent le tarif par seconde.
- Le réglage audio, lorsque le modèle prend en charge l'audio.
- Une seed lorsque le modèle en accepte une, afin qu'un bon résultat puisse être reproduit.
- Votre propre ID de requête, afin que la tâche du fournisseur puisse être reliée à votre enregistrement.
Champs de sortie à stocker pour chaque tâche terminée
Format du conteneur, codec vidéo, dimensions, fréquence d'images (frame rate), durée, présence et codec audio, débit binaire (bitrate) si disponible, taille du fichier, et une URL de contenu durable ou un identifiant d'objet. Stockez les métadonnées à côté du fichier, car le fichier seul ne vous dira pas le trimestre prochain quels paramètres l'ont produit.
Enregistrez ces métadonnées plutôt que de supposer que chaque résultat est équivalent. Deux clips de même durée peuvent arriver dans des codecs différents, à des débits binaires différents, avec ou sans piste audio. La spécification W3C WebCodecs définit les interfaces pour l'encodage et le décodage audio et vidéo sans imposer de codec ou de méthode d'encodage, donc rien ne garantit que deux rendus reviennent dans le même format.
Fournissez un profil MP4 conservateur pour les navigateurs et les applications, et conservez le fichier natif du fournisseur lorsque la qualité est importante pour une édition ultérieure. Ensuite, validez avant de considérer le succès. Vérifiez la durée décodée et le nombre d'images (frame count) par rapport à la requête, car un fichier de mauvaise longueur est un échec même lorsque l'API signale un succès. Un clip de 4 secondes alors que vous avez demandé 5 secondes perturbe une timeline tout aussi gravement qu'une tâche échouée, et c'est bien plus difficile à remarquer.
Intégrer la génération de vidéo dans le code SDK existant
Une intégration de texte existante s'adapte sans réécriture. Gardez le texte et la vidéo sur des routes séparées afin qu'ils puissent partager une seule API key, une seule base URL et un seul solde, et laissez le wrapper SDK en place. Déplacer un client compatible OpenAI ou Anthropic est un changement d'endpoint et de credentials, et changer de modèle est un changement d'identifiant.
Quatre parties d'un service vidéo léger
Une fonction de création valide l'entrée, appelle la route de génération et renvoie immédiatement votre propre ID de tâche interne. Vos appelants ne voient jamais un ID de fournisseur, ce qui rend un basculement ultérieur invisible pour eux.
Une table de tâches mappe les ID internes aux ID de tâche du fournisseur, au statut, à la route, aux horodatages et aux métadonnées de sortie. Traitez-la comme la source de vérité pour la réconciliation de la facturation, et non comme le tableau de bord du fournisseur.
Un worker interroge ou reçoit des webhooks, fait avancer la machine d'état et applique les règles de nouvelle tentative (retry) et de délai (deadline) que vous avez définies. Un seul worker gère les deux signaux, de sorte qu'un événement manqué et une interrogation lente convergent vers le même chemin de code.
Une étape de stockage copie le MP4 terminé dans votre propre bucket, calcule un checksum et écrit la ligne de métadonnées. C'est l'étape que les équipes sautent puis reconstruisent après leur premier lien expiré.
Limitez chaque API key à un seul environnement et gardez les clés révocables, afin qu'une clé de staging divulguée ne puisse pas atteindre la capacité de production. Pour les grandes images source ou les fichiers vidéo, téléchargez via une URL signée plutôt que d'intégrer des octets dans le corps de la requête, car une charge utile JSON de plusieurs mégaoctets est son propre mode de défaillance.
Ensuite, exécutez le test qu'un ingénieur senior vous demandera. Envoyez une requête qui expire côté client, et confirmez que le système se termine avec exactement une tâche stockée, un téléchargement éventuel et aucune soumission en double. Si ce test réussit, le reste de l'intégration est un détail.
Pannes de production et comment éviter les doublons
Une API de génération n'est pas un appel de fonction, et la traiter comme telle est la source des doublons. Avec une API de texte synchrone, un timeout signifie presque toujours que le travail n'a jamais eu lieu. Avec la vidéo, un timeout signifie seulement que vous avez cessé d'écouter. La tâche peut toujours être en file d'attente, toujours en cours d'exécution, et toujours sur le point de vous être facturée à son prix final au moment où elle se termine. L'image ci-dessous montre la version opérationnelle de cette idée : un pipeline qui se répare lui-même, avec quelqu'un qui en est responsable, plutôt qu'une file d'attente que personne ne surveille.
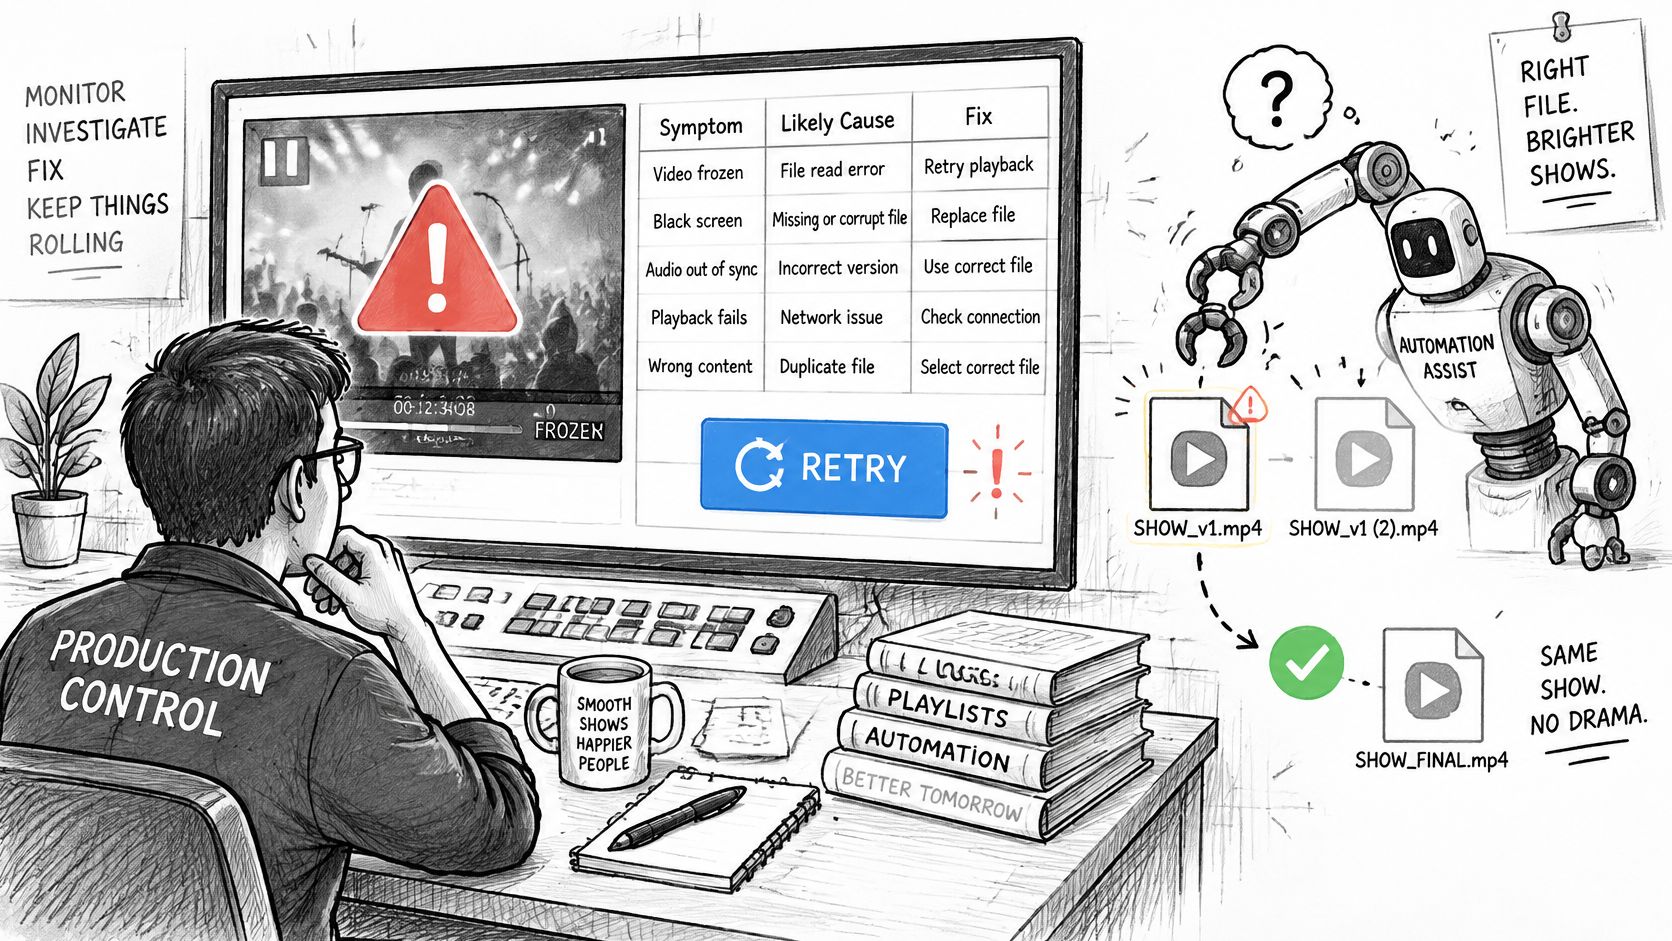
Sept symptômes expliquent la plupart des bugs d'intégration vidéo, et chacun correspond à une cause et une solution.
| Symptôme | Cause probable | Solution |
|---|---|---|
| Le webhook n'arrive jamais | Échec de livraison ou timeout de l'endpoint | Interroger l'ID de la tâche après un délai et réconcilier l'état |
| Même clip créé ou facturé deux fois | Nouvelle tentative d'une génération non-idempotente | Envoyer une clé d'idempotence par requête utilisateur et réutiliser l'ID de tâche stocké |
| La tâche signale un succès mais le fichier a une mauvaise longueur | Validation de la sortie ignorée | Vérifier la durée décodée et le nombre d'images avant de marquer le succès |
| Le rejet de modération ressemble à un échec générique | Le filtre de sécurité a arrêté la tâche | Lire le code d'erreur, modifier le prompt, ne pas retenter la même entrée |
| Le téléchargement échoue des heures plus tard | L'URL du résultat a expiré | Télécharger immédiatement, stocker le fichier avec un checksum, et l'archiver |
| Le style de sortie change après un basculement | Un modèle ou un vendeur différent a servi la tâche | Épingler le modèle pour les clips correspondants et basculer uniquement entre des équivalents testés |
| De nombreuses requêtes semblent lentes | Limite de débit ou attente en file d'attente | Suivre le temps d'attente en file d'attente séparément du temps de génération et définir des délais par tâche |
Pourquoi le basculement automatique peut vous coûter de l'argent
Le basculement est une habitude du texte qui ne se transpose pas proprement à la vidéo. Sur un endpoint de chat, retenter une requête expirée est bon marché et la réponse est identique dans tous les cas. Sur un endpoint vidéo, chaque nouvelle soumission est une nouvelle tâche facturable, tarifée par seconde de sortie, et un réacheminement vers un modèle différent peut modifier le mouvement, la cohérence d'identité, les résultats de sécurité ou la durée du clip. Les rapports comparatifs sur les meilleures API de génération vidéo par IA citent les limites de concurrence, les limites de débit, le comportement des files d'attente et les valeurs aberrantes lentes comme les grandes différences entre les fournisseurs, et la latence moyenne masque précisément les retards de queue qui cassent les produits interactifs.
Traitez donc les nouvelles tentatives et le basculement comme des risques de dépenses et de cohérence, et non comme des filets de sécurité gratuits. Chaque soumission en double augmente votre coût par clip accepté sans augmenter l'acceptation. Épinglez le modèle pour toute série de clips qui doivent correspondre, et n'autorisez le basculement qu'entre des modèles que vous avez testés comme équivalents sur vos propres prompts. Traitez un rejet de modération comme un résultat plutôt qu'une erreur transitoire : lisez le code, modifiez le prompt, et ne renvoyez pas automatiquement la même entrée.
Le mode de défaillance qui surprend les équipes expérimentées est plus subtil : une tâche peut atteindre le succès après que votre requête client ait déjà expiré. Si vous soumettez à nouveau au lieu de réconcilier la tâche stockée, vous payez le même clip deux fois. Les liens de résultats sont également temporaires et peuvent expirer, alors téléchargez le fichier terminé immédiatement, stockez-le avec un checksum, et écrivez la ligne d'archive. Cette étape est un contrôle, pas une tâche ménagère. UberLLM conserve les fichiers de résultats pendant environ 3 heures après la fin d'une tâche vidéo ou musicale, ce qui est suffisant pour une boucle de nouvelle tentative mais loin d'être suffisant pour remplacer votre propre bucket.
La facturation unique est assemblée à partir de plusieurs éléments, chacun petit en soi : une clé d'idempotence par requête utilisateur, un état de tâche durable, des webhooks vérifiés, une interrogation de réconciliation après un délai, des checksums sur les médias terminés, et un archivage immuable de chaque fichier terminé. Oubliez l'un d'entre eux et un cas limite finira par trouver la faille.
La règle du premier jour : chaque tâche vidéo doit avoir un état stocké que vous pouvez réconcilier sans facturer ou soumettre à nouveau le travail. Si vous ne pouvez pas répondre "combien cette tâche a-t-elle coûté et l'avons-nous livrée" depuis votre propre base de données, l'intégration n'est pas terminée.
Lancez un benchmark de modèle avant de vous engager
Vous pouvez trancher le choix du modèle avec un test qui tient en un après-midi. Choisissez un modèle par défaut et un challenger avec une unité de coût ou un profil de vitesse différent. Kling 3.0 Standard est un premier choix par défaut pratique pour le texte vers vidéo et l'image vers vidéo, et Veo 3.1 Fast constitue un challenger de coût utile. Ensuite :
- Réutilisez les prompts fixes, la durée, la résolution, le réglage audio et la règle d'acceptation de votre modèle de coût. Des entrées identiques sont le seul moyen pour qu'une comparaison ait un sens.
- Exécutez au moins 10 jobs par modèle, suffisamment pour observer un taux d'échec plutôt qu'une exécution chanceuse.
- Ne ramenez que quatre chiffres : taux de succès, latence médiane, latence de queue et coût par clip accepté.
- Vérifiez le tarif sur la route que vous appellerez. Pour le même profil texte vers vidéo en 1080p sans son, Veo 3.1 Fast coûte $0.075 par seconde sur UberLLM contre $0.10 par seconde sur fal.ai, et des écarts de cette taille changent le modèle gagnant.
- Gardez les flux séparés : les requêtes vidéo vont à
/v1/video/generationset les requêtes de chat restent sur/v1/chat/completions, même lorsqu'une seule API key et une seule base URL couvrent les deux.
Changer de candidat est un changement d'identifiant de modèle, donc le benchmark vous coûte des prompts et du temps, pas une migration. Choisissez la route avec le coût par clip accepté le plus bas qui répond toujours à vos exigences de latence et de qualité, épinglez-la pour toute série qui doit correspondre, et relancez le même ensemble de 10 jobs chaque mois à mesure que les prix et les conditions de file d'attente évoluent.
UberLLM achemine la génération vidéo à travers les fournisseurs derrière un endpoint compatible OpenAI et Anthropic, afin que vous puissiez soumettre un job une seule fois et laisser la passerelle gérer le vendeur, l'ID du job et le contrat de callback. Les modèles texte vers vidéo, image vers vidéo et d'upscaling côtoient vos modèles de chat sur la même key et le même solde prépayé, et les générations échouées ne sont pas facturées. Dirigez votre prochain benchmark vidéo vers UberLLM et comparez le coût par clip accepté plutôt que le coût par seconde.