API de Geração de Vídeo por IA: Tarefas, Modelos e Custos
Aprenda como funciona uma API de geração de vídeo por IA, desde tarefas assíncronas e webhooks até a escolha de modelos, verificações de saída e o custo real por clipe utilizável.
Sua conclusão de chat retorna em 400 milissegundos, então você conecta o vídeo da mesma forma: um POST, espera, coleta os bytes. Quatro minutos depois a conexão expira, o clipe termina de qualquer forma, e você pagou por um trabalho que ninguém coletou.
Essa lacuna é onde a maioria dos projetos de API de geração de vídeo com IA erram. A documentação faz o vídeo parecer um modelo de chat mais lento, e as tabelas de preços te levam a comparar centavos por segundo como se um segundo de filmagem gerada fosse uma unidade que você sempre consegue manter. O mercado está se expandindo rápido o suficiente para que o erro se amplifique. A Research and Markets avaliou o mercado global de geradores e editores de vídeo com IA em US$ 623 milhões em 2024 e projeta US$ 3.51 bilhões até 2034 com uma taxa de crescimento anual composta de 18.64% (Research and Markets, dezembro de 2024).
A pergunta útil não é qual API é a mais barata por segundo. É quanto custa um clipe utilizável, baixado e arquivado depois das falhas, das retentativas e do modelo que precisou de quatro tentativas.
Sumário
- Capacidades de Geração de Vídeo e Tipos de Solicitação
- Como um Trabalho de Vídeo Passa da Submissão ao Arquivo
- Polling ou Webhooks para Resultados de Vídeo Finalizados
- Escolhendo um Modelo de Vídeo por Caso de Uso
- Custo por Clipe Utilizável Versus Preço Anunciado
- Campos de Solicitação e Metadados de Saída para Verificar
- Integrando a Geração de Vídeo em Código SDK Existente
- Falhas de Produção e Como Prevenir Duplicatas
- Execute um Benchmark de Modelo Antes de se Comprometer
Capacidades de Geração de Vídeo e Tipos de Solicitação
Uma resposta de chat é uma mensagem. Um trabalho de vídeo é um arquivo que chega mais tarde, e o tipo de solicitação que você escolhe decide o que o provedor precisa inventar e o que ele entrega.
Texto para vídeo é a forma mais pura. Você envia um prompt e um identificador de modelo, e o modelo gera cada pixel a partir da descrição. Imagem para vídeo adiciona uma imagem de referência, então o assunto, enquadramento e iluminação vêm da imagem enquanto o prompt fornece o movimento. Essa única mudança remove a maior parte da deriva de identidade que torna clipes apenas de texto inutilizáveis para fotos de produtos e trabalhos com personagens.
| Tipo de solicitação | Entrada | Execução | Saída |
|---|---|---|---|
| Texto para vídeo | Prompt de texto e identificador de modelo | Trabalho assíncrono | Novo clipe MP4 |
| Imagem para vídeo | Imagem de referência e prompt | Trabalho assíncrono | Clipe MP4 ancorado à imagem |
| Upscaling de vídeo | Arquivo de vídeo existente | Trabalho assíncrono | MP4 de maior resolução |
| Vídeo com áudio | Prompt mais configuração de áudio | Trabalho assíncrono | MP4 com uma trilha de áudio onde o modelo suporta |
Upscaling de vídeo é o único tipo onde o conteúdo é fixo e apenas a resolução muda, então é o mais fácil de precificar e o mais difícil de errar. O áudio se divide em dois. Alguns modelos retornam uma trilha sonora junto com a imagem quando você liga o áudio, enquanto música e efeitos sonoros são modalidades separadas usando o mesmo formato de solicitação e a mesma mecânica de trabalho.
Três entradas aparecem em cada linha: o prompt ou mídia de origem, o identificador do modelo e o comprimento e resolução que você deseja. Inclua esses três em seu próprio schema de solicitação desde cedo e a troca de provedores mais tarde se torna uma mudança de configuração.
Defina a expectativa de tempo antes de construir qualquer coisa. Uma resposta de chat chega em segundos, enquanto uma solicitação de vídeo é aceita primeiro e finaliza depois, com uma execução típica levando cerca de 30 segundos a vários minutos. A resposta que você recebe imediatamente é um trabalho, não um clipe.
Como um Trabalho de Vídeo Passa da Submissão ao Arquivo
Toda API de vídeo pronta para produção segue um padrão, e é o padrão que a OpenAI documenta em seu guia da API de vídeo: crie um trabalho, leia seu status e, em seguida, obtenha o conteúdo assim que o status atingir um estado de sucesso terminal. Modele esse fluxo como um sistema de trabalho assíncrono, nunca como um download de mídia síncrono.
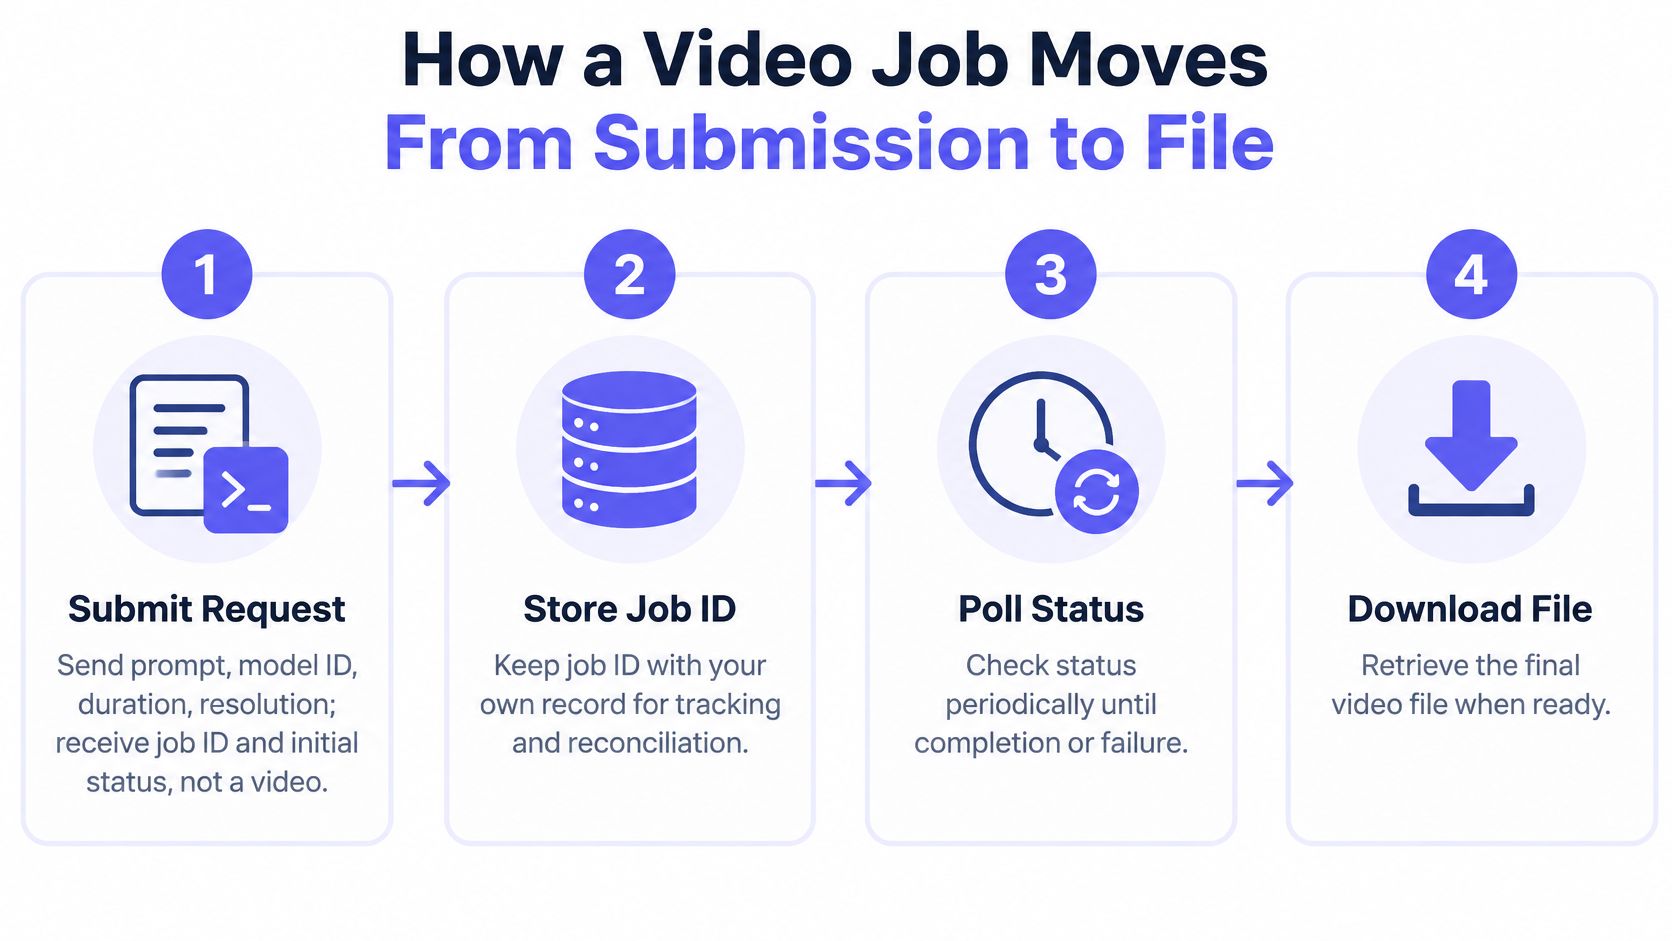
- Envie a solicitação. Envie o prompt, o identificador do modelo, a duração e a resolução. A resposta contém um job ID e um status inicial, como queued. Armazene-o antes de fazer qualquer outra coisa, pois uma reinicialização do processo, de outra forma, perderia a única referência ao trabalho pelo qual você já pagou.
- Mapeie o job ID para seu próprio registro. Mantenha seu ID de solicitação interno, o usuário ou locatário ao qual pertence, os parâmetros que você enviou e a rota do vendedor ou provedor. Quando uma pergunta de faturamento chegar três dias depois, esta linha é a resposta.
- Monitore o recurso de status. Faça polling ou aguarde um evento, e registre cada transição com um timestamp. Queued, running, succeeded, failed. A lacuna entre queued e running é o queue wait, e é o número que explica reclamações de "modelo lento" que não têm nada a ver com o modelo.
- Aguarde um estado terminal. Sucesso e falha são ambos terminais. Um timeout não é, e uma conexão perdida também não é, então nunca trate nenhum deles como um resultado.
- Obtenha o arquivo somente em caso de sucesso. Solicite a localização do conteúdo, faça streaming para seu próprio armazenamento e registre o checksum. Fazer isso no momento da falha desperdiça chamadas e pode mascarar um erro real como um problema de download.
- Leia o erro em caso de falha. Decida se a correção é um parâmetro alterado, um modelo diferente ou uma mensagem para o usuário. Reenviar parâmetros idênticos após uma rejeição de conteúdo apenas queima dinheiro.
Como são os logs de trabalho saudáveis
Um job ID, uma execução limpa de queued para running para succeeded, e exatamente um download. Qualquer outra coisa no log é um bug que você pode medir: dois downloads significam um webhook duplicado que você não deduplicou, e um sucesso registrado depois que seu cliente desistiu significa que você precisa de reconciliação.
Defina cancellation, timeout, retry e expiration em seu próprio registro de trabalho. Essas semânticas pertencem ao seu gateway, não a qualquer upstream que renderizou o clipe. Se o chamador se desconectar durante a renderização, deixe o trabalho terminar e reconcilie-o mais tarde. Cancellation é uma mudança de status explícita que você envia, não uma conexão HTTP que por acaso se fecha.
Polling ou Webhooks para Resultados de Vídeos Finalizados
Ambos os sinais respondem à mesma pergunta, e a diferença está em quem faz a busca. Polling significa que seu código lê repetidamente o recurso de status até que o trabalho atinja um estado terminal. Webhooks significam que o provedor te chama com um evento concluído ou falho, e seu endpoint reage.
| Pergunta | Polling | Webhooks |
|---|---|---|
| Como você fica sabendo do resultado | Leituras repetidas do status até o estado terminal | Um evento concluído ou falho |
| Quando você percebe | No próximo intervalo | Quando o evento é entregue |
| Carga extra | Uma chamada de status por intervalo | Quase nenhuma, mais uma reconciliação rara |
| Ideal para | Renderização em lote e uma primeira construção simples | Geração de longa duração, orientada a eventos |
| Falha principal | A detecção espera pelo intervalo | Entrega perdida ou duplicada |
| Controle de segurança | Recuar de cerca de 15 segundos para 60 segundos | Verificar a assinatura, persistir por ID do trabalho, tratar a entrega como at-least-once, pular um download e cobrança repetidos |
Para gerações medidas em minutos, eventos ganham tanto em custo quanto em latência. O volume de requisições de fazer polling de cada trabalho a cada poucos segundos se acumula em uma fila, e o mesmo tráfego atrasa sua detecção até o próximo intervalo. A comparação de webhooks com polling direto da API estabelece onde cada padrão se encaixa.
Construa o handler com cinco verificações nesta ordem:
- Verifique a assinatura quando o provedor fornecer uma, e rejeite entregas não assinadas na borda.
- Persista o evento contra o ID do trabalho do provedor antes que qualquer trabalho de download, cobrança ou notificação seja executado.
- Assuma a entrega at-least-once, porque o mesmo evento concluído pode legitimamente chegar duas vezes.
- Torne o handler idempotente, para que uma segunda entrega veja um estado terminal armazenado e pule o download e a cobrança.
- Trate o evento falho como um resultado real, não como um timeout a ser tentado novamente cegamente.
Então adicione a rede de segurança. Se nenhum evento chegar até um prazo definido a partir da sua latência medida, faça polling do ID do trabalho com backoff, começando em torno de 15 segundos e estendendo-se para 60 segundos. Teste ambos os caminhos de falha antes do lançamento: force um evento duplicado, depois suprima um evento inteiramente, e confirme que o usuário termina com um vídeo e uma cobrança.
Regra prática: um webhook é uma otimização para o caminho feliz. Seu polling de reconciliação é o que torna o sistema correto.
Escolhendo um Modelo de Vídeo por Caso de Uso
Pré-selecione os candidatos com base em cinco critérios antes de consultar um ranking: a modalidade de que você precisa, a duração e resolução máximas, suporte a áudio, tempo de geração medido e a unidade de custo que o provedor cobra. Esses cinco eliminam a maior parte das opções mais rapidamente do que qualquer classificação de qualidade.
| Família do modelo | Modalidade | Unidade de custo para comparar | Tempo ou preço conhecido |
|---|---|---|---|
| Kling 3.0 Standard | Texto e imagem para vídeo | Por segundo | Cerca de 80 segundos para um clipe de 5 segundos |
| Veo 3.1 Fast | Texto para vídeo | Por segundo em 1080p sem som | Registre a latência em seu próprio teste, já que a carga da fila a altera |
| Veo 3.1 Full | Texto para vídeo | Por trabalho | $0.22 por trabalho contra um preço de tabela de $0.44 |
| Seedance 2.0 Fast | Imagem para vídeo em 480p, 5 segundos | Por clipe | $0.35 por clipe contra uma listagem rival de $0.29 |
| LTX 2.3 | Texto para vídeo em 1080p | Por segundo | $0.06 por segundo em 1080p |
| Wan 2.6 | Texto para vídeo | Por trabalho | $0.16 por trabalho |
A unidade de custo importa tanto quanto o número. Um preço por segundo é adequado para clipes de duração variável e penaliza os longos, enquanto um preço por trabalho torna um clipe de duração fixa previsível e um clipe mais longo gratuito. Compare dois modelos com a mesma duração e resolução, ou a comparação não significa nada.
O tempo de geração decide se você pode colocar o modelo na frente de uma pessoa. Um clipe de Kling 3.0 de 5 segundos levou cerca de 80 segundos em um teste em 29 de outubro de 2026, o que é respeitável para um clipe curto e impossível de esconder atrás de um spinner sem estado de progresso. Um clipe de 5 segundos que leva 80 segundos precisa de um status visível, uma espera estimada e uma maneira de sair da página e voltar.
Reduza para dois ou três modelos nesta ordem: primeiro a modalidade, depois a resolução e o áudio, em seguida a velocidade e a unidade de custo com as quais você pode conviver. Mantenha pelo menos um plano B na pré-seleção mesmo depois de escolher um padrão. Um modelo que se encaixa no seu estilo visual ainda pode ser muito lento para sua interface, e você vai querer a alternativa já testada quando isso acontecer. A lista completa de modelos de IA disponíveis através de um único endpoint é um bom lugar para começar a pré-seleção, em vez de abrir nove contas de fornecedores.
Custo por Clipe Utilizável Versus Preço Anunciado
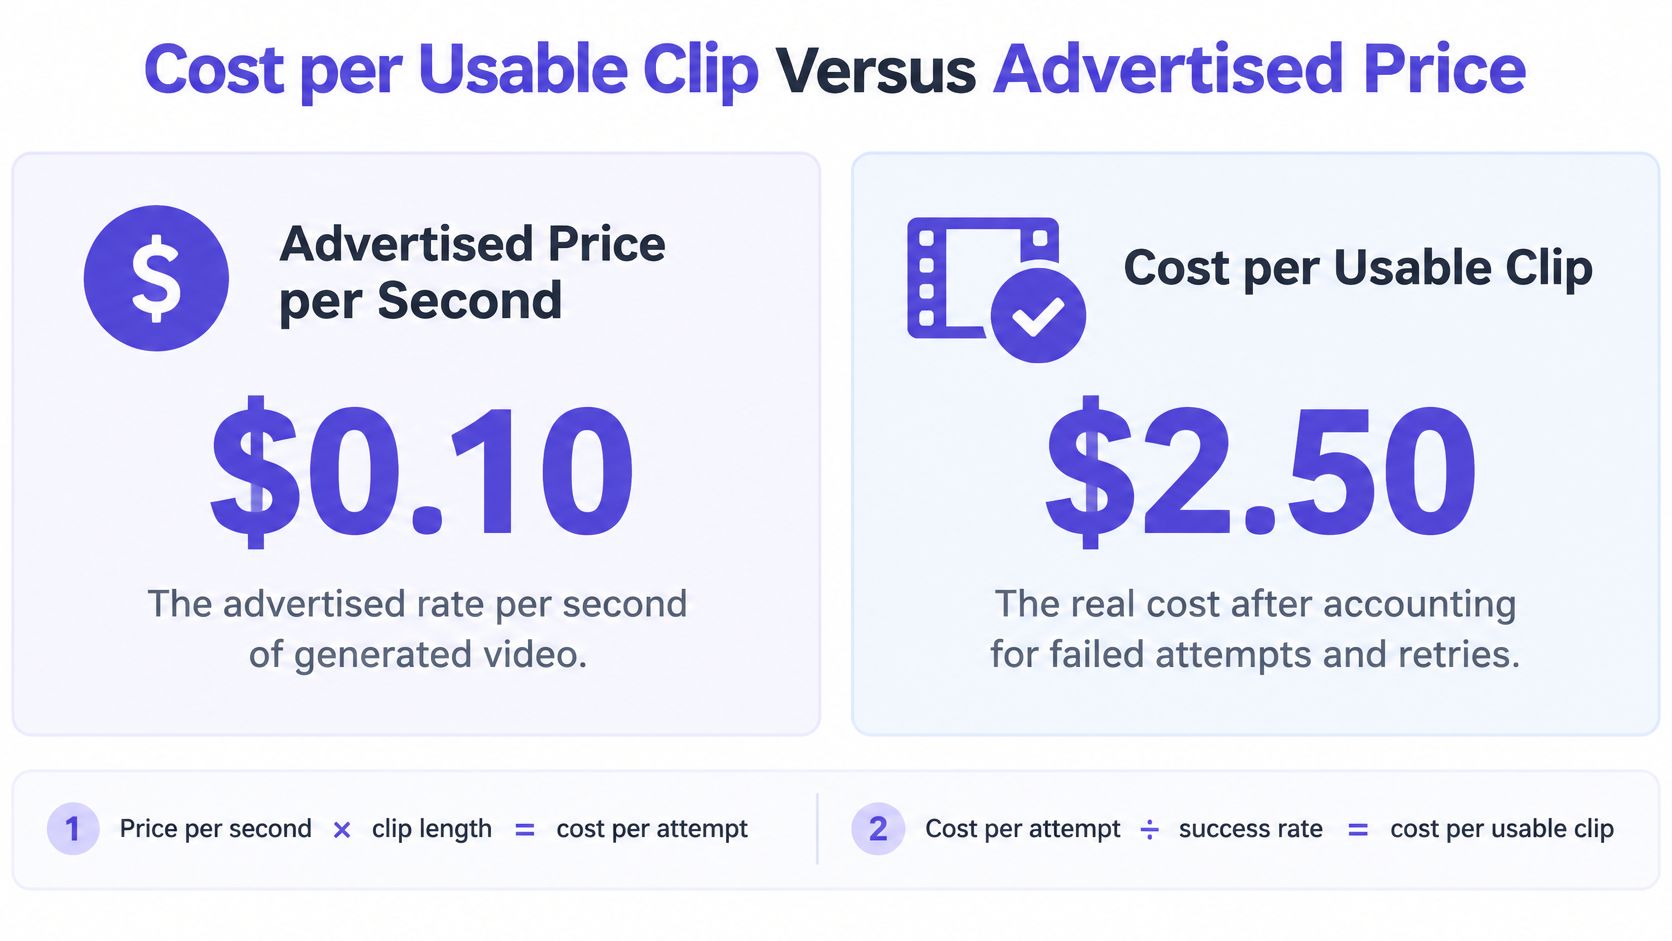
A taxa anunciada por segundo informa o custo de uma tentativa. Não diz nada sobre o custo de um clipe utilizável, e esse é o número que sua equipe financeira se importa.
Faça a aritmética com um caso concreto. A $0.10 por segundo, um clipe de 5 segundos custa $0.50 por tentativa. Se uma tentativa em quatro atinge seu padrão de qualidade, o clipe aceito custa $2.00. Um concorrente a $0.07 por segundo custa $0.35 por tentativa, e se uma tentativa em duas for utilizável, o clipe aceito custa $0.70. O modelo que parece mais barato ganha por quase três vezes, e a tabela por segundo mostrou o ranking oposto.
O que as tabelas de preços omitem
As taxas publicadas agrupam-se entre aproximadamente $0.02 e $1 por segundo gerado, de acordo com a comparação de preços da Runway para APIs de vídeo de IA, e essa diferença é medida antes dos custos que decidem orçamentos reais. A mesma análise observa que um modelo mais barato pode acabar sendo mais caro quando precisa de quatro tentativas em vez de uma. Adicione estes ao seu modelo:
- Trabalhos falhos e moderados. Uma rejeição consome uma requisição e não retorna nada que você possa usar, então ela pertence ao denominador da sua taxa de sucesso, não fora dele.
- Retentativas que você escolheu. Cada reenvio é outro custo de tentativa, e é por isso que a contagem de tentativas pertence à fórmula em vez de uma nota separada.
- Configurações que alteram a taxa. Resolução e áudio alteram o preço por segundo, então um benchmark executado com configurações padrão cita um preço que você talvez nunca pague.
- Durações padrão que você não definiu. Um padrão do provedor de 8 segundos quando você queria 5 aumenta o custo por clipe em 60%.
- Armazenamento e re-hospedagem. Um link de resultado é temporário. Copiar o arquivo para seu próprio bucket faz parte do custo do clipe aceito.
As regras de faturamento também moldam a aritmética. Um vídeo é faturado pelo seu preço final assim que a geração é concluída, e a resposta a uma requisição informa o máximo que o trabalho pode custar antes do vídeo começar, o que permite definir um limite de orçamento por trabalho e por inquilino. Essas duas regras transformam uma estimativa mensal vaga em um teto por requisição que você pode aplicar em código.
Defina a aceitação de forma restrita. Um trabalho que reporta sucesso não é um clipe utilizável. Conte-o apenas quando ele passar na aderência ao prompt, mantiver a consistência temporal, preservar a identidade do sujeito e não mostrar erros óbvios de movimento ou física. Para uma análise mais completa de como as taxas por segundo e por trabalho se comparam entre as rotas, o guia sobre como funcionam os modelos de precificação de IA cobre as unidades de faturamento.
Um status de sucesso significa que a renderização foi concluída. Não significa que o clipe vale a pena ser enviado, e apenas o segundo vai para o numerador.
Campos de Requisição e Metadados de Saída para Verificar
Uma requisição de vídeo carrega mais do que um prompt. Cada campo escolhe a rota, altera o preço ou decide se um bom resultado pode ser reproduzido mais tarde. Envie estes sete:
- O identificador do modelo, que seleciona a rota do provedor. Identificadores possuem estrutura, então
fal-ai/kling-video/v3/standard/text-to-videocodifica provedor, família, versão, nível e modalidade em uma única string. Mantenha-o na configuração, nunca codificado diretamente na lógica da requisição. - O prompt, e para imagem-para-vídeo a imagem de referência ou sua localização de upload.
- Duração em segundos, porque o preço e o tempo de geração escalam com ela.
- Resolução e proporção de tela, já que ambos influenciam a taxa por segundo.
- A configuração de áudio, onde o modelo suporta áudio.
- Uma seed quando o modelo aceita uma, para que um bom resultado possa ser reproduzido.
- Seu próprio ID de requisição, para que o trabalho do provedor possa ser mapeado de volta ao seu registro.
Campos de saída para armazenar com cada tarefa concluída
Formato do contêiner, codec de vídeo, dimensões, taxa de quadros, duração, presença e codec de áudio, bitrate (onde disponível), tamanho do arquivo e um URL de conteúdo durável ou identificador de objeto. Armazene os metadados ao lado do arquivo, porque o arquivo sozinho não informará no próximo trimestre quais configurações o produziram.
Registre esses metadados em vez de assumir que todo resultado é equivalente. Dois clipes com a mesma duração podem chegar em codecs diferentes, com bitrates diferentes, com ou sem uma trilha de áudio. A especificação W3C WebCodecs define as interfaces para codificação e decodificação de áudio e vídeo sem exigir um codec ou um método de codificação, então nada garante que duas renderizações retornem no mesmo formato.
Entregue um perfil MP4 conservador para navegadores e aplicativos, e mantenha o arquivo nativo do provedor quando a qualidade for importante para uma edição posterior. Em seguida, valide antes do sucesso. Verifique a duração decodificada e a contagem de quadros em relação à requisição, porque um arquivo com o comprimento errado é uma falha mesmo quando a API reporta sucesso. Um clipe de 4 segundos onde você pediu 5 quebra uma linha do tempo tão mal quanto um trabalho falho, e é muito mais difícil de notar.
Integrando Geração de Vídeo em Código SDK Existente
Uma integração de texto existente se adapta sem reescrita. Mantenha texto e vídeo em rotas separadas para que ambos possam compartilhar uma API key, uma base URL e um saldo, e deixe o wrapper do SDK no lugar. Mover um cliente compatível com OpenAI ou Anthropic é uma mudança de endpoint e credencial, e trocar de modelos é uma mudança de identificador.
Quatro partes de um serviço de vídeo leve
Uma função de criação valida a entrada, chama a rota de geração e retorna imediatamente seu próprio ID de job interno. Seus chamadores nunca veem um ID de provedor, o que torna uma falha posterior invisível para eles.
Uma tabela de jobs mapeia IDs internos para IDs de job do provedor, status, rota, timestamps e metadados de saída. Trate-a como a fonte da verdade para a reconciliação de faturamento, não o painel do provedor.
Um worker consulta ou recebe webhooks, avança a máquina de estados e aplica as regras de retry e deadline que você definiu. Um worker lida com ambos os sinais, então um evento perdido e uma consulta lenta convergem para o mesmo caminho de código.
Uma etapa de armazenamento copia o MP4 finalizado para seu próprio bucket, calcula um checksum e escreve a linha de metadados. Esta é a etapa que as equipes pulam e depois reconstroem após seu primeiro link expirado.
Delimite cada API key a um ambiente e mantenha as chaves revogáveis, para que uma chave de staging vazada não possa atingir a capacidade de produção. Para imagens ou arquivos de vídeo de origem grandes, faça o upload através de uma URL assinada em vez de incorporar bytes no corpo da requisição, já que um payload JSON de vários megabytes é seu próprio modo de falha.
Em seguida, execute o teste que um engenheiro sênior perguntará. Envie uma requisição que expire no cliente e confirme que o sistema termina com exatamente uma tarefa armazenada, um download eventual e nenhuma submissão duplicada. Se esse teste passar, o resto da integração é detalhe.
Falhas de Produção e Como Prevenir Duplicatas
Uma API de geração não é uma chamada de função, e tratá-la como tal é a origem das duplicatas. Com uma API de texto síncrona, um timeout quase sempre significa que o trabalho nunca aconteceu. Com vídeo, um timeout significa apenas que você parou de ouvir. O trabalho ainda pode estar na fila, ainda em execução e prestes a ser cobrado pelo seu preço final no momento em que for concluído. A imagem abaixo mostra a versão operacional dessa ideia: um pipeline que se repara, com alguém sendo o responsável por ele, em vez de uma fila que ninguém monitora.
Sete sintomas são responsáveis pela maioria dos bugs de integração de vídeo, e cada um corresponde a uma causa e uma correção.
| Sintoma | Causa provável | Correção |
|---|---|---|
| Webhook nunca chega | Falha na entrega ou timeout do endpoint | Consulte o ID do trabalho após um prazo e reconcilie o estado |
| Mesmo clipe criado ou cobrado duas vezes | Nova tentativa de uma geração não-idempotente | Envie uma idempotency key por solicitação do usuário e reutilize o ID do trabalho armazenado |
| Trabalho relata sucesso, mas o arquivo tem duração errada | Validação de saída ignorada | Verifique a duração decodificada e a contagem de quadros antes de marcar como sucesso |
| Rejeição de moderação parece uma falha genérica | Filtro de segurança interrompeu o trabalho | Leia o código de erro, altere o prompt, não tente novamente a mesma entrada |
| Download falha horas depois | URL do resultado expirou | Baixe imediatamente, armazene o arquivo com um checksum e arquive-o |
| Estilo de saída muda após failover | Um modelo ou vendedor diferente atendeu ao trabalho | Fixe o modelo para clipes correspondentes e faça failover apenas entre equivalentes testados |
| Muitas solicitações parecem lentas | Rate limit ou espera na fila | Rastreie o tempo de fila separadamente do tempo de geração e defina prazos por trabalho |
Por que o failover automático pode custar dinheiro
Failover é um hábito de texto que não se transfere de forma limpa para vídeo. Em um endpoint de chat, tentar novamente uma solicitação com timeout é barato e a resposta é idêntica de qualquer forma. Em um endpoint de vídeo, cada reenvio é um novo trabalho cobrável precificado por segundo de saída, e um redirecionamento para um modelo diferente pode alterar o movimento, a consistência da identidade, os resultados de segurança ou a duração do clipe. Relatórios comparativos sobre as melhores APIs de geração de vídeo com IA apontam limites de concorrência, rate limits, comportamento da fila e outliers lentos como as grandes diferenças entre os provedores, e a latência média esconde exatamente os atrasos de cauda que quebram produtos interativos.
Portanto, trate as novas tentativas e o failover como riscos de custo e consistência, não como redes de segurança gratuitas. Cada envio duplicado aumenta seu custo por clipe aceito sem aumentar a aceitação. Fixe o modelo para qualquer série de clipes que devem corresponder, e permita failover apenas entre modelos que você testou como equivalentes em seus próprios prompts. Trate uma rejeição de moderação como um resultado, e não como um erro transitório: leia o código, altere o prompt e não reenvie a mesma entrada automaticamente.
O modo de falha que pega equipes experientes é mais sutil: um trabalho pode atingir o sucesso depois que sua solicitação de cliente já atingiu o timeout. Se você reenviar em vez de reconciliar o trabalho armazenado, você paga pelo mesmo clipe duas vezes. Links de resultado também são temporários e podem expirar, então baixe o arquivo finalizado imediatamente, armazene-o com um checksum e escreva a linha do arquivo morto. Esse passo é um controle, não uma tarefa de manutenção. UberLLM mantém arquivos de resultado por cerca de 3 horas após a conclusão de um trabalho de vídeo ou música, o que é tempo suficiente para um loop de nova tentativa e nem de perto o suficiente para substituir seu próprio bucket.
A cobrança de "exatamente uma vez" é montada a partir de partes, cada uma pequena por si só: uma idempotency key por solicitação do usuário, estado de tarefa durável, webhooks verificados, consulta de reconciliação após um prazo, checksums em mídias concluídas e arquivamento imutável de cada arquivo finalizado. Pule qualquer um deles e algum caso de borda acabará encontrando a lacuna.
A regra do primeiro dia: todo trabalho de vídeo deve ter um estado armazenado que você possa reconciliar sem cobrar ou reenviar o trabalho. Se você não consegue responder "quanto custou este trabalho e nós o entregamos" a partir do seu próprio banco de dados, a integração não está concluída.
Execute um Benchmark de Modelo Antes de se Comprometer
Você pode definir a escolha do modelo com um teste que cabe em uma tarde. Escolha um padrão e um desafiante com uma unidade de custo ou perfil de velocidade diferente. Kling 3.0 Standard é um primeiro padrão prático para texto para vídeo e imagem para vídeo, e Veo 3.1 Fast é um desafiante de custo útil. Em seguida:
- Reutilize os prompts fixos, duração, resolução, configuração de áudio e regra de aceitação do seu modelo de custo. Entradas idênticas são a única forma de uma comparação significar algo.
- Execute pelo menos 10 jobs por modelo, o suficiente para observar uma taxa de falha em vez de uma execução com sorte.
- Obtenha apenas quatro números: taxa de sucesso, latência mediana, latência de cauda e custo por clipe aceito.
- Verifique a taxa na rota que você irá chamar. Para o mesmo perfil de texto para vídeo em 1080p sem som, Veo 3.1 Fast custa $0.075 por segundo no UberLLM contra $0.10 por segundo no fal.ai, e diferenças desse tamanho mudam qual modelo vence.
- Mantenha a infraestrutura separada: solicitações de vídeo vão para
/v1/video/generationse solicitações de chat permanecem em/v1/chat/completions, mesmo quando uma API key e uma base URL cobrem ambos.
Mudar de candidato é uma mudança de identificador de modelo, então o benchmark custa prompts e tempo, não uma migração. Escolha a rota com o menor custo por clipe aceito que ainda atenda à sua barra de latência e qualidade, fixe-o para qualquer série que deva corresponder, e execute novamente o mesmo conjunto de 10 jobs a cada mês, conforme os preços e as condições da fila mudam.
UberLLM roteia a geração de vídeo entre provedores por trás de um endpoint compatível com OpenAI e Anthropic, para que você possa enviar um job uma vez e deixar o gateway lidar com o vendedor, o job ID e o contrato de callback. Modelos de texto para vídeo, imagem para vídeo e upscaling ficam ao lado dos seus modelos de chat na mesma key e saldo pré-pago, e gerações falhas não são cobradas. Aponte seu próximo benchmark de vídeo para UberLLM e compare o custo por clipe aceito em vez do custo por segundo.