API di Generazione Video AI: Processi, Modelli e Costi
Scopri come funziona un'API di generazione video AI, dai processi asincroni e webhook alla scelta del modello, ai controlli dell'output e al costo reale per clip utilizzabile.
La tua chat completion restituisce in 400 millisecondi, quindi invii il video allo stesso modo: un POST, attendi, raccogli i byte. Quattro minuti dopo la connessione va in timeout, il clip finisce comunque, e hai pagato per un lavoro che nessuno ha ritirato.
Questo divario è dove la maggior parte dei progetti API di generazione video AI va storta. La documentazione fa sembrare il video un modello di chat più lento, e le tabelle dei prezzi ti spingono a confrontare i centesimi al secondo come se un secondo di filmato generato fosse un'unità che puoi sempre conservare. Il mercato si sta espandendo abbastanza velocemente da far sì che l'errore si amplifichi. Research and Markets ha valutato il mercato globale dei generatori ed editor video AI a USD 623 milioni nel 2024 e prevede USD 3.51 miliardi entro il 2034 con un tasso di crescita annuale composto del 18.64% (Research and Markets, Dicembre 2024).
La domanda utile non è quale API sia la più economica al secondo. È quanto costa un clip utilizzabile, scaricato e archiviato dopo i fallimenti, i tentativi e il modello che ha richiesto quattro tentativi.
Indice
- Funzionalità di generazione video e tipi di richiesta
- Come un lavoro video passa dalla sottomissione al file
- Polling o Webhook per i risultati video finali
- Scegliere un modello video per caso d'uso
- Costo per clip utilizzabile rispetto al prezzo pubblicizzato
- Campi di richiesta e metadati di output da controllare
- Integrare la generazione video nel codice SDK esistente
- Errori di produzione e come prevenire i duplicati
- Esegui un benchmark del modello prima di impegnarti
Funzionalità di generazione video e tipi di richiesta
Una risposta di chat è un messaggio. Un lavoro video è un file che arriva più tardi, e il tipo di richiesta che scegli decide cosa il fornitore deve inventare e cosa ti restituisce.
Testo a video è la forma più pura. Invii un prompt e un identificatore di modello, e il modello genera ogni pixel dalla descrizione. Immagine a video aggiunge un'immagine di riferimento, quindi soggetto, inquadratura e illuminazione provengono dall'immagine mentre il prompt fornisce il movimento. Questo singolo cambiamento rimuove la maggior parte della deriva di identità che rende i clip solo testuali inutilizzabili per scatti di prodotti e lavori con personaggi.
| Tipo di richiesta | Input | Esecuzione | Output |
|---|---|---|---|
| Testo a video | Prompt testuale e identificatore di modello | Lavoro asincrono | Nuovo clip MP4 |
| Immagine a video | Immagine di riferimento e prompt | Lavoro asincrono | Clip MP4 ancorato all'immagine |
| Upscaling video | File video esistente | Lavoro asincrono | MP4 a risoluzione più alta |
| Video con audio | Prompt più impostazione audio | Lavoro asincrono | MP4 con una traccia audio dove il modello lo supporta |
Upscaling video è l'unico tipo in cui il contenuto è fisso e solo la risoluzione cambia, quindi è il più facile da stimare e il più difficile da sbagliare. L'audio si divide in due. Alcuni modelli restituiscono una colonna sonora insieme all'immagine quando attivi l'audio, mentre musica ed effetti sonori sono modalità separate che utilizzano la stessa forma di richiesta e la stessa meccanica di lavoro.
Tre input appaiono in ogni riga: il prompt o il media sorgente, l'identificatore del modello, e la lunghezza e risoluzione che desideri. Integra questi tre nel tuo schema di richiesta fin da subito e scambiare fornitori in seguito diventerà un cambiamento di configurazione.
Imposta l'aspettativa sui tempi prima di costruire qualsiasi cosa. Una risposta di chat arriva in pochi secondi, mentre una richiesta video viene prima accettata e finisce più tardi, con un'esecuzione tipica che richiede circa 30 secondi a diversi minuti. La risposta che ricevi immediatamente è un lavoro, non un clip.
Come un lavoro video passa dalla sottomissione al file
Ogni API video pronta per la produzione segue un unico schema, ed è lo schema che OpenAI documenta nella sua guida API video: crea un lavoro, leggi il suo stato, quindi recupera il contenuto una volta che lo stato raggiunge uno stato di successo terminale. Modella questo flusso come un sistema di lavori asincroni, mai come un download multimediale sincrono.
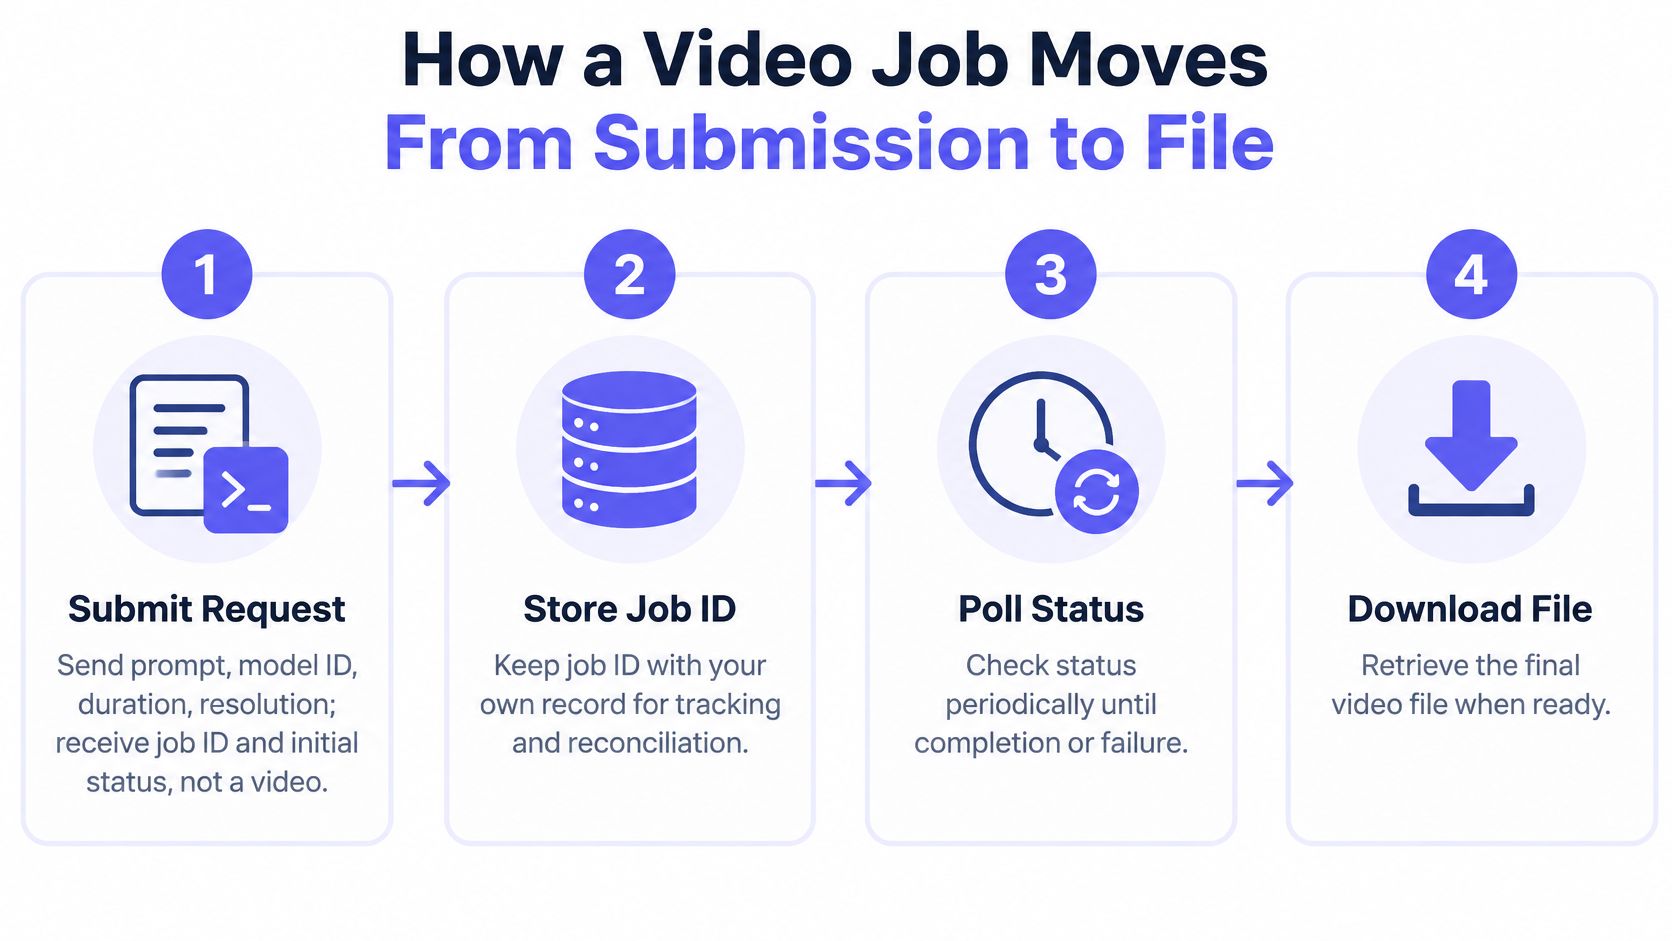
- Invia la richiesta. Invia il prompt, l'identificatore del modello, la durata e la risoluzione. La risposta contiene un ID del lavoro e uno stato iniziale come in coda. Conservalo prima di fare qualsiasi altra cosa, perché un riavvio del processo altrimenti perde l'unico riferimento al lavoro che hai già pagato.
- Mappa l'ID del lavoro al tuo record. Conserva il tuo ID di richiesta interno, l'utente o il tenant a cui appartiene, i parametri che hai inviato e la rotta del venditore o del fornitore. Quando una domanda di fatturazione arriva tre giorni dopo, questa riga è la risposta.
- Monitora la risorsa di stato. Effettua il polling o attendi un evento, e registra ogni transizione con un timestamp. In coda, in esecuzione, riuscito, fallito. Il divario tra in coda e in esecuzione è il tempo di attesa in coda, ed è il numero che spiega i reclami per "modello lento" che non hanno nulla a che fare con il modello.
- Attendi uno stato terminale. Successo e fallimento sono entrambi terminali. Un timeout non lo è, e nemmeno una connessione interrotta, quindi non trattare mai nessuno dei due come un risultato.
- Recupera il file solo in caso di successo. Richiedi la posizione del contenuto, trasmettilo in streaming al tuo archivio e registra il checksum. Fare questo in caso di fallimento spreca chiamate e può mascherare un errore reale come un problema di download.
- Leggi l'errore in caso di fallimento. Decidi se la soluzione è un parametro modificato, un modello diverso o un messaggio all'utente. Re-inviare parametri identici dopo un rifiuto del contenuto brucia solo denaro.
Come si presentano i log di lavoro sani
Un ID lavoro, un'esecuzione pulita da in coda a in esecuzione a riuscito, ed esattamente un download. Qualsiasi altra cosa nel log è un bug che puoi misurare: due download significano un webhook duplicato che non hai deduplicato, e un successo registrato dopo che il tuo client ha rinunciato significa che hai bisogno di riconciliazione.
Definisci annullamento, timeout, riprova e scadenza sul tuo record di lavoro. Queste semantiche appartengono al tuo gateway, non a qualsiasi upstream che ha renderizzato il clip. Se il chiamante si disconnette a metà rendering, lascia che il lavoro finisca e riconcilialo più tardi. L'annullamento è un cambiamento di stato esplicito che invii, non una connessione HTTP che si chiude per caso.
Polling o Webhook per i Risultati Video Finali
Entrambi i segnali rispondono alla stessa domanda e differiscono per chi esegue il monitoraggio. Il polling significa che il tuo codice legge ripetutamente la risorsa di stato finché il lavoro non raggiunge uno stato terminale. I webhook significano che il provider ti chiama con un evento completato o fallito, e il tuo endpoint reagisce.
| Domanda | Polling | Webhook |
|---|---|---|
| Come apprendi il risultato | Letture di stato ripetute fino allo stato terminale | Un evento completato o fallito |
| Quando noti | Al prossimo intervallo | Quando l'evento viene consegnato |
| Carico aggiuntivo | Una chiamata di stato per intervallo | Quasi nessuno, più una rara riconciliazione |
| Migliore adattamento | Rendering batch e una semplice prima build | Generazione a lungo termine, basata su eventi |
| Guasto principale | Il rilevamento attende l'intervallo | Consegna mancata o duplicata |
| Controllo di sicurezza | Riduci la frequenza da circa 15 secondi a 60 secondi | Verifica la firma, persisti per ID lavoro, tratta la consegna come at-least-once, salta un download e una fatturazione ripetuti |
Per generazioni misurate in minuti, gli eventi vincono sia in termini di costo che di latenza. Il volume di richieste derivante dal polling di ogni lavoro ogni pochi secondi si somma attraverso una coda, e lo stesso traffico ritarda il tuo rilevamento fino al prossimo intervallo. Il confronto tra webhook e polling API diretto illustra dove si adatta ogni modello.
Costruisci il gestore con cinque controlli in questo ordine:
- Verifica la firma quando il provider ne fornisce una, e rifiuta le consegne non firmate al limite.
- Persisti l'evento rispetto all'ID lavoro del provider prima che venga eseguito qualsiasi lavoro di download, fatturazione o notifica.
- Assumi la consegna at-least-once, perché lo stesso evento completato può legittimamente arrivare due volte.
- Rendi il gestore idempotente, in modo che una seconda consegna veda uno stato terminale memorizzato e salti il download e l'addebito.
- Gestisci l'evento fallito come un risultato reale, non come un timeout da riprovare ciecamente.
Poi aggiungi la rete di sicurezza. Se nessun evento arriva entro una scadenza impostata dalla tua latenza misurata, esegui il polling dell'ID lavoro con backoff, iniziando intorno a 15 secondi e estendendoti verso 60 secondi. Testa entrambi i percorsi di fallimento prima del lancio: forza un evento duplicato, poi sopprimi completamente un evento, e conferma che l'utente si ritrovi con un video e un addebito.
Regola pratica: un webhook è un'ottimizzazione per il percorso felice. Il tuo polling di riconciliazione è ciò che rende il sistema corretto.
Scegliere un modello video in base al caso d'uso
Seleziona i candidati in base a cinque criteri prima di consultare una classifica: la modalità di cui hai bisogno, la durata e la risoluzione massime, il supporto audio, il tempo di generazione misurato e l'unità di costo con cui il fornitore fattura. Questi cinque eliminano la maggior parte delle opzioni più velocemente di qualsiasi classifica di qualità.
| Famiglia di modelli | Modalità | Unità di costo da confrontare | Tempo o prezzo noto |
|---|---|---|---|
| Kling 3.0 Standard | Da testo e immagine a video | Al secondo | Circa 80 secondi per una clip di 5 secondi |
| Veo 3.1 Fast | Da testo a video | Al secondo a 1080p senza audio | Registra la latenza nel tuo test, poiché il carico della coda la influenza |
| Veo 3.1 Full | Da testo a video | Per lavoro | $0.22 per lavoro contro un prezzo di listino di $0.44 |
| Seedance 2.0 Fast | Da immagine a video a 480p, 5 secondi | Per clip | $0.35 per clip contro un'offerta rivale di $0.29 |
| LTX 2.3 | Da testo a video a 1080p | Al secondo | $0.06 al secondo a 1080p |
| Wan 2.6 | Da testo a video | Per lavoro | $0.16 per lavoro |
L'unità di costo è importante quanto il numero. Un prezzo al secondo si adatta a clip di lunghezza variabile e penalizza quelle lunghe, mentre un prezzo per lavoro rende prevedibile una clip di lunghezza fissa e una clip più lunga gratuita. Confronta due modelli con la stessa durata e risoluzione, altrimenti il confronto non significa nulla.
Il tempo di generazione decide se puoi mettere il modello di fronte a una persona. Una clip Kling 3.0 di 5 secondi ha impiegato circa 80 secondi in un test su 29 ottobre 2026, il che è rispettabile per una clip breve e impossibile da nascondere dietro uno spinner senza stato di avanzamento. Una clip di 5 secondi che impiega 80 secondi richiede uno stato visibile, un'attesa stimata e un modo per lasciare la pagina e tornare.
Riduci a due o tre modelli in quest'ordine: prima la modalità, poi la risoluzione e l'audio, quindi la velocità e l'unità di costo con cui puoi convivere. Mantieni almeno un'alternativa nella lista ristretta anche dopo aver scelto un'opzione predefinita. Un modello che si adatta al tuo stile visivo può comunque essere troppo lento per la tua interfaccia, e vuoi che l'alternativa sia già stata testata quando si presenta la necessità. L'elenco completo dei modelli AI disponibili tramite un unico endpoint] è un buon punto di partenza per la selezione, piuttosto che aprire nove account di fornitori.
Costo per Clip Utilizzabile Contro Prezzo Pubblicizzato
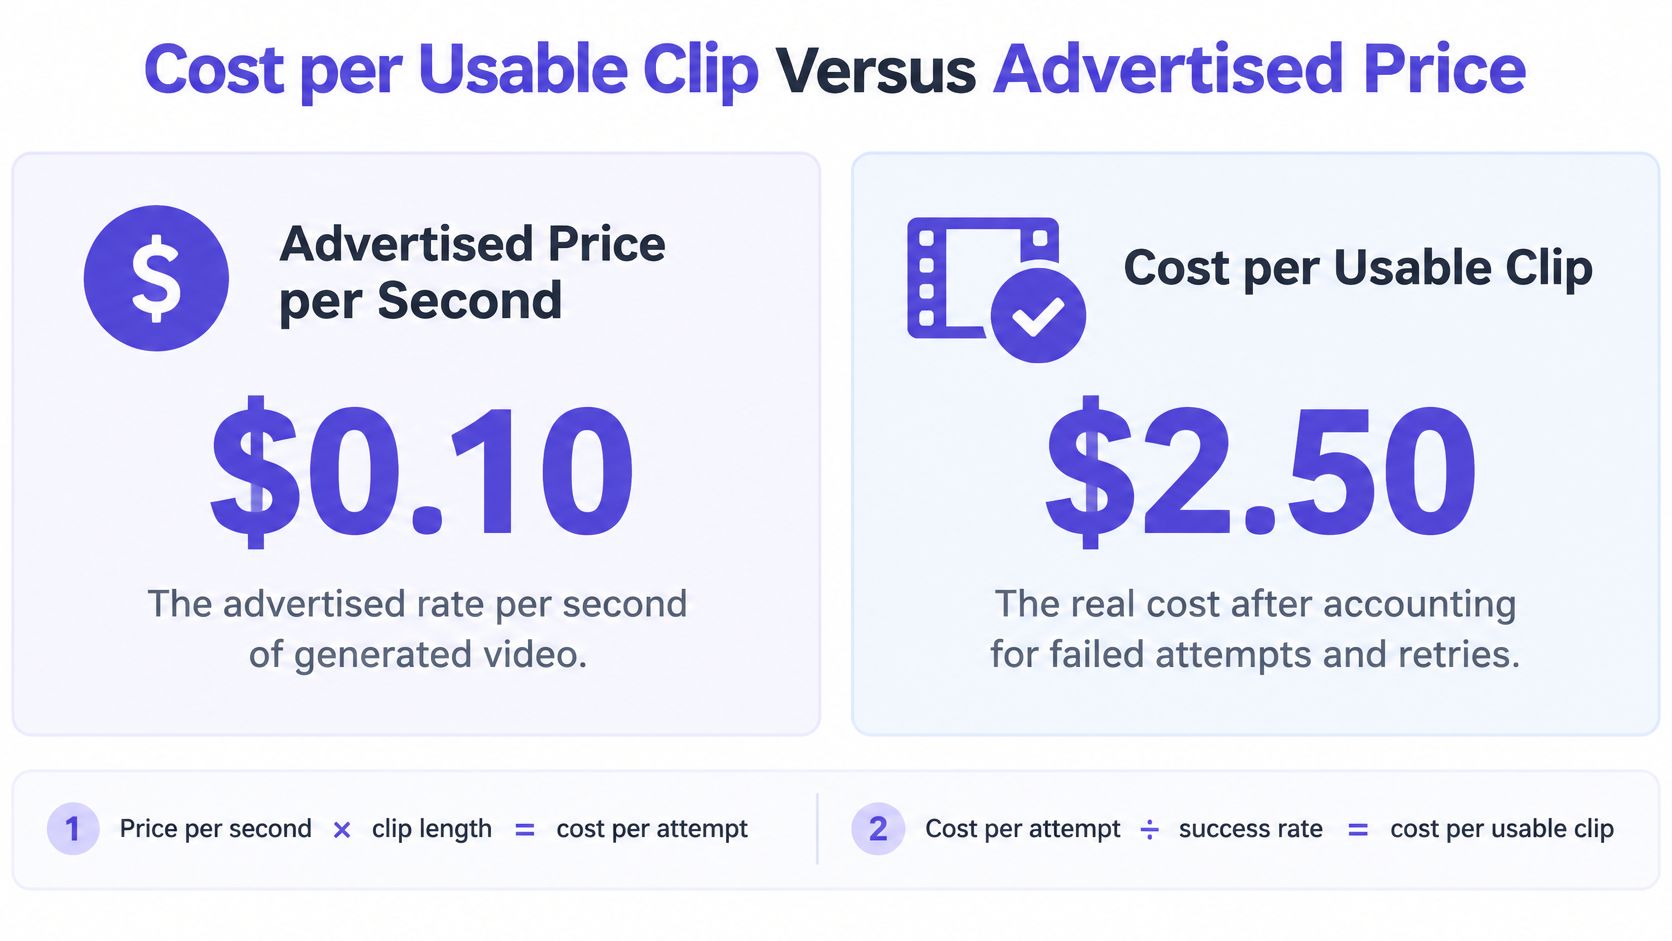
La tariffa pubblicizzata al secondo ti dice quanto costa un tentativo. Non dice nulla su quanto costa una clip utilizzabile, ed è questo il numero che interessa al tuo team finanziario.
Facciamo i conti con un caso concreto. A $0.10 al secondo, una clip di 5 secondi costa $0.50 per tentativo. Se un tentativo su quattro supera i tuoi standard di qualità, la clip accettata costa $2.00. Un concorrente a $0.07 al secondo costa $0.35 per tentativo, e se un tentativo su due è utilizzabile, la clip accettata costa $0.70. Il modello che sembrava più economico vince di quasi tre volte, e la tabella al secondo mostrava la classifica opposta.
Cosa tralasciano le tabelle dei prezzi
Le tariffe pubblicate si aggirano tra circa $0.02 e $1 per secondo generato, secondo il confronto dei prezzi di Runway per le API video AI, e questa differenza è misurata prima dei costi che decidono i budget reali. La stessa analisi rileva che un modello più economico può finire per essere più costoso quando richiede quattro tentativi invece di uno. Aggiungi questi elementi al tuo modello:
- Lavori falliti e moderati. Un rifiuto consuma una richiesta e non restituisce nulla che tu possa usare, quindi appartiene al denominatore del tuo tasso di successo, non al di fuori di esso.
- Tentativi scelti da te. Ogni nuova sottomissione è un altro costo di tentativo, motivo per cui il conteggio dei tentativi appartiene alla formula piuttosto che a una nota separata.
- Impostazioni che modificano la tariffa. Risoluzione e audio cambiano il prezzo al secondo, quindi un benchmark eseguito con le impostazioni predefinite cita un prezzo che potresti non pagare mai.
- Durate predefinite che non hai impostato. Un valore predefinito del provider di 8 secondi quando ne volevi 5 aumenta il costo per clip di 60%.
- Archiviazione e ri-hosting. Un link al risultato è temporaneo. Copiare il file nel tuo bucket fa parte del costo della clip accettata.
Anche le regole di fatturazione modellano l'aritmetica. Un video viene fatturato al suo prezzo finale una volta completata la generazione, e la risposta a una richiesta indica il costo massimo che il lavoro può avere prima che il video inizi, il che ti permette di impostare un limite di budget per lavoro e per tenant. Queste due regole trasformano una vaga stima mensile in un tetto per richiesta che puoi applicare nel codice.
Definisci l'accettazione in modo ristretto. Un lavoro che riporta successo non è una clip utilizzabile. Contala solo quando supera l'aderenza al prompt, mantiene la coerenza temporale, conserva l'identità del soggetto e non mostra errori evidenti di movimento o fisica. Per una ripartizione più completa di come le tariffe al secondo e per lavoro si confrontano tra le diverse rotte, la guida su come funzionano i modelli di prezzo dell'IA copre le unità di fatturazione.
Uno stato di successo significa che il rendering è terminato. Non significa che la clip sia degna di essere spedita, e solo la seconda va nel numeratore.
Campi della Richiesta e Metadati di Output da Verificare
Una richiesta video contiene più di un prompt. Ogni campo seleziona il percorso, influenza il prezzo o decide se un buon risultato può essere riprodotto in seguito. Invia questi sette:
- L'identificatore del modello, che seleziona il percorso del provider. Gli identificatori hanno una struttura, quindi
fal-ai/kling-video/v3/standard/text-to-videocodifica provider, famiglia, versione, livello e modalità in un'unica stringa. Tienilo nella configurazione, mai hard-coded nella logica della richiesta. - Il prompt, e per l'image-to-video l'immagine di riferimento o la sua posizione di caricamento.
- La durata in secondi, perché sia il prezzo che il tempo di generazione scalano con essa.
- Risoluzione e rapporto d'aspetto, poiché entrambi influenzano la tariffa al secondo.
- L'impostazione audio, se il modello supporta l'audio.
- Un seed quando il modello ne accetta uno, in modo che un buon risultato possa essere riprodotto.
- Il tuo ID di richiesta, in modo che il lavoro del provider possa essere ricondotto al tuo record.
Campi di output da archiviare per ogni attività completata
Formato contenitore, codec video, dimensioni, frequenza dei fotogrammi, durata, presenza e codec audio, bitrate, se disponibile, dimensione del file e un URL di contenuto duraturo o un identificatore di oggetto. Archivia i metadati accanto al file, perché il solo file non ti dirà il prossimo trimestre quali impostazioni lo hanno prodotto.
Registra quei metadati invece di assumere che ogni risultato sia equivalente. Due clip della stessa durata possono arrivare con codec diversi, a bitrate diversi, con o senza traccia audio. La specifica W3C WebCodecs definisce le interfacce per la codifica e la decodifica di audio e video senza imporre un codec o un metodo di codifica, quindi nulla garantisce che due rendering tornino nello stesso formato.
Fornisci un profilo MP4 conservativo per browser e app, e conserva il file nativo del provider quando la qualità è importante per una successiva modifica. Quindi convalida prima del successo. Verifica la durata decodificata e il conteggio dei fotogrammi rispetto alla richiesta, perché un file di lunghezza errata è un fallimento anche quando l'API riporta successo. Una clip di 4 secondi quando ne hai chiesti 5 interrompe una timeline con la stessa gravità di un lavoro fallito, ed è molto più difficile da notare.
Integrare la generazione video nel codice SDK esistente
Un'integrazione testuale esistente si adatta senza bisogno di riscrittura. Mantieni testo e video su route separate in modo che entrambi possano condividere una API key, un base URL e un saldo, e lascia il wrapper SDK al suo posto. Spostare un client compatibile con OpenAI o Anthropic è un cambiamento di endpoint e credenziali, e cambiare modello è un cambiamento di identificatore.
Quattro parti di un servizio video leggero
Una funzione di creazione valida l'input, chiama la route di generazione e restituisce immediatamente il tuo ID di lavoro interno. I tuoi chiamanti non vedono mai un ID del provider, il che rende un successivo failover invisibile a loro.
Una tabella dei lavori mappa gli ID interni agli ID di lavoro del provider, stato, route, timestamp e metadati di output. Trattala come la fonte di verità per la riconciliazione della fatturazione, non la dashboard del provider.
Un worker effettua polling o riceve webhook, avanza la macchina a stati e applica le regole di retry e deadline che hai definito. Un solo worker gestisce entrambi i segnali, quindi un evento mancato e un polling lento convergono sullo stesso percorso di codice.
Un passaggio di archiviazione copia il file MP4 finito nel tuo bucket, calcola un checksum e scrive la riga dei metadati. Questo è il passaggio che i team saltano e poi ricostruiscono dopo il loro primo link scaduto.
Limita ogni API key a un solo ambiente e mantieni le chiavi revocabili, in modo che una chiave di staging trapelata non possa raggiungere la capacità di produzione. Per immagini sorgente o file video di grandi dimensioni, carica tramite un URL firmato anziché incorporare i byte nel corpo della richiesta, poiché un payload JSON di diversi megabyte è di per sé una modalità di fallimento.
Poi esegui il test che un ingegnere senior ti chiederà. Invia una richiesta che vada in timeout sul client e conferma che il sistema termina con esattamente un'attività memorizzata, un download finale e nessuna sottomissione duplicata. Se quel test passa, il resto dell'integrazione è un dettaglio.
Errori di produzione e come prevenire i duplicati
Un'API di generazione non è una chiamata di funzione, e trattarla come tale è la causa dei duplicati. Con un'API di testo sincrona, un timeout significa quasi sempre che il lavoro non è mai avvenuto. Con il video, un timeout significa solo che hai smesso di ascoltare. Il lavoro potrebbe essere ancora in coda, ancora in esecuzione e ancora in procinto di addebitarti il suo prezzo finale nel momento in cui viene completato. L'immagine qui sotto mostra la versione operativa di questa idea: una pipeline che si ripara da sola, con qualcuno che ne è responsabile, piuttosto che una coda che nessuno controlla.
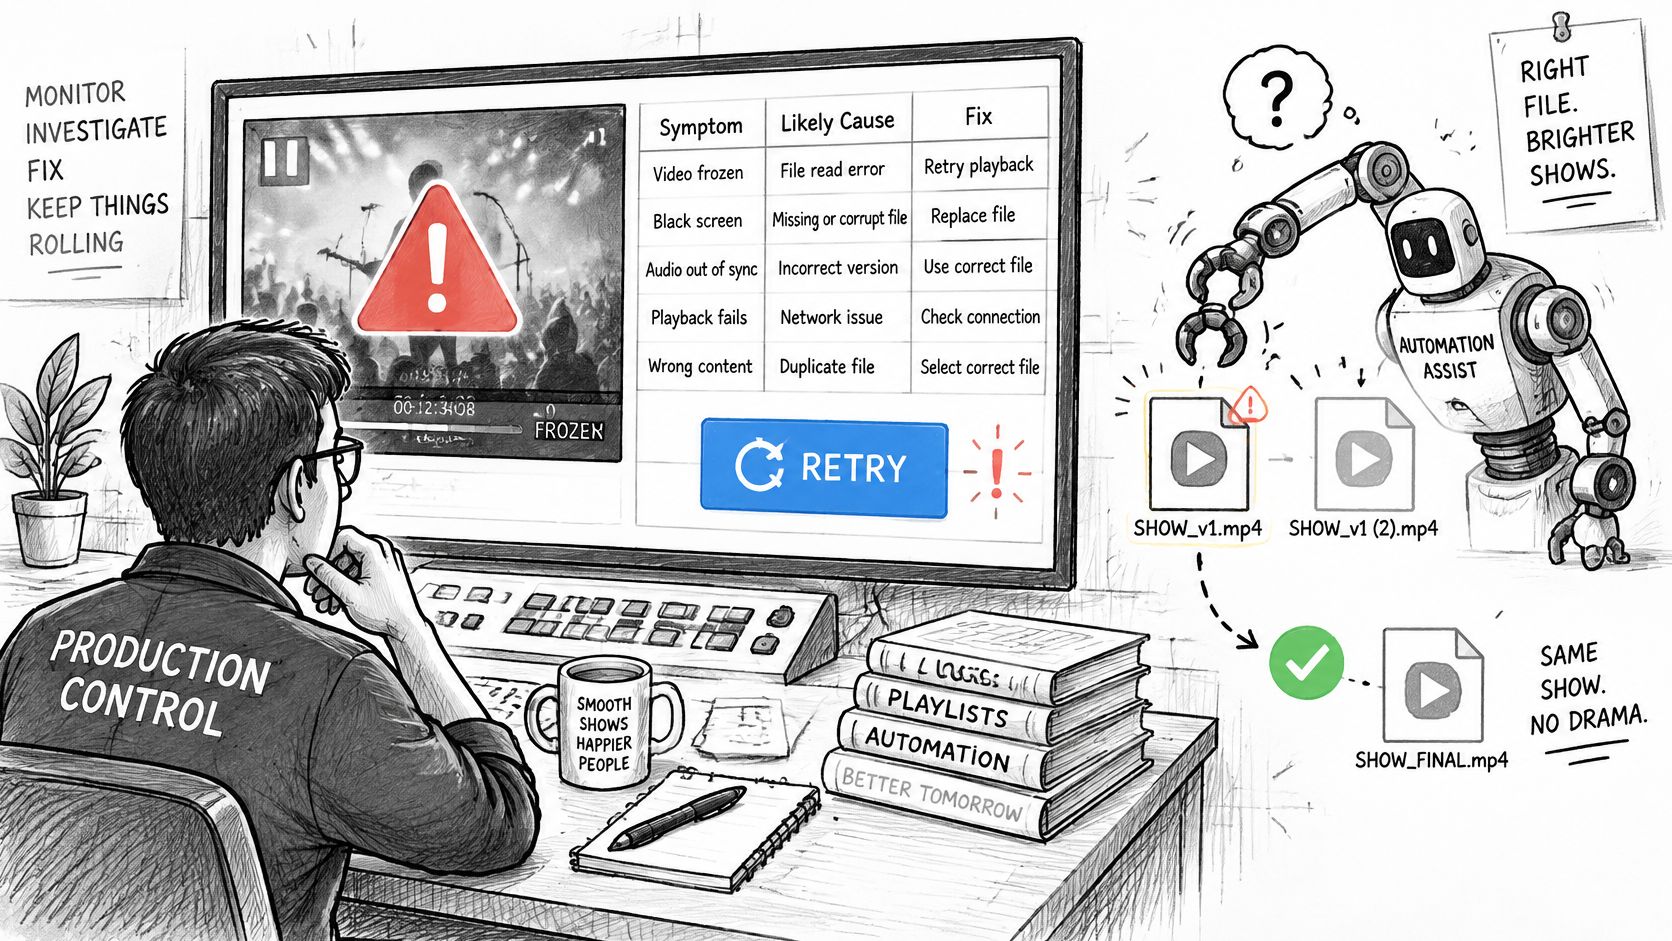
Sette sintomi spiegano la maggior parte dei bug di integrazione video, e ognuno corrisponde a una causa e una soluzione.
| Sintomo | Causa probabile | Soluzione |
|---|---|---|
| Webhook non arriva mai | Errore di consegna o timeout dell'endpoint | Effettua il polling dell'ID del job dopo una scadenza e riconcilia lo stato |
| Stesso clip creato o fatturato due volte | Nuovo tentativo di una generazione non idempotente | Invia una chiave di idempotenza per richiesta utente e riutilizza l'ID del job memorizzato |
| Il job segnala successo ma il file ha una lunghezza errata | Validazione dell'output saltata | Controlla la durata decodificata e il conteggio dei frame prima di contrassegnare il successo |
| Il rifiuto della moderazione sembra un errore generico | Il filtro di sicurezza ha interrotto il job | Leggi il codice di errore, cambia il prompt, non riprovare lo stesso input |
| Il download fallisce ore dopo | L'URL del risultato è scaduto | Scarica immediatamente, memorizza il file con un checksum e archivialo |
| Lo stile dell'output cambia dopo il failover | Un modello o un venditore diverso ha gestito il job | Fissa il modello per i clip corrispondenti ed esegui il failover solo tra equivalenti testati |
| Molte richieste sembrano lente | Limite di velocità o attesa in coda | Tieni traccia del tempo di coda separatamente dal tempo di generazione e imposta scadenze per ogni job |
Perché il failover automatico può costarti denaro
Il failover è un'abitudine del testo che non si trasferisce in modo pulito al video. Su un endpoint di chat, riprovare una richiesta in timeout è economico e la risposta è identica in entrambi i casi. Su un endpoint video, ogni nuova sottomissione è un nuovo job fatturabile con un prezzo per secondo di output, e un reindirizzamento a un modello diverso può cambiare il movimento, la coerenza dell'identità, i risultati di sicurezza o la durata del clip. I report comparativi sulle migliori API di generazione video AI indicano i limiti di concorrenza, i limiti di velocità, il comportamento della coda e gli outlier lenti come le grandi differenze tra i provider, e la latenza media nasconde esattamente i ritardi di coda che rompono i prodotti interattivi.
Quindi, tratta i nuovi tentativi e il failover come rischi di spesa e coerenza, non come reti di sicurezza gratuite. Ogni sottomissione duplicata aumenta il tuo costo per clip accettato senza aumentare l'accettazione. Fissa il modello per qualsiasi serie di clip che devono corrispondere, e consenti il failover solo tra modelli che hai testato come equivalenti sui tuoi prompt. Tratta un rifiuto di moderazione come un risultato piuttosto che un errore transitorio: leggi il codice, cambia il prompt e non reinviare automaticamente lo stesso input.
La modalità di errore che coglie di sorpresa i team esperti è più sottile: un job può raggiungere il successo dopo che la tua richiesta client è già andata in timeout. Se invii nuovamente invece di riconciliare il job memorizzato, paghi lo stesso clip due volte. I link ai risultati sono anche temporanei e possono scadere, quindi scarica immediatamente il file finito, memorizzalo con un checksum e scrivi la riga dell'archivio. Questo passaggio è un controllo, non una semplice gestione. UberLLM conserva i file dei risultati per circa 3 ore dopo che un job video o musicale è terminato, il che è abbastanza lungo per un ciclo di retry ma non abbastanza lungo da sostituire il tuo bucket.
La fatturazione esattamente una volta è composta da parti, ognuna piccola di per sé: una chiave di idempotenza per richiesta utente, stato del task duraturo, webhook verificati, polling di riconciliazione dopo una scadenza, checksum sui media completati e archiviazione immutabile di ogni file finito. Salta uno qualsiasi di questi e qualche caso limite alla fine troverà la falla.
La regola del primo giorno: ogni job video deve avere uno stato memorizzato che puoi riconciliare senza addebitare o inviare nuovamente il lavoro. Se non puoi rispondere "quanto è costato questo job e lo abbiamo consegnato" dal tuo database, l'integrazione non è completa.
Esegui un benchmark del modello prima di impegnarti
Puoi definire la scelta del modello con un test che si completa in un pomeriggio. Scegli un modello predefinito e uno sfidante con un'unità di costo o un profilo di velocità diversi. Kling 3.0 Standard è un primo modello predefinito pratico per text to video e image to video, e Veo 3.1 Fast è un utile sfidante in termini di costi. Poi:
- Riusa i prompt fissi, la durata, la risoluzione, l'impostazione audio e la regola di accettazione dal tuo modello di costo. Input identici sono l'unico modo per cui un confronto abbia senso.
- Esegui almeno 10 job per modello, abbastanza da vedere un tasso di fallimento piuttosto che un'esecuzione fortunata.
- Riporta solo quattro numeri: tasso di successo, latenza mediana, latenza di coda e costo per clip accettata.
- Controlla la tariffa sulla rotta che chiamerai. Per lo stesso profilo text to video a 1080p senza audio, Veo 3.1 Fast costa $0.075 al secondo su UberLLM contro $0.10 al secondo su fal.ai, e differenze di quella dimensione cambiano quale modello vince.
- Mantieni la logica separata: le richieste video vanno a
/v1/video/generationse le richieste chat rimangono su/v1/chat/completions, anche quando una singola API key e un singolo base URL coprono entrambi.
Cambiare candidato è un cambiamento dell'identificatore del modello, quindi il benchmark ti costa prompt e tempo, non una migrazione. Scegli la rotta con il costo per clip accettata più basso che soddisfi comunque la tua latenza e i tuoi standard di qualità, fissala per qualsiasi serie che debba corrispondere, e riesegui lo stesso set di 10 job ogni mese man mano che prezzi e condizioni della coda cambiano.
UberLLM instrada la generazione video tra i provider dietro un unico endpoint compatibile con OpenAI e Anthropic, così puoi inviare un job una volta sola e lasciare che il gateway gestisca il fornitore, l'ID del job e il contratto di callback. I modelli text to video, image to video e di upscaling si affiancano ai tuoi modelli di chat sulla stessa chiave e saldo prepagato, e le generazioni fallite non vengono addebitate. Punta il tuo prossimo benchmark video a UberLLM e confronta il costo per clip accettata piuttosto che il costo al secondo.