API de Generación de Video con IA: Trabajos, Modelos y Costos
Aprende cómo funciona una API de generación de video con IA, desde trabajos asíncronos y webhooks hasta la elección del modelo, las verificaciones de salida y el costo real por clip utilizable.
Tu finalización de chat se devuelve en 400 milisegundos, así que conectas el video de la misma manera: un POST, esperas, recoges los bytes. Cuatro minutos después la conexión se agota, el clip termina de todos modos, y has pagado por un trabajo que nadie recogió.
Esa brecha es donde la mayoría de los proyectos de API de generación de video con IA salen mal. La documentación hace que el video parezca un modelo de chat más lento, y las tablas de precios te empujan a comparar céntimos por segundo como si un segundo de metraje generado fuera una unidad que siempre puedes conservar. El mercado se está expandiendo lo suficientemente rápido como para que el error escala. Research and Markets valoró el mercado global de generadores y editores de video con IA en USD 623 millones en 2024 y proyecta USD 3.51 mil millones para 2034 con una tasa de crecimiento anual compuesta del 18.64% (Research and Markets, diciembre de 2024).
La pregunta útil no es qué API es la más barata por segundo. Es cuánto cuesta un clip utilizable, descargado y archivado después de los fallos, los reintentos y el modelo que necesitó cuatro intentos.
Tabla de Contenidos
- Capacidades de Generación de Video y Tipos de Solicitud
- Cómo un Trabajo de Video Pasa de la Envío al Archivo
- Polling o Webhooks para Resultados de Video Terminados
- Elección de un Modelo de Video por Caso de Uso
- Costo por Clip Utilizable Versus Precio Anunciado
- Campos de Solicitud y Metadatos de Salida a Verificar
- Integración de la Generación de Video en el Código SDK Existente
- Fallos de Producción y Cómo Prevenir Duplicados
- Ejecuta un Benchmark de Modelo Antes de Comprometerte
Capacidades de generación de video y tipos de solicitud
Una respuesta de chat es un mensaje. Un job de video es un archivo que llega más tarde, y el tipo de solicitud que elijas decide qué tiene que inventar el proveedor y qué te devuelve.
Text to video es la forma más pura. Envías un prompt y un model identifier, y el modelo genera cada píxel a partir de la descripción. Image to video añade una imagen de referencia, de modo que el sujeto, el encuadre y la iluminación provienen de la imagen, mientras que el prompt proporciona el movimiento. Ese único cambio elimina la mayor parte de la desviación de identidad que hace que los clips solo de texto sean inutilizables para tomas de productos y trabajos de personajes.
| Tipo de solicitud | Entrada | Ejecución | Salida |
|---|---|---|---|
| Text to video | Text prompt y model identifier | Asynchronous job | Nuevo clip MP4 |
| Image to video | Imagen de referencia y prompt | Asynchronous job | Clip MP4 anclado a la imagen |
| Video upscaling | Archivo de video existente | Asynchronous job | MP4 de mayor resolución |
| Video con audio | Prompt más configuración de audio | Asynchronous job | MP4 con una pista de audio donde el modelo lo soporte |
Video upscaling es el único tipo donde el contenido es fijo y solo cambia la resolución, por lo que es el más fácil de presupuestar y el más difícil de equivocarse. El audio se divide en dos. Algunos modelos devuelven una banda sonora junto con la imagen cuando activas el audio, mientras que la música y los efectos de sonido son modalidades separadas que utilizan la misma forma de solicitud y la misma mecánica de trabajo.
Tres entradas aparecen en cada fila: el prompt o el medio de origen, el model identifier, y la longitud y resolución que deseas. Incorpora esos tres a tu propio request schema desde el principio y el cambio de proveedores más tarde se convertirá en un cambio de configuración.
Establece la expectativa de tiempo antes de construir nada. Una respuesta de chat llega en segundos, mientras que una solicitud de video se acepta primero y finaliza más tarde, con una ejecución típica que toma entre 30 segundos y varios minutos. La respuesta que recibes inmediatamente es un job, no un clip.
Cómo un trabajo de video avanza desde la solicitud hasta el archivo
Cada API de video lista para producción sigue un patrón, y es el patrón que OpenAI documenta en su guía de API de video: crear un trabajo, leer su estado y luego obtener el contenido una vez que el estado alcanza un estado terminal de éxito. Modele ese flujo como un sistema de trabajos asíncrono, nunca como una descarga de medios síncrona.
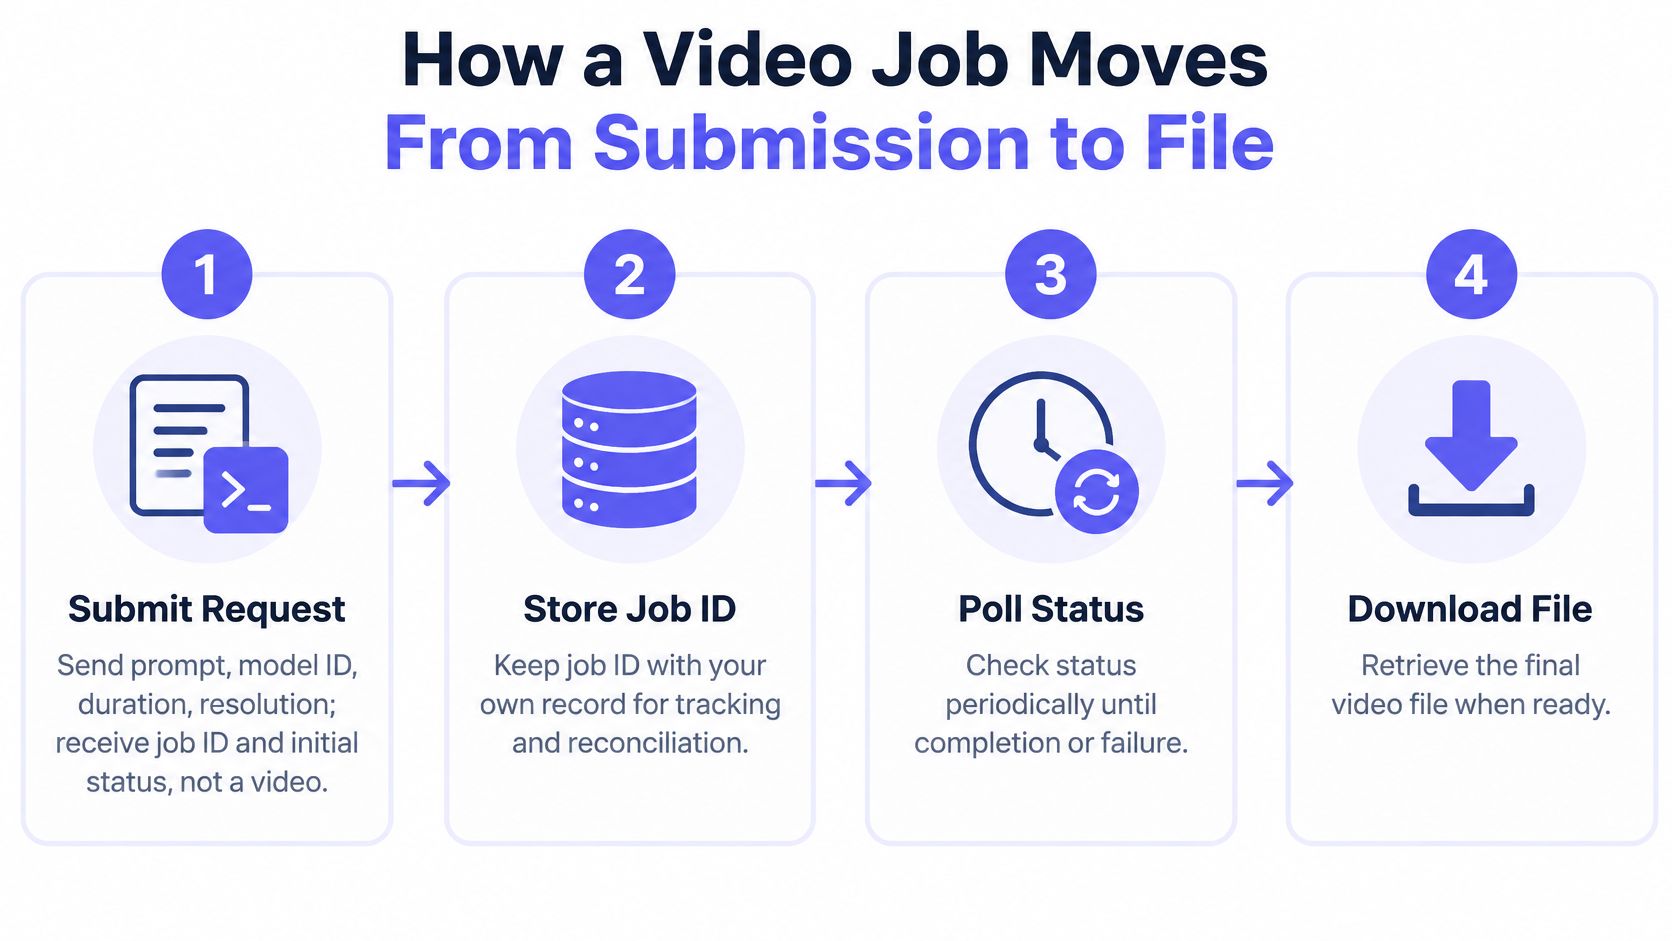
- Envíe la solicitud. Envíe el prompt, el identificador del modelo, la duración y la resolución. La respuesta contiene un job ID y un estado inicial como queued. Guárdelo antes de hacer cualquier otra cosa, porque un reinicio del proceso de lo contrario perdería el único identificador del trabajo por el que ya ha pagado.
- Asocie el job ID a su propio registro. Conserve su ID de solicitud interno, el usuario o inquilino al que pertenece, los parámetros que envió y la ruta del vendedor o proveedor. Cuando una pregunta de facturación llegue tres días después, esta fila es la respuesta.
- Observe el recurso de estado. Póllelo o espere un evento, y registre cada transición con una marca de tiempo. Queued, running, succeeded, failed. La brecha entre queued y running es queue wait, y es el número que explica las quejas de "modelo lento" que no tienen nada que ver con el modelo.
- Espere un estado terminal. Éxito y fallo son ambos terminales. Un timeout no lo es, y tampoco lo es una conexión perdida, así que nunca trate ninguno de los dos como un resultado.
- Obtenga el archivo solo en caso de éxito. Solicite la ubicación del contenido, haga streaming a su propio almacenamiento y registre el checksum. Hacer esto en el momento del fallo desperdicia llamadas y puede enmascarar un error real como un problema de descarga.
- Lea el error en caso de fallo. Decida si la solución es un parámetro cambiado, un modelo diferente o un mensaje al usuario. Volver a enviar parámetros idénticos después de un rechazo de contenido solo quema dinero.
Cómo se ven los logs de trabajos saludables
Un job ID, una ejecución limpia de queued a running a succeeded, y exactamente una descarga. Cualquier otra cosa en el log es un bug que puede medir: dos descargas significan un webhook duplicado que no deduplicó, y un éxito registrado después de que su cliente se rindió significa que necesita reconciliación.
Defina cancellation, timeout, retry y expiration en su propio registro de trabajo. Esas semánticas pertenecen a su gateway, no a cualquier upstream que haya renderizado el clip. Si el llamador se desconecta a mitad de la renderización, deje que el trabajo termine y reconcílíelo más tarde. La cancelación es un cambio de estado explícito que usted envía, no una conexión HTTP que se cierra por casualidad.
Polling o Webhooks para Resultados de Video Finalizados
Ambas señales responden a la misma pregunta y difieren en quién realiza el seguimiento. Polling significa que tu código lee repetidamente el recurso de estado hasta que la tarea alcanza un estado terminal. Webhooks significa que el proveedor te llama con un evento completado o fallido, y tu endpoint reacciona.
| Pregunta | Polling | Webhooks |
|---|---|---|
| Cómo te enteras del resultado | Lecturas de estado repetidas hasta el estado terminal | Un evento completado o fallido |
| Cuándo te das cuenta | En el siguiente intervalo | Cuando se entrega el evento |
| Carga adicional | Una llamada de estado por intervalo | Casi ninguna, más una reconciliación rara |
| Mejor ajuste | Renderizado por lotes y una primera construcción sencilla | Generación de larga duración, impulsada por eventos |
| Fallo principal | La detección espera el intervalo | Entrega perdida o duplicada |
| Control de seguridad | Retroceder de aproximadamente 15 segundos hacia 60 segundos | Verificar la firma, persistir por ID de tarea, tratar la entrega como al menos una vez, omitir una descarga y facturación repetidas |
Para generaciones medidas en minutos, los eventos ganan tanto en costo como en latencia. El volumen de solicitudes de sondear cada tarea cada pocos segundos se acumula en una cola, y el mismo tráfico retrasa tu detección hasta el siguiente intervalo. La comparación de webhooks con el polling directo de API establece dónde encaja cada patrón.
Construye el manejador con cinco comprobaciones en este orden:
- Verificar la firma cuando el proveedor la suministre, y rechazar las entregas sin firmar en el borde.
- Persistir el evento contra el ID de tarea del proveedor antes de que se ejecute cualquier trabajo de descarga, facturación o notificación.
- Asumir la entrega al menos una vez, porque el mismo evento completado puede llegar legítimamente dos veces.
- Hacer que el manejador sea idempotente, para que una segunda entrega vea un estado terminal almacenado y omita la descarga y el cargo.
- Manejar el evento fallido como un resultado real, no como un tiempo de espera para ser reintentado ciegamente.
Luego añade la red de seguridad. Si ningún evento llega antes de un plazo establecido a partir de tu latencia medida, sondea el ID de tarea con retroceso, comenzando alrededor de 15 segundos y extendiéndose hacia 60 segundos. Prueba ambas rutas de fallo antes del lanzamiento: fuerza un evento duplicado, luego suprime un evento por completo, y confirma que el usuario termina con un video y un cargo.
Regla práctica: un webhook es una optimización para el camino feliz. Tu sondeo de reconciliación es lo que hace que el sistema sea correcto.
Elegir un modelo de vídeo por caso de uso
Preselecciona candidatos según cinco criterios antes de mirar una tabla de clasificación: la modalidad que necesitas, la duración y resolución máximas, el soporte de audio, el tiempo de generación medido y la unidad de coste que factura el proveedor. Esos cinco eliminan la mayor parte de las opciones más rápido que cualquier clasificación de calidad.
| Familia de modelos | Modalidad | Unidad de coste a comparar | Tiempo o precio conocido |
|---|---|---|---|
| Kling 3.0 Standard | Texto e imagen a vídeo | Por segundo | Aproximadamente 80 segundos para un clip de 5 segundos |
| Veo 3.1 Fast | Texto a vídeo | Por segundo a 1080p sin sonido | Registra la latencia en tu propia prueba, ya que la carga de la cola la modifica |
| Veo 3.1 Full | Texto a vídeo | Por trabajo | $0.22 por trabajo frente a un precio de lista de $0.44 |
| Seedance 2.0 Fast | Imagen a vídeo a 480p, 5 segundos | Por clip | $0.35 por clip frente a una oferta rival de $0.29 |
| LTX 2.3 | Texto a vídeo a 1080p | Por segundo | $0.06 por segundo a 1080p |
| Wan 2.6 | Texto a vídeo | Por trabajo | $0.16 por trabajo |
La unidad de coste importa tanto como el número. Un precio por segundo se adapta a clips de duración variable y penaliza los largos, mientras que un precio por trabajo hace que un clip de duración fija sea predecible y un clip más largo sea gratuito. Compara dos modelos con la misma duración y resolución o la comparación no significa nada.
El tiempo de generación decide si puedes poner el modelo frente a una persona. Un clip de Kling 3.0 de 5 segundos tardó aproximadamente 80 segundos en una prueba en 29 de octubre de 2026, lo cual es respetable para un clip corto e imposible de ocultar detrás de un spinner sin estado de progreso. Un clip de 5 segundos que tarda 80 segundos necesita un estado visible, una espera estimada y una forma de salir de la página y volver.
Limita la selección a dos o tres modelos en este orden: primero la modalidad, luego la resolución y el audio, y después la velocidad y la unidad de coste con las que puedas vivir. Mantén al menos una alternativa en la preselección incluso después de elegir una por defecto. Un modelo que se adapte a tu estilo visual aún puede ser demasiado lento para tu interfaz, y querrás tener la alternativa ya evaluada cuando eso ocurra. La lista completa de modelos de IA disponibles a través de un único endpoint es un lugar razonable para empezar la preselección en lugar de abrir nueve cuentas de proveedor.
Costo por clip utilizable versus precio anunciado
La tarifa anunciada por segundo te dice cuánto cuesta un intento. No dice nada sobre cuánto cuesta un clip utilizable, y ese es el número que le importa a tu equipo de finanzas.
Hagamos los cálculos con un caso concreto. A $0.10 por segundo, un clip de 5 segundos cuesta $0.50 por intento. Si uno de cada cuatro intentos supera tu estándar de calidad, el clip aceptado cuesta $2.00. Un rival a $0.07 por segundo cuesta $0.35 por intento, y si uno de cada dos intentos es utilizable, el clip aceptado cuesta $0.70. El modelo que parecía más barato gana por casi tres veces, y la tabla por segundo mostraba la clasificación opuesta.
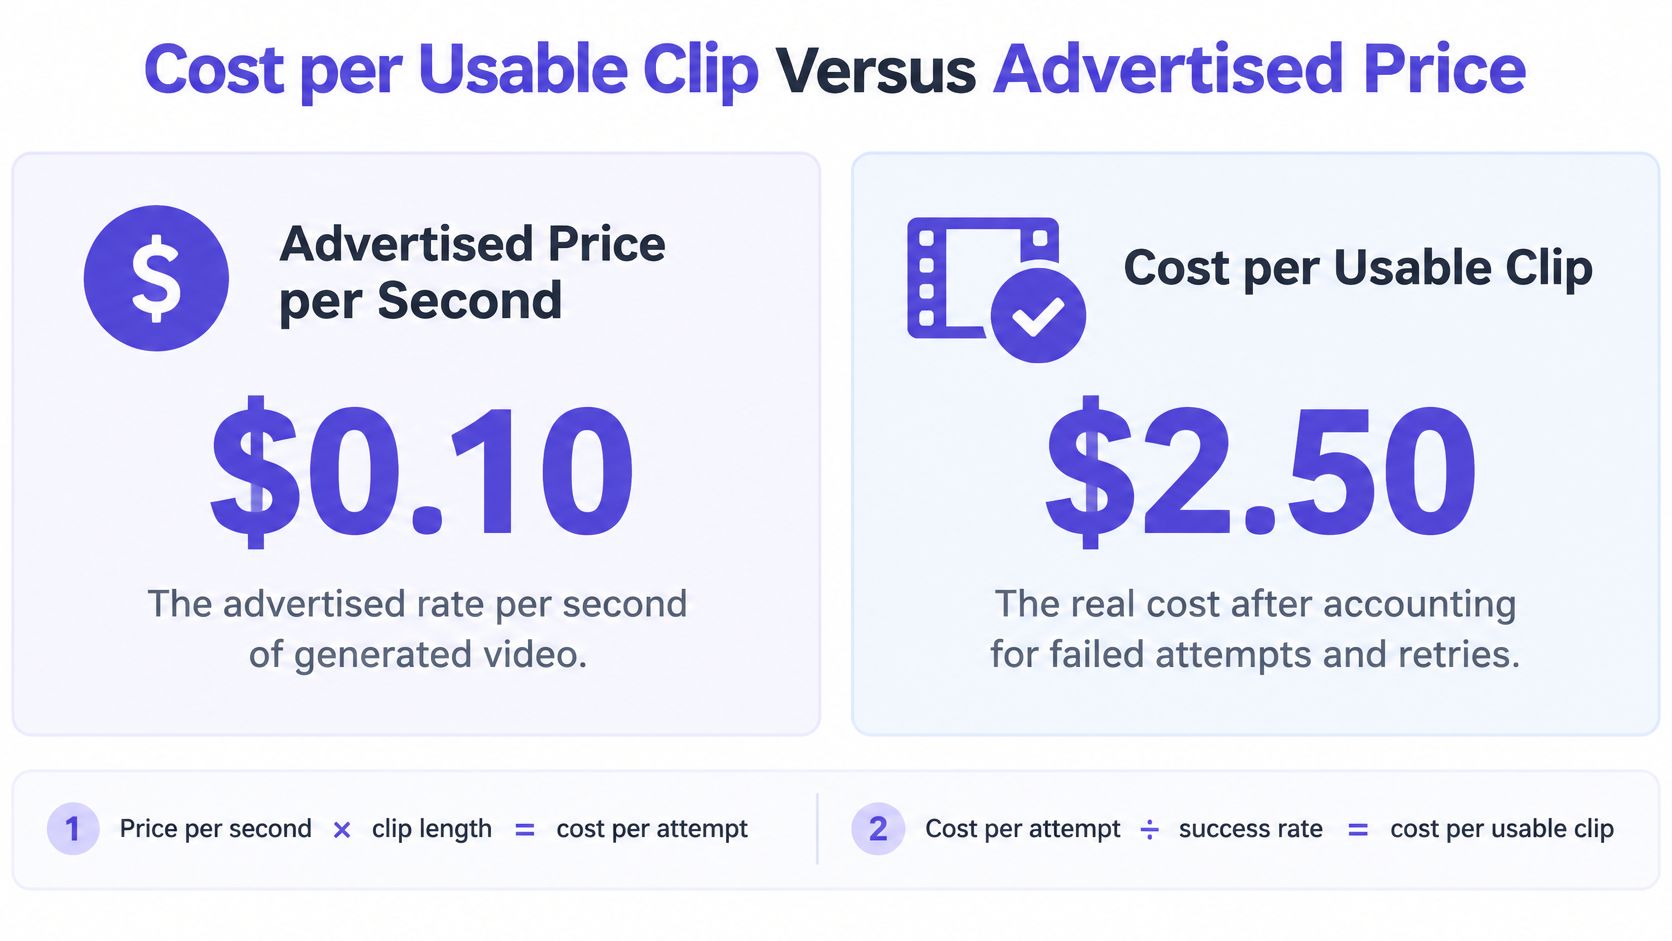
Lo que las tablas de precios omiten
Las tarifas publicadas se agrupan entre aproximadamente $0.02 y $1 por segundo generado, según la comparación de precios de Runway para APIs de video con IA, y esa diferencia se mide antes de los costos que deciden los presupuestos reales. El mismo análisis señala que un modelo más barato puede terminar siendo más caro cuando necesita cuatro intentos en lugar de uno. Añade estos a tu modelo:
- Trabajos fallidos y moderados. Un rechazo consume una solicitud y no devuelve nada que puedas usar, por lo que pertenece al denominador de tu tasa de éxito, no fuera de él.
- Reintentos que elegiste. Cada reenvío es otro costo de intento, por lo que el recuento de intentos pertenece a la fórmula en lugar de a una nota separada.
- Configuraciones que modifican la tarifa. La resolución y el audio cambian el precio por segundo, por lo que una prueba de rendimiento ejecutada con la configuración predeterminada cita un precio que quizás nunca pagues.
- Duraciones predeterminadas que no configuraste. Un valor predeterminado del proveedor de 8 segundos cuando querías 5 aumenta el costo por clip en 60%.
- Almacenamiento y re-alojamiento. Un enlace de resultado es temporal. Copiar el archivo a tu propio bucket es parte del costo del clip aceptado.
Las reglas de facturación también dan forma a los cálculos. Un video se factura a su precio final una vez que la generación se completa, y la respuesta a una solicitud indica lo máximo que puede costar el trabajo antes de que el video comience, lo que te permite establecer un límite de presupuesto por trabajo y por inquilino. Esas dos reglas convierten una estimación mensual vaga en un límite por solicitud que puedes aplicar en el código.
Define la aceptación de forma estricta. Un trabajo que reporta éxito no es un clip utilizable. Cuéntalo solo cuando pase la adherencia al prompt, mantenga la consistencia temporal, conserve la identidad del sujeto y no muestre errores obvios de movimiento o física. Para un desglose más completo de cómo se comparan las tarifas por segundo y por trabajo en las diferentes rutas, la guía sobre cómo funcionan los modelos de precios de IA cubre las unidades de facturación.
Un estado de éxito significa que el renderizado terminó. No significa que el clip valga la pena enviar, y solo el segundo va en el numerador.
Campos de solicitud y metadatos de salida a verificar
Una solicitud de video conlleva más que un prompt. Cada campo selecciona la ruta, modifica el precio o decide si un buen resultado puede reproducirse más tarde. Envía estos siete:
- El identificador del modelo, que selecciona la ruta del proveedor. Los identificadores tienen estructura, por lo que
fal-ai/kling-video/v3/standard/text-to-videocodifica el proveedor, la familia, la versión, el nivel y la modalidad en una sola cadena. Mantenlo en la configuración, nunca codificado directamente en la lógica de la solicitud. - El prompt, y para imagen a video, la imagen de referencia o su ubicación de carga.
- Duración en segundos, porque tanto el precio como el tiempo de generación escalan con ella.
- Resolución y relación de aspecto, ya que ambas influyen en la tarifa por segundo.
- La configuración de audio, cuando el modelo soporta audio.
- Una semilla cuando el modelo la acepta, para que un buen resultado pueda reproducirse.
- Tu propio ID de solicitud, para que el trabajo del proveedor se asigne a tu registro.
Campos de salida a almacenar con cada tarea completada
Formato de contenedor, códec de video, dimensiones, velocidad de fotogramas, duración, presencia y códec de audio, bitrate cuando esté disponible, tamaño de archivo y una URL de contenido duradera o identificador de objeto. Almacena los metadatos junto al archivo, porque el archivo por sí solo no te dirá el próximo trimestre qué configuraciones lo produjeron.
Registra esos metadatos en lugar de asumir que cada resultado es equivalente. Dos clips con la misma duración pueden llegar en diferentes códecs, a diferentes bitrates, con o sin una pista de audio. La especificación WebCodecs de W3C define las interfaces para codificar y decodificar audio y video sin exigir un códec o un método de codificación, por lo que nada garantiza que dos renders regresen en el mismo formato.
Entrega un perfil MP4 conservador para navegadores y aplicaciones, y conserva el archivo nativo del proveedor cuando la calidad sea importante para una edición posterior. Luego, valida antes del éxito. Comprueba la duración decodificada y el recuento de fotogramas con respecto a la solicitud, porque un archivo de longitud incorrecta es un fallo incluso cuando la API informa éxito. Un clip de 4 segundos cuando pediste 5 rompe una línea de tiempo tan gravemente como un trabajo fallido, y es mucho más difícil de notar.
Integrando la generación de video en el código SDK existente
Una integración de texto existente se adapta sin necesidad de reescribir código. Mantén el texto y el video en rutas separadas para que ambos puedan compartir una API key, una base URL y un balance, y deja el SDK wrapper en su lugar. Mover un cliente compatible con OpenAI o Anthropic es un cambio de endpoint y credenciales, y cambiar de modelos es un cambio de identificador.
Cuatro partes de un servicio de video ligero
Una función de creación valida la entrada, llama a la ruta de generación e inmediatamente devuelve tu propio ID de trabajo interno. Tus llamadores nunca ven un ID de proveedor, lo que hace que un failover posterior sea invisible para ellos.
Una tabla de trabajos mapea los ID internos a los ID de trabajo del proveedor, estado, ruta, marcas de tiempo y metadatos de salida. Trátala como la fuente de verdad para la conciliación de facturación, no como el panel de control del proveedor.
Un worker sondea o recibe webhooks, avanza la máquina de estados y aplica las reglas de reintento y plazo que definiste. Un solo worker maneja ambas señales, por lo que un evento perdido y un sondeo lento convergen en la misma ruta de código.
Un paso de almacenamiento copia el MP4 terminado en tu propio bucket, calcula un checksum y escribe la fila de metadatos. Este es el paso que los equipos suelen omitir y luego reconstruyen después de su primer enlace caducado.
Limita cada API key a un entorno y mantén las claves revocables, para que una clave de staging filtrada no pueda acceder a la capacidad de producción. Para imágenes o archivos de video de origen grandes, sube a través de una URL firmada en lugar de incrustar bytes en el cuerpo de la solicitud, ya que una carga JSON de varios megabytes es su propio modo de fallo.
Luego, ejecuta la prueba que un ingeniero senior te preguntará. Envía una solicitud que agote el tiempo de espera en el cliente y confirma que el sistema termina con exactamente una tarea almacenada, una descarga eventual y ninguna presentación duplicada. Si esa prueba pasa, el resto de la integración es un detalle.
Fallos de Producción y Cómo Prevenir Duplicados
Una API de generación no es una llamada a función, y tratarla como tal es el origen de los duplicados. Con una API de texto síncrona, un timeout casi siempre significa que el trabajo nunca se realizó. Con el vídeo, un timeout solo significa que dejaste de escuchar. El trabajo puede seguir en cola, seguir ejecutándose y seguir a punto de facturarte su precio final en el momento en que se complete. La imagen de abajo muestra la versión operativa de esa idea: un pipeline que se repara a sí mismo, con alguien a cargo, en lugar de una cola que nadie vigila.
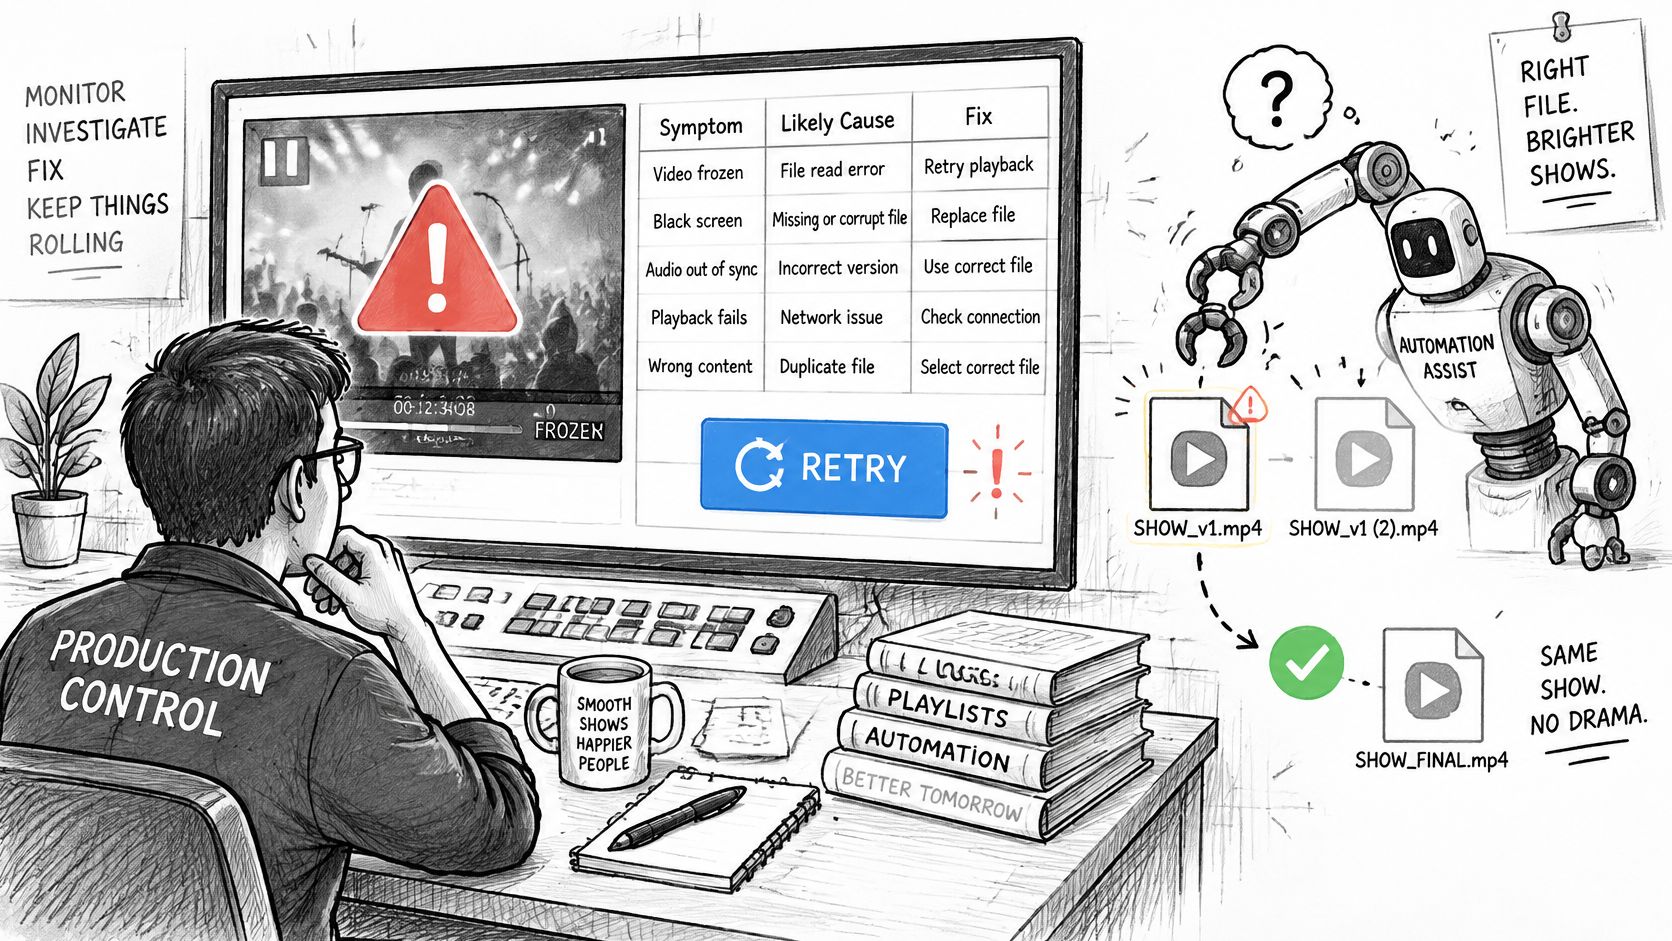
Siete síntomas explican la mayoría de los errores de integración de vídeo, y cada uno se corresponde con una causa y una solución.
| Síntoma | Causa probable | Solución |
|---|---|---|
| Webhook nunca llega | Fallo de entrega o timeout del endpoint | Consulta el job ID después de un plazo y concilia el estado |
| Mismo clip creado o facturado dos veces | Reintento de una generación no idempotente | Envía una idempotency key por solicitud de usuario y reutiliza el job ID almacenado |
| El trabajo informa de éxito pero el archivo tiene una longitud incorrecta | Validación de salida omitida | Comprueba la duración decodificada y el recuento de fotogramas antes de marcar el éxito |
| El rechazo por moderación parece un fallo genérico | El filtro de seguridad detuvo el trabajo | Lee el error code, cambia el prompt, no reintentes la misma entrada |
| La descarga falla horas después | La Result URL ha caducado | Descarga inmediatamente, almacena el archivo con un checksum y archívalo |
| El estilo de salida cambia después del failover | Un modelo o vendedor diferente sirvió el trabajo | Fija el modelo para los clips que deben coincidir y haz failover solo entre equivalentes probados |
| Muchas solicitudes parecen lentas | Rate limit o espera en cola | Rastrea el queue time por separado del generation time y establece plazos por trabajo |
Por qué el failover automático puede costarte dinero
El failover es un hábito del texto que no se transfiere limpiamente al vídeo. En un endpoint de chat, reintentar una solicitud con timeout es barato y la respuesta es idéntica de cualquier manera. En un endpoint de vídeo, cada reenvío es un nuevo trabajo facturable con un precio por segundo de salida, y una redirección a un modelo diferente puede cambiar el movimiento, la consistencia de la identidad, los resultados de seguridad o la duración del clip. Los informes comparativos sobre las mejores API de generación de vídeo con IA nombran los límites de concurrencia, los rate limits, el comportamiento de la cola y los valores atípicos lentos como las grandes diferencias entre proveedores, y la latencia promedio oculta exactamente los retrasos finales que rompen los productos interactivos.
Así que trata los reintentos y el failover como riesgos de gasto y consistencia, no como redes de seguridad gratuitas. Cada envío duplicado aumenta tu coste por clip aceptado sin aumentar la aceptación. Fija el modelo para cualquier serie de clips que deban coincidir, y permite el failover solo entre modelos que hayas probado como equivalentes con tus propios prompts. Trata un rechazo por moderación como un resultado en lugar de un error transitorio: lee el code, cambia el prompt y no reenvíes la misma entrada automáticamente.
El modo de fallo que atrapa a los equipos experimentados es más sutil: un trabajo puede alcanzar el éxito después de que tu solicitud de cliente ya haya agotado el tiempo. Si reenvías en lugar de conciliar el trabajo almacenado, pagas por el mismo clip dos veces. Los enlaces de resultados también son temporales y pueden caducar, así que descarga el archivo terminado inmediatamente, almacénalo con un checksum y escribe la fila de archivo. Ese paso es un control, no una tarea de mantenimiento. UberLLM guarda los archivos de resultados durante aproximadamente 3 horas después de que finalice un trabajo de vídeo o música, lo cual es tiempo suficiente para un bucle de reintentos y ni de lejos suficiente para reemplazar tu propio bucket.
La facturación "exactamente una vez" se construye a partir de varias partes, cada una pequeña por sí misma: una idempotency key por solicitud de usuario, estado de tarea duradero, webhooks verificados, sondeo de conciliación después de un plazo, checksums en medios completados y archivo inmutable de cada archivo terminado. Omite cualquiera de ellas y algún caso extremo acabará encontrando la brecha.
La regla del primer día: cada trabajo de vídeo debe tener un estado almacenado que puedas conciliar sin cobrar ni reenviar el trabajo. Si no puedes responder "¿cuánto costó este trabajo y lo entregamos?" desde tu propia base de datos, la integración no está terminada.
Realice un benchmark de modelo antes de comprometerse
Puede decidir la elección del modelo con una prueba que cabe en una tarde. Elija un modelo predeterminado y un retador con una unidad de coste o perfil de velocidad diferente. Kling 3.0 Standard es un primer modelo predeterminado práctico para texto a vídeo e imagen a vídeo, y Veo 3.1 Fast es un retador de coste útil. Luego:
- Reutilice los prompts fijos, la duración, la resolución, la configuración de audio y la regla de aceptación de su modelo de costes. Las entradas idénticas son la única forma de que una comparación tenga sentido.
- Ejecute al menos 10 trabajos por modelo, suficiente para ver una tasa de fallos en lugar de una ejecución afortunada.
- Obtenga solo cuatro números: tasa de éxito, latencia media, latencia de cola y coste por clip aceptado.
- Verifique la tarifa en la ruta que utilizará. Para el mismo perfil de texto a vídeo a 1080p sin sonido, Veo 3.1 Fast cuesta $0.075 por segundo en UberLLM frente a $0.10 por segundo en fal.ai, y las diferencias de ese tamaño cambian qué modelo gana.
- Mantenga la infraestructura separada: las solicitudes de vídeo van a
/v1/video/generationsy las solicitudes de chat permanecen en/v1/chat/completions, incluso cuando una API key y una base URL cubren ambas.
Cambiar de candidato es un cambio de identificador de modelo, por lo que el benchmark le cuesta prompts y tiempo, no una migración. Elija la ruta con el coste por clip aceptado más bajo que aún cumpla con su barra de latencia y calidad, fíjela para cualquier serie que deba coincidir, y vuelva a ejecutar el mismo conjunto de 10 trabajos cada mes a medida que los precios y las condiciones de la cola cambian.
UberLLM enruta la generación de vídeo a través de proveedores detrás de un endpoint compatible con OpenAI y Anthropic, para que pueda enviar un trabajo una vez y dejar que la pasarela gestione el proveedor, el job ID y el callback contract. Los modelos de texto a vídeo, imagen a vídeo y escalado se encuentran junto a sus modelos de chat en la misma clave y saldo prepago, y las generaciones fallidas no se cobran. Dirija su próximo benchmark de vídeo a UberLLM y compare el coste por clip aceptado en lugar del coste por segundo.