AI Video Generatie API: Taken, Modellen en Kosten
Leer hoe een AI video generatie API werkt, van asynchrone taken en webhooks tot modelkeuze, outputcontroles en de werkelijke kosten per bruikbare clip.
Uw chat voltooiing keert terug in 400 milliseconden, dus u verstuurt video op dezelfde manier: één POST, wachten, de bytes verzamelen. Vier minuten later treedt er een timeout op bij de verbinding, de clip is toch klaar, en u heeft betaald voor een taak die niemand heeft opgehaald.
Die kloof is waar de meeste AI-videogeneratie API-projecten misgaan. Documentatie laat video eruitzien als een trager chat model, en prijstabellen doen u centen per seconde vergelijken alsof een seconde gegenereerd beeldmateriaal een eenheid is die u altijd mag behouden. De markt groeit snel genoeg zodat de fout meeschaalt. Research and Markets waardeerde de wereldwijde markt voor AI-videogeneratoren en -editors op USD 623 miljoen in 2024 en projecteert USD 3.51 miljard tegen 2034 met een samengestelde jaarlijkse groei van 18.64% (Research and Markets, december 2024).
De nuttige vraag is niet welke API het goedkoopst is per seconde. Het is wat één bruikbare, gedownloade, gearchiveerde clip kost na de mislukkingen, de nieuwe pogingen en het model dat vier pogingen nodig had.
Inhoudsopgave
- Mogelijkheden voor Videogeneratie en Aanvraagtypes
- Hoe een Videotaak van Indienen naar Bestand Gaat
- Pollen of Webhooks voor Afgeronde Videoresultaten
- Een Videomodel Kiezen op Basis van Gebruiksscenario
- Kosten per Bruikbare Clip Versus Geadverteerde Prijs
- Aanvraagvelden en Uitvoer Metadata om te Controleren
- Videogeneratie Integreren in Bestaande SDK Code
- Productiefouten en Hoe Duplicaten te Voorkomen
- Voer een Model Benchmark uit Voordat U Zich Vastlegt
Mogelijkheden voor Videogeneratie en Aanvraagtypes
Een chatantwoord is één bericht. Een videojob is een bestand dat later arriveert, en het aanvraagtype dat je kiest, bepaalt wat de provider moet bedenken en wat het teruggeeft.
Tekst naar video is de puurste vorm. Je stuurt een prompt en een model identifier, en het model genereert elke pixel op basis van de beschrijving. Afbeelding naar video voegt een referentieafbeelding toe, zodat onderwerp, kadrering en belichting van de afbeelding komen, terwijl de prompt de beweging levert. Die ene verandering verwijdert het grootste deel van de identity drift die tekst-alleen clips onbruikbaar maakt voor productshots en karakterwerk.
| Aanvraagtype | Input | Uitvoering | Output |
|---|---|---|---|
| Tekst naar video | Tekst prompt en model identifier | Asynchrone job | Nieuwe MP4 clip |
| Afbeelding naar video | Referentieafbeelding en prompt | Asynchrone job | MP4 clip verankerd aan de afbeelding |
| Video upscaling | Bestaand videobestand | Asynchrone job | Hogere-resolutie MP4 |
| Video met audio | Prompt plus audio instelling | Asynchrone job | MP4 met een audiotrack waar het model dit ondersteunt |
Video upscaling is het enige type waarbij de inhoud vaststaat en alleen de resolutie verandert, dus het is het gemakkelijkst te begroten en het moeilijkst om fout te doen. Audio splitst zich in tweeën. Sommige modellen retourneren een soundtrack naast het beeld wanneer je audio inschakelt, terwijl muziek en geluidseffecten afzonderlijke modaliteiten zijn die dezelfde request shape en dezelfde job mechanics gebruiken.
Drie inputs verschijnen in elke rij: de prompt of bronmedia, de model identifier, en de gewenste lengte en resolutie. Neem deze drie vroegtijdig op in je eigen request schema en het wisselen van providers wordt later een configuratiewijziging.
Stel de timingverwachting in voordat je iets bouwt. Een chatantwoord arriveert binnen enkele seconden, terwijl een videoaanvraag eerst wordt geaccepteerd en later wordt voltooid, waarbij een typische uitvoering ongeveer 30 seconden tot enkele minuten duurt. De reactie die je direct terugkrijgt, is een job, geen clip.
Hoe een videotask van indiening naar bestand beweegt
Elke productieklare video API volgt één patroon, en het is het patroon dat OpenAI documenteert in zijn video API-gids: creëer een job, lees de status, en haal dan de content op zodra de status een terminale successtatus bereikt. Modelleer die flow als een asynchroon jobsysteem, nooit als een synchrone mediadownload.
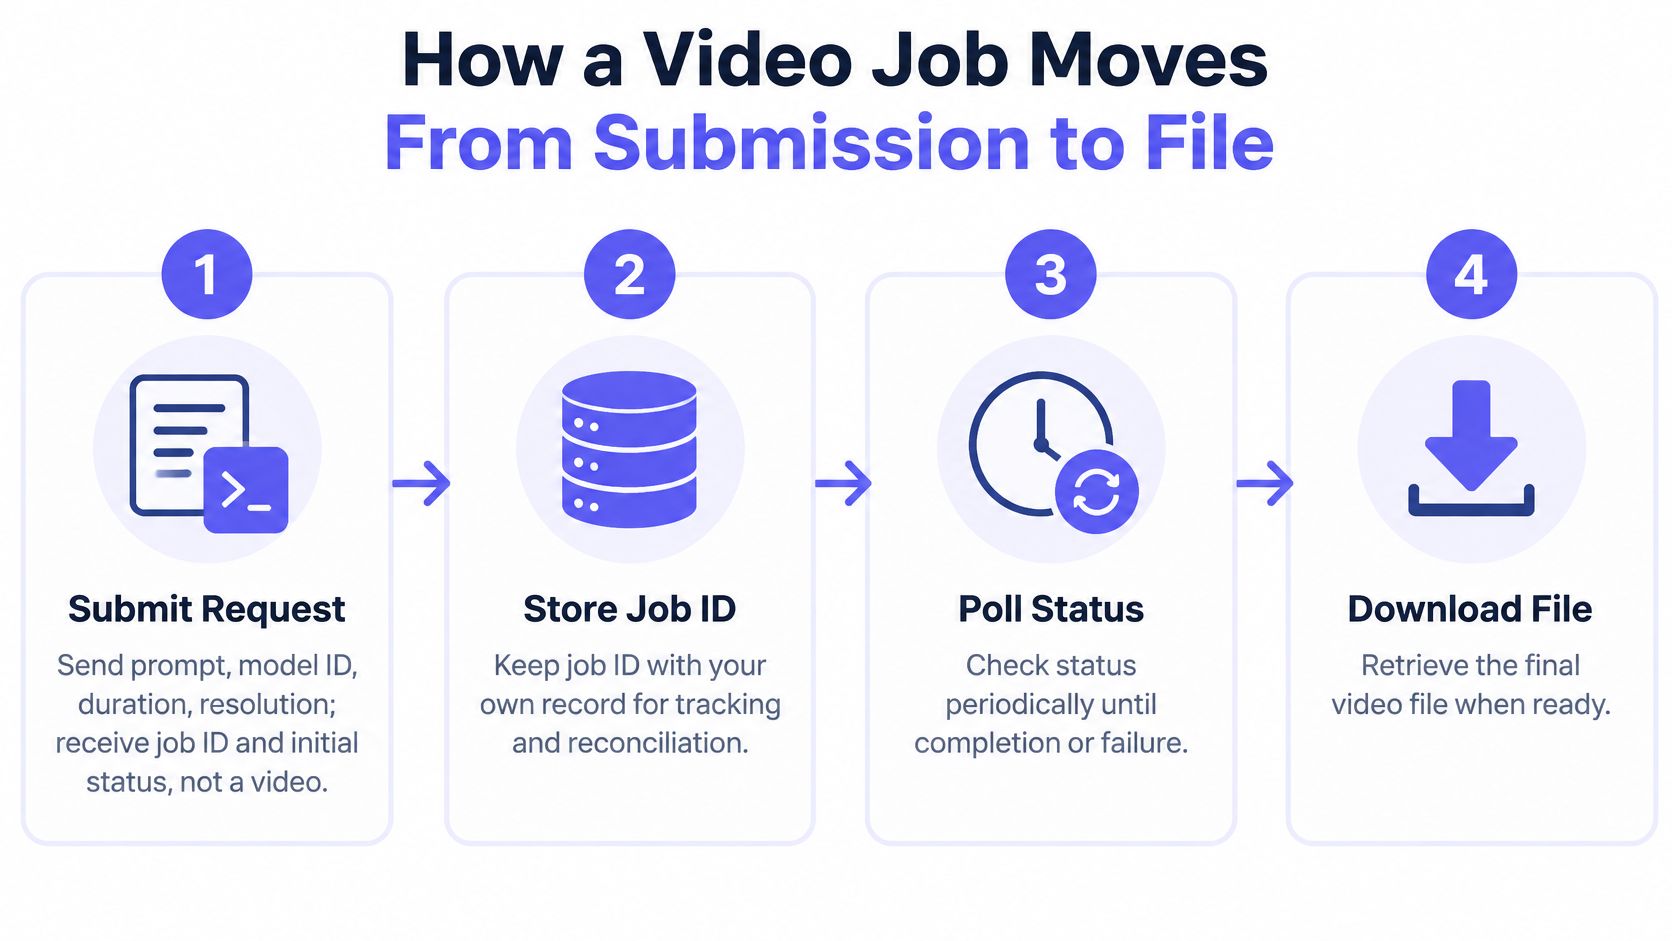
- Dien de aanvraag in. Verstuur de prompt, model-ID, duur en resolutie. De respons bevat een job ID en een initiële status zoals 'queued'. Sla het op voordat je iets anders doet, want een procesherstart verliest anders de enige grip op werk waarvoor je al hebt betaald.
- Koppel de job ID aan je eigen record. Bewaar je interne aanvraag-ID, de gebruiker of tenant waartoe het behoort, de parameters die je hebt verzonden, en de verkoper- of providerroute. Wanneer drie dagen later een facturatievraag binnenkomt, is deze rij het antwoord.
- Monitor de statusresource. Poll het of wacht op een event, en registreer elke transitie met een timestamp. 'Queued', 'running', 'succeeded', 'failed'. De kloof tussen 'queued' en 'running' is de wachtrijtijd ('queue wait'), en het is het getal dat klachten over 'trage modellen' verklaart die niets met het model te maken hebben.
- Wacht op een terminale status. Succes en falen zijn beide terminaal. Een timeout is dat niet, en een verbroken verbinding ook niet, dus behandel geen van beide ooit als een uitkomst.
- Haal het bestand alleen op bij succes. Vraag de contentlocatie op, stream het naar je eigen storage, en registreer de checksum. Dit doen bij falen verspilt calls en kan een echte fout maskeren als een downloadprobleem.
- Lees de fout bij falen. Beslis of de oplossing een gewijzigde parameter, een ander model, of een bericht aan de gebruiker is. Het opnieuw indienen van identieke parameters na een contentafwijzing verbrandt alleen maar geld.
Hoe gezonde job logs eruitzien
Eén job ID, één schone run van 'queued' naar 'running' naar 'succeeded', en precies één download. Al het andere in de log is een meetbare bug: twee downloads betekent een dubbele webhook die je niet hebt gededupliceerd, en een succes dat is vastgelegd nadat je client het opgaf, betekent dat je reconciliatie nodig hebt.
Definieer annulering, timeout, retry en expiration op je eigen job record. Die semantiek behoort tot je gateway, niet tot welke upstream de clip ook heeft gerenderd. Als de caller halverwege het renderen de verbinding verbreekt, laat de job dan afmaken en reconcileer het later. Annulering is een expliciete statuswijziging die je verzendt, niet een HTTP-verbinding die toevallig sluit.
Polling of Webhooks voor Voltooide Videoresultaten
Beide signalen beantwoorden dezelfde vraag, en ze verschillen in wie de actie onderneemt. Polling betekent dat je code herhaaldelijk de statusbron leest totdat de taak een terminale staat bereikt. Webhooks betekenen dat de provider jou belt met een voltooid of mislukt evenement, en je endpoint reageert.
| Vraag | Polling | Webhooks |
|---|---|---|
| Hoe je het resultaat leert | Herhaalde statuslezingen tot terminaal | Een voltooid of mislukt evenement |
| Wanneer je het merkt | Bij het volgende interval | Wanneer het evenement wordt geleverd |
| Extra belasting | Eén statusaanroep per interval | Bijna geen, plus een zeldzame reconciliatie |
| Beste pasvorm | Batch rendering en een eenvoudige eerste build | Langlopende, event-gestuurde generatie |
| Belangrijkste storing | Detectie wacht op het interval | Gemiste of dubbele levering |
| Veiligheidscontrole | Terugtrekken van ongeveer 15 seconden naar 60 seconden | Verifieer de handtekening, persisteer per job ID, behandel levering als at-least-once, sla een herhaalde download en facturering over |
Voor generaties gemeten in minuten, winnen evenementen op zowel kosten als latentie. Het aanvraagvolume van het pollen van elke taak elke paar seconden telt op in een wachtrij, en hetzelfde verkeer vertraagt je detectie tot het volgende interval. De vergelijking van webhooks met directe API polling legt uit waar elk patroon past.
Bouw de handler met vijf controles in deze volgorde:
- Verifieer de handtekening wanneer de provider er een levert, en weiger ongesigneerde leveringen aan de rand.
- Persisteer het evenement tegen de provider job ID voordat enige download-, facturerings- of notificatiewerkzaamheden worden uitgevoerd.
- Ga uit van at-least-once levering, omdat hetzelfde voltooide evenement legitiem twee keer kan aankomen.
- Maak de handler idempotent, zodat een tweede levering een opgeslagen terminale staat ziet en de download en de kosten overslaat.
- Behandel het mislukte evenement als een echt resultaat, niet als een timeout die blindelings opnieuw moet worden geprobeerd.
Voeg dan het vangnet toe. Als er geen evenement arriveert voor een deadline ingesteld op basis van je gemeten latentie, poll dan de job ID met backoff, beginnend rond 15 seconden en uitstrekkend naar 60 seconden. Test beide faalpaden vóór de lancering: forceer een dubbel evenement, onderdruk vervolgens een evenement volledig, en bevestig dat de gebruiker eindigt met één video en één kostenpost.
Praktische regel: een webhook is een optimalisatie voor het 'happy path'. Je reconciliatie poll is wat het systeem correct maakt.
Een Videomodel Kiezen op Basis van Gebruiksscenario
Maak een shortlist van kandidaten op basis van vijf criteria voordat je naar een ranglijst kijkt: de modaliteit die je nodig hebt, de maximale duur en resolutie, audio-ondersteuning, gemeten generatietijd en de kosten eenheid die de provider in rekening brengt. Deze vijf elimineren het grootste deel van het aanbod sneller dan welke kwaliteitsranglijst dan ook.
| Modelfamilie | Modaliteit | Kosten eenheid ter vergelijking | Bekende tijd of prijs |
|---|---|---|---|
| Kling 3.0 Standard | Tekst en afbeelding naar video | Per seconde | Ongeveer 80 seconden voor één clip van 5 seconden |
| Veo 3.1 Fast | Tekst naar video | Per seconde bij 1080p zonder geluid | Noteer latency in je eigen test, aangezien de wachtrijbelasting dit beïnvloedt |
| Veo 3.1 Full | Tekst naar video | Per taak | $0.22 per taak tegen een catalogusprijs van $0.44 |
| Seedance 2.0 Fast | Afbeelding naar video bij 480p, 5 seconden | Per clip | $0.35 per clip tegen een concurrerende prijs van $0.29 |
| LTX 2.3 | Tekst naar video bij 1080p | Per seconde | $0.06 per seconde bij 1080p |
| Wan 2.6 | Tekst naar video | Per taak | $0.16 per taak |
De kosten eenheid is net zo belangrijk als het getal. Een per-seconde prijs is geschikt voor clips van variabele lengte en bestraft lange clips, terwijl een per-taak prijs een clip van vaste lengte voorspelbaar maakt en een langere clip gratis. Vergelijk twee modellen op dezelfde duur en resolutie, anders betekent de vergelijking niets.
Generatietijd bepaalt of je het model voor een persoon kunt plaatsen. Een clip van 5 seconden van Kling 3.0 duurde ongeveer 80 seconden in een test op 29 oktober 2026, wat respectabel is voor een korte clip en onmogelijk te verbergen achter een spinner zonder voortgangsstatus. Een clip van 5 seconden die 80 seconden duurt, heeft een zichtbare status, een geschatte wachttijd en een manier nodig om de pagina te verlaten en terug te komen.
Beperk je tot twee of drie modellen in deze volgorde: eerst modaliteit, dan resolutie en audio, daarna de snelheid en kosten eenheid waar je mee kunt leven. Houd minstens één alternatief op de shortlist, zelfs nadat je een standaardkeuze hebt gemaakt. Een model dat bij je visuele stijl past, kan nog steeds te traag zijn voor je interface, en je wilt dat het alternatief al is gebenchmarkt wanneer dat zich voordoet. De volledige lijst met AI-modellen beschikbaar via één endpoint is een redelijke plek om de shortlist te beginnen, in plaats van negen leveranciersaccounts te openen.
Kosten per bruikbare clip versus geadverteerde prijs
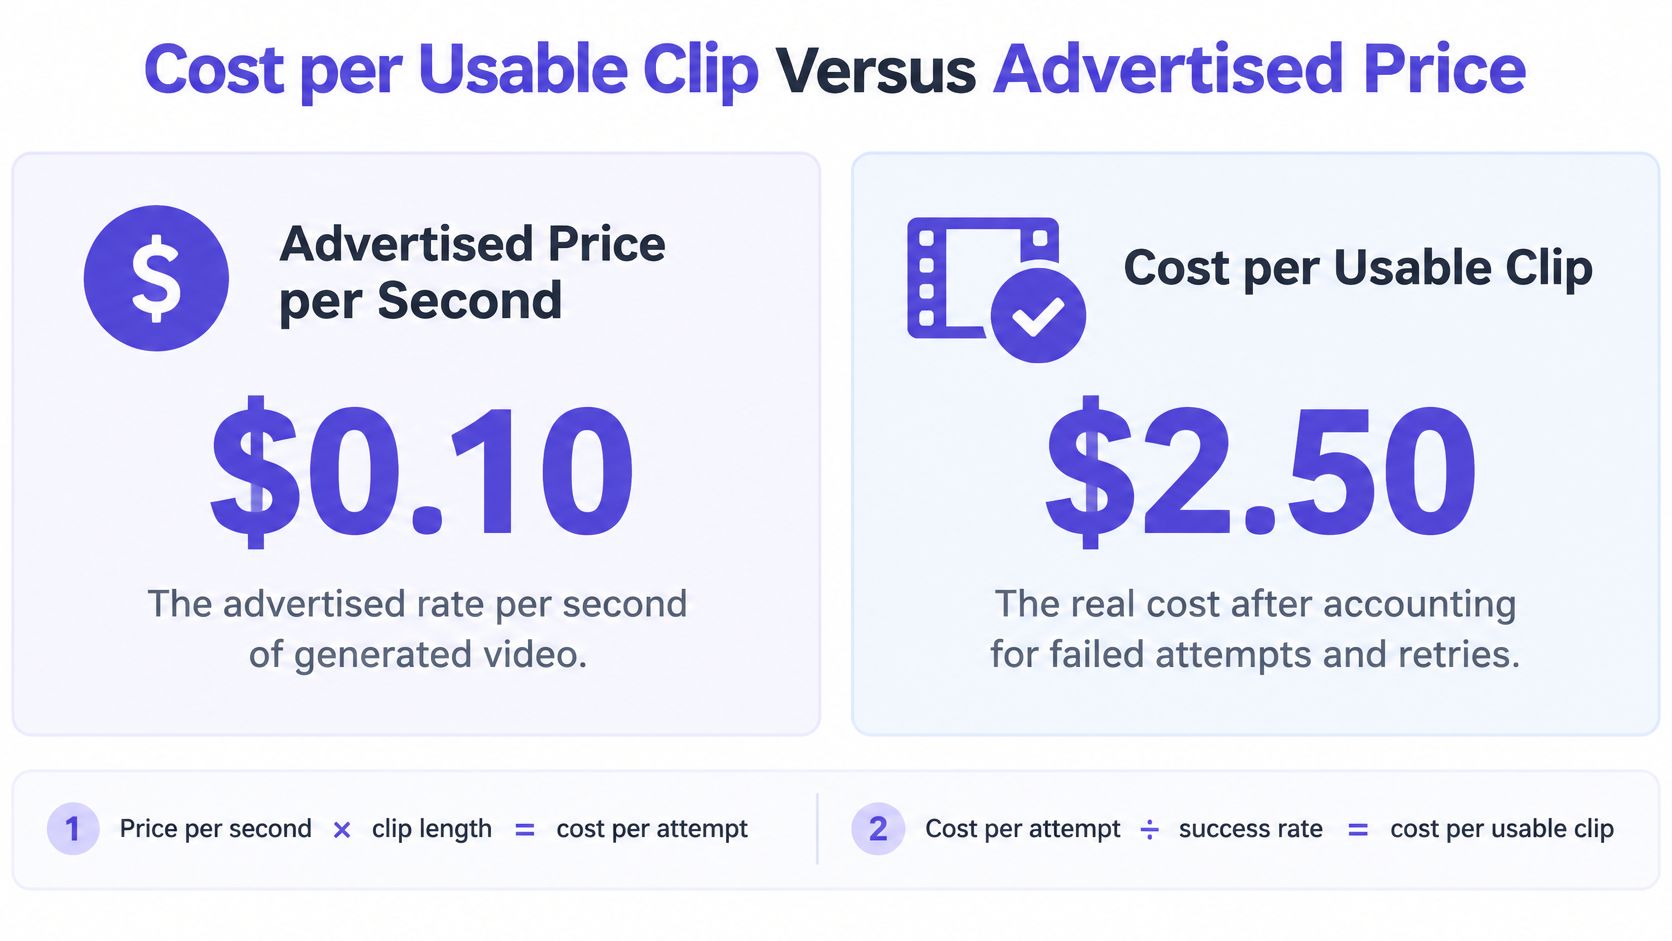
Het geadverteerde tarief per seconde vertelt u wat één poging kost. Het zegt niets over wat een bruikbare clip kost, en dat is het getal waar uw financiële team om geeft.
Laten we de rekensom maken met een concreet voorbeeld. Met $0.10 per seconde kost een clip van 5 seconden $0.50 per poging. Als één op de vier pogingen aan uw kwaliteitsnorm voldoet, kost de geaccepteerde clip $2.00. Een concurrent met $0.07 per seconde kost $0.35 per poging, en als één op de twee pogingen bruikbaar is, kost de geaccepteerde clip $0.70. Het ogenschijnlijk goedkopere model wint met bijna drie keer, terwijl de tabel per seconde het tegenovergestelde klassement liet zien.
Wat de prijstabellen weglaten
Gepubliceerde tarieven liggen ruwweg tussen $0.02 en $1 per gegenereerde seconde, volgens Runway's prijsvergelijking voor AI-video-API's, en die spreiding wordt gemeten vóór de kosten die echte budgetten bepalen. Dezelfde analyse merkt op dat een goedkoper model duurder kan uitvallen wanneer het vier pogingen nodig heeft in plaats van één. Voeg deze toe aan uw model:
- Mislukte en gemodereerde taken. Een afwijzing verbruikt een verzoek en levert niets bruikbaars op, dus het hoort in de noemer van uw succespercentage, niet daarbuiten.
- Herhalingen die u zelf koos. Elke herindiening is een extra pogingskost, daarom hoort het aantal pogingen in de formule en niet in een aparte notitie.
- Instellingen die het tarief beïnvloeden. Resolutie en audio veranderen de prijs per seconde, dus een benchmark die is uitgevoerd met standaardinstellingen, vermeldt een prijs die u mogelijk nooit betaalt.
- Standaardduren die u niet hebt ingesteld. Een standaardduur van 8 seconden van de provider, terwijl u 5 wilde, verhoogt de kosten per clip met 60%.
- Opslag en opnieuw hosten. Een resultaatlink is tijdelijk. Het kopiëren van het bestand naar uw eigen bucket maakt deel uit van de kosten van de geaccepteerde clip.
Factureringsregels bepalen ook de rekensom. Een video wordt gefactureerd tegen de uiteindelijke prijs zodra de generatie is voltooid, en het antwoord op een verzoek vermeldt het maximale bedrag dat de taak kan kosten voordat de video begint, waardoor u een budgetplafond per taak en per tenant kunt instellen. Die twee regels veranderen een vage maandelijkse schatting in een plafond per verzoek dat u in code kunt afdwingen.
Definieer acceptatie nauwkeurig. Een taak die succes meldt, is geen bruikbare clip. Tel deze alleen mee als deze voldoet aan de prompt, temporele consistentie behoudt, de identiteit van het onderwerp handhaaft en geen duidelijke bewegings- of fysicafout vertoont. Voor een volledigere uitsplitsing van hoe tarieven per seconde en per taak zich verhouden over verschillende routes, behandelt de gids over hoe AI-prijsmodellen werken de factureringseenheden.
Een successtatus betekent dat het renderen is voltooid. Het betekent niet dat de clip het waard is om te verzenden, en alleen de tweede gaat in de teller.
Aanvraagvelden en uitvoermetadata om te controleren
Een videoaanvraag bevat meer dan alleen een prompt. Elk veld kiest de route, beïnvloedt de prijs, of bepaalt of een goed resultaat later kan worden gereproduceerd. Stuur deze zeven mee:
- De model-ID, die de providerroute selecteert. Identifiers hebben een structuur, dus
fal-ai/kling-video/v3/standard/text-to-videocodeert provider, familie, versie, tier en modaliteit in één string. Bewaar deze in de configuratie, nooit hardgecodeerd in de aanvraaglogica. - De prompt, en voor beeld-naar-video de referentieafbeelding of de geüploade locatie daarvan.
- Duur in seconden, omdat zowel de prijs als de generatietijd hiermee schalen.
- Resolutie en beeldverhouding, aangezien beide de prijs per seconde bepalen.
- De audio-instelling, indien het model audio ondersteunt.
- Een seed wanneer het model er een accepteert, zodat een goed resultaat kan worden gereproduceerd.
- Je eigen request ID, zodat de taak van de provider kan worden gekoppeld aan jouw record.
Uitvoeringsvelden om op te slaan bij elke voltooide taak
Container format, video codec, dimensies, frame rate, duur, aanwezigheid en codec van audio, bitrate indien beschikbaar, bestandsgrootte, en een duurzame content URL of object identifier. Sla de metadata naast het bestand op, want het bestand alleen vertelt je volgend kwartaal niet welke instellingen het hebben geproduceerd.
Leg die metadata vast in plaats van aan te nemen dat elk resultaat gelijkwaardig is. Twee clips met dezelfde duur kunnen aankomen in verschillende codecs, met verschillende bitrates, met of zonder audiotrack. De W3C WebCodecs specification definieert de interfaces voor het coderen en decoderen van audio en video zonder een codec of een coderingsmethode te verplichten, dus niets garandeert dat twee renders in hetzelfde formaat terugkomen.
Lever een conservatief MP4 profiel voor browsers en apps, en bewaar het provider-native bestand wanneer kwaliteit belangrijk is voor een latere bewerking. Valideer vervolgens vóór succes. Controleer de gedecodeerde duur en het aantal frames tegen de aanvraag, want een bestand met de verkeerde lengte is een mislukking, zelfs wanneer de API succes meldt. Een clip van 4 seconden terwijl je om 5 vroeg, verstoort een tijdlijn net zo erg als een mislukte taak, en het is veel moeilijker op te merken.
Videogeneratie Integreren in Bestaande SDK Code
Een bestaande tekstintegratie past zich aan zonder herschrijven. Houd tekst en video op afzonderlijke routes, zodat beide één API key, één base URL en één saldo kunnen delen, en laat de SDK wrapper op zijn plaats. Het verplaatsen van een OpenAI of Anthropic compatibele client is een endpoint- en credential-wijziging, en het wisselen van modellen is een identifier-wijziging.
Vier onderdelen van een slanke videoservice
Een create-functie valideert invoer, roept de generatieroute aan, en retourneert onmiddellijk je eigen interne job ID. Je bellers zien nooit een provider ID, wat een latere failover voor hen onzichtbaar maakt.
Een jobtabel koppelt interne ID's aan provider job ID's, status, route, tijdstempels en output metadata. Behandel het als de bron van waarheid voor factuurafstemming, niet het dashboard van de provider.
Een worker pollt of ontvangt webhooks, laat de state machine vorderen, en past de retry- en deadline-regels toe die je hebt gedefinieerd. Eén worker verwerkt beide signalen, zodat een gemist event en een trage poll samenkomen op hetzelfde code path.
Een opslagstap kopieert de voltooide MP4 naar je eigen bucket, berekent een checksum en schrijft de metadata-rij. Dit is de stap die teams overslaan en vervolgens herbouwen na hun eerste verlopen link.
Beperk elke API key tot één omgeving en houd keys intrekbaar, zodat een gelekte staging key geen toegang krijgt tot productiecapaciteit. Voor grote bronafbeeldingen of videobestanden, upload via een signed URL in plaats van bytes in de request body in te sluiten, aangezien een multi-megabyte JSON payload zijn eigen storingsmodus is.
Voer dan de test uit waar een senior engineer naar zal vragen. Stuur een request dat time-out op de client, en bevestig dat het systeem eindigt met precies één opgeslagen task, één uiteindelijke download en geen dubbele submission. Als die test slaagt, is de rest van de integratie detail.
Productiefouten en hoe duplicaten te voorkomen
Een generatie-API is geen functieaanroep, en het behandelen ervan als zodanig is waar de duplicaten vandaan komen. Bij een synchrone tekst-API betekent een timeout bijna altijd dat het werk nooit heeft plaatsgevonden. Bij video betekent een timeout alleen dat je bent gestopt met luisteren. De taak kan nog steeds in de wachtrij staan, nog steeds actief zijn, en staat nog steeds op het punt om je de uiteindelijke prijs te factureren zodra deze is voltooid. De onderstaande afbeelding toont de operationele versie van dat idee: een pijplijn die zichzelf herstelt, met iemand die er eigenaar van is, in plaats van een wachtrij waar niemand op let.
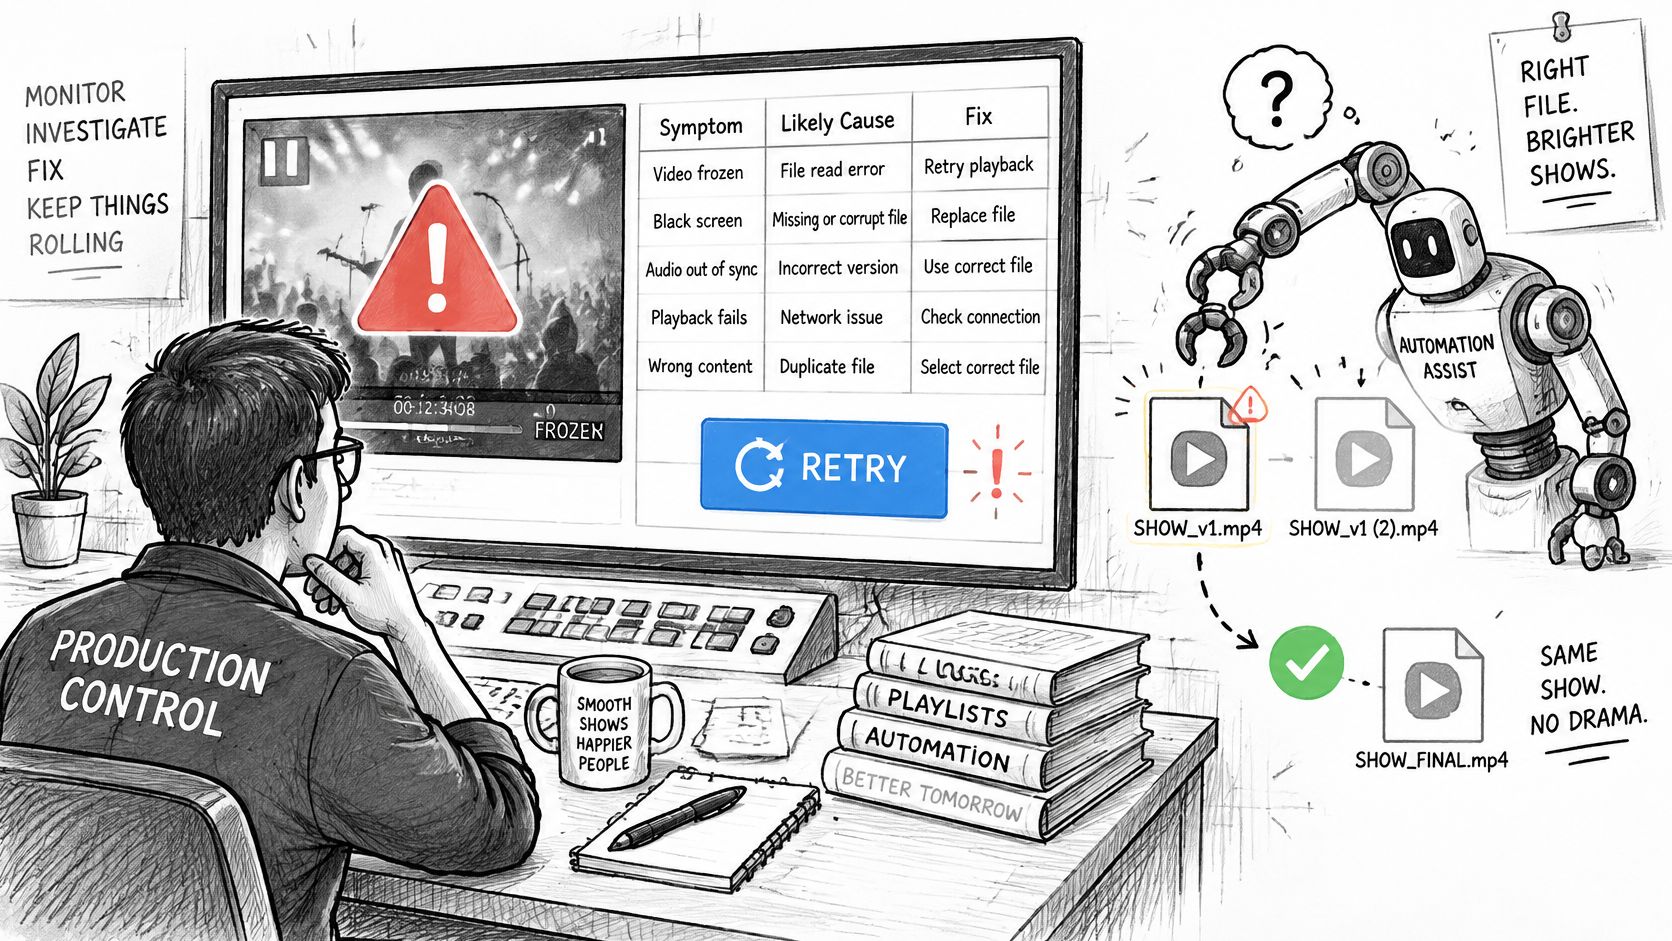
Zeven symptomen zijn verantwoordelijk voor de meeste video-integratiefouten, en elk komt overeen met één oorzaak en één oplossing.
| Symptoom | Waarschijnlijke oorzaak | Oplossing |
|---|---|---|
| Webhook komt nooit aan | Leveringsfout of endpoint-timeout | Poll de job-ID na een deadline en stem de status af |
| Zelfde clip twee keer gemaakt of gefactureerd | Herhaling van een niet-idempotente generatie | Stuur een idempotency key per gebruikersverzoek en hergebruik de opgeslagen job-ID |
| Job meldt succes, maar bestand heeft verkeerde lengte | Outputvalidatie overgeslagen | Controleer gedecodeerde duur en frame count voordat succes wordt gemarkeerd |
| Moderatieafwijzing lijkt op een algemene fout | Veiligheidsfilter stopte de job | Lees de error code, wijzig de prompt, probeer dezelfde input niet opnieuw |
| Download mislukt uren later | Result URL is verlopen | Download onmiddellijk, sla het bestand op met een checksum, en archiveer het |
| Outputstijl verandert na failover | Een ander model of verkoper heeft de job uitgevoerd | Pin het model voor overeenkomende clips en schakel alleen over tussen geteste equivalenten |
| Veel verzoeken lijken traag | Rate limit of wachtrijwachttijd | Houd queue time apart van generation time en stel per-job deadlines in |
Waarom automatische failover je geld kan kosten
Failover is een tekstgewoonte die niet netjes overdraagbaar is naar video. Op een chat endpoint is het opnieuw proberen van een getimede-out aanvraag goedkoop en het antwoord is hoe dan ook identiek. Op een video endpoint is elke herindiening een nieuwe factureerbare job geprijsd per seconde output, en een omleiding naar een ander model kan beweging, identiteitsconsistentie, veiligheidsresultaten of clipduur veranderen. Vergelijkende rapportage over de beste AI-videogeneratie-API's noemt concurrency limits, rate limits, queue behaviour en trage uitschieters als de grote verschillen tussen providers, en gemiddelde latency verbergt precies de staartvertragingen die interactieve producten breken.
Behandel retries en failover dus als kosten- en consistentierisico's, niet als gratis vangnetten. Elke dubbele indiening verhoogt je kosten per geaccepteerde clip zonder de acceptatie te verhogen. Pin het model voor elke reeks clips die moeten overeenkomen, en sta failover alleen toe tussen modellen die je zelf als equivalent hebt getest met je eigen prompts. Behandel een moderatieafwijzing als een resultaat in plaats van een tijdelijke fout: lees de code, wijzig de prompt, en verstuur dezelfde input niet automatisch opnieuw.
De foutmodus die ervaren teams verrast, is subtieler: een job kan succesvol zijn nadat je clientverzoek al een timeout heeft gehad. Als je opnieuw indient in plaats van de opgeslagen job af te stemmen, betaal je twee keer voor dezelfde clip. Result links zijn ook tijdelijk en kunnen verlopen, dus download het voltooide bestand onmiddellijk, sla het op met een checksum, en schrijf de archiefregel. Die stap is een controle, geen huishoudelijke taak. UberLLM bewaart result files ongeveer 3 uur nadat een video- of muziekjob is voltooid, wat lang genoeg is voor een retry loop en lang niet lang genoeg om je eigen bucket te vervangen.
Exact-één-keer-facturering is samengesteld uit onderdelen, elk op zichzelf klein: een idempotency key per gebruikersverzoek, duurzame taakstatus, geverifieerde webhooks, afstemmingspolling na een deadline, checksums op voltooide media, en onveranderlijke archivering van elk voltooid bestand. Sla er één over en een edge case zal uiteindelijk de lacune vinden.
De dag-één-regel: elke videojob moet een opgeslagen status hebben die je kunt afstemmen zonder kosten in rekening te brengen of het werk opnieuw in te dienen. Als je vanuit je eigen database geen antwoord kunt geven op "wat kostte deze job en hebben we deze geleverd", dan is de integratie niet voltooid.
Voer een Model Benchmark uit voordat je je vastlegt
Je kunt de modelkeuze vaststellen met een test die in een middag past. Kies één standaard en één uitdager met een andere kosten eenheid of snelheidsprofiel. Kling 3.0 Standard is een praktische eerste standaard voor tekst naar video en afbeelding naar video, en Veo 3.1 Fast is een nuttige kostenuitdager. Dan:
- Hergebruik de vaste prompts, duur, resolutie, audio-instelling en acceptatieregel van je kostenmodel. Identieke invoer is de enige manier waarop een vergelijking zin heeft.
- Voer minstens 10 taken per model uit, genoeg om een foutpercentage te zien in plaats van een gelukkige run.
- Breng slechts vier cijfers terug: succespercentage, mediane latentie, staartlatentie en kosten per geaccepteerde clip.
- Controleer het tarief op de route die je zult aanroepen. Voor hetzelfde tekst naar video profiel op 1080p zonder geluid, kost Veo 3.1 Fast $0.075 per seconde op UberLLM tegen $0.10 per seconde op fal.ai, en verschillen van die grootte veranderen welk model wint.
- Houd de verbindingen gescheiden: videoaanvragen gaan naar
/v1/video/generationsen chataanvragen blijven op/v1/chat/completions, zelfs wanneer één API key en één base URL beide dekken.
Het wisselen van kandidaat is een model-identificatieverandering, dus de benchmark kost je prompts en tijd, geen migratie. Kies de route met de laagste kosten per geaccepteerde clip die nog steeds voldoet aan je latentie- en kwaliteitsstandaard, pin deze vast voor elke serie die moet overeenkomen, en voer dezelfde 10-taken set elke maand opnieuw uit naarmate prijzen en wachtrijcondities veranderen.
UberLLM routeert videogeneratie over providers via één OpenAI- en Anthropic-compatibele endpoint, zodat je één keer een taak kunt indienen en de gateway de verkoper, de job ID en het callback contract kunt laten afhandelen. Tekst naar video, afbeelding naar video en upscaling modellen staan naast je chat modellen op dezelfde key en prepaid saldo, en mislukte generaties worden niet in rekening gebracht. Richt je volgende video benchmark op UberLLM](https://uberllm.com) en vergelijk kosten per geaccepteerde clip in plaats van kosten per seconde.