AI 生成音乐视频:工作原理和使用的工具
了解什么是 AI 生成的音乐视频,四阶段管道如何构建它,以及哪些模型和检查使其正常工作。
音乐创作者预计到 2028 年,其 24% 的收入将面临风险,这是根据 GEMA 总结的 CISAC 经济影响研究报告得出的。这一预测让 AI 生成的音乐视频呈现出不同的面貌:它们不仅仅是视觉实验,更是对艺术家、剪辑师和观众都产生影响的制作选择。
负责任地制作一个(视频)不仅仅需要一个引人注目的提示词。你需要一个基于歌曲的制作计划、可以独立修复的片段、可衡量的同步检查,以及对人员和模型贡献的清晰记录。
目录
- AI 生成的音乐视频究竟是什么
- 从歌曲到成品视频的四个阶段
- 将提示和图像转化为动态的模型
- 检查口型同步和节拍对齐
- 常见问题及解决方法
- 在不失去信任的情况下披露 AI 参与
- 在投入完整歌曲前测试您的第一个片段
什么是AI生成音乐视频
AI生成音乐视频是指视觉、音轨或两者皆由生成模型而非完全录制或拍摄制作的音乐视频。假设你录制了一首关于离家的歌曲:你可以生成火车窗外的风景,为歌手的肖像制作动画,并将这些镜头围绕你现有的录音进行组合。
根据Berklee的数据,在一项针对2026名视频创作者、音乐家、营销人员和音乐总监的1,003项美国调查中,19%使用生成式AI来为视频寻找或创作音乐,而32.7%已将AI生成音乐用作已发布内容的最终音频。这些衡量标准关注的是视频工作流程中的音乐,而不是完全由AI生成的音乐视频的比例。
项目使用AI的三种方式
- 完全合成: 歌曲和动态图像都来自生成模型,由人指导并选择结果。
- 混合: 人工录制的音轨伴随生成的场景,例如火车窗外序列。
- AI辅助: 你拍摄表演,然后使用AI进行编辑或特效。这在狭义上不一定是AI生成视频。
将歌曲视为配乐,将提示视为模型解释的镜头列表。你仍然负责决定屏幕上显示什么。
Text-to-video 将书面指令转化为片段。Image-to-video 为提供的静态图像制作动画。segment 是歌曲的限定部分,shot prompt 指导其图像,而 final edit 则组合所选材料。
在选择工具之前,请明确你项目中的各个部分:录音、人声、歌词、参考图像、生成镜头和编辑。标记哪些是人工制作的,哪些是你将生成的。这个简单的清单会告诉你正在制作哪个版本。
从歌曲到成片视频的四个阶段
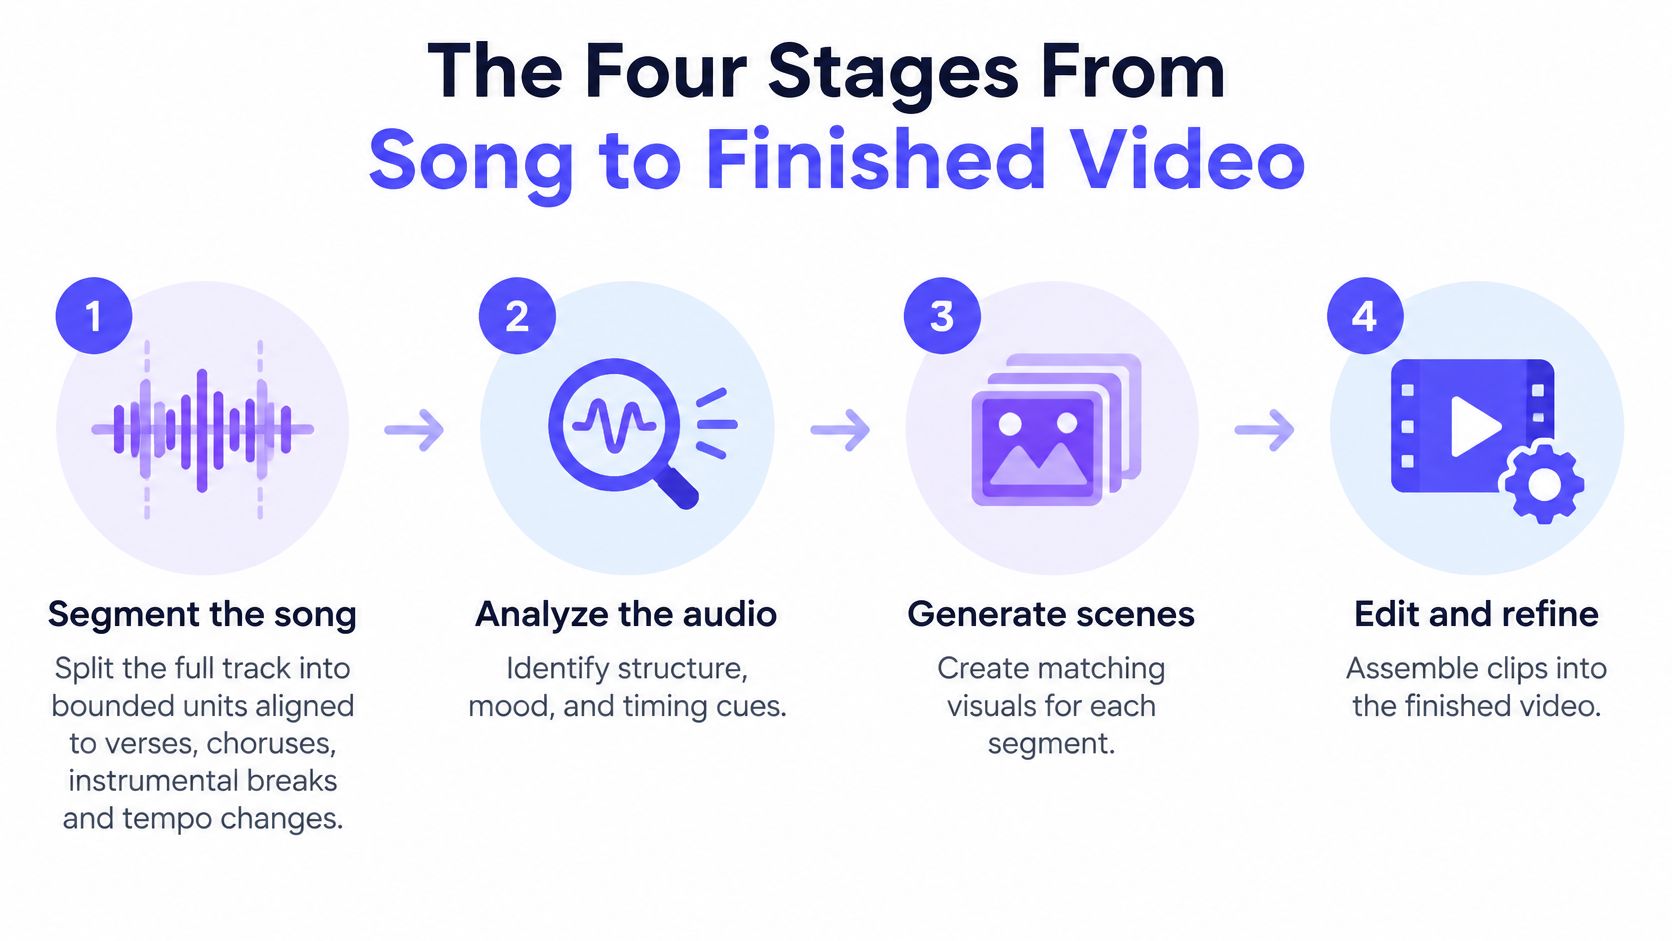
将一首歌曲长度的制作视为一系列可管理的工作,会更容易掌控。已发布的从声音到视觉的流程遵循歌曲分段、音频分析和脚本生成、文本到视频生成以及最终组装的步骤。
以下工作流程将创意决策与渲染任务分开。
围绕音乐结构进行构建
歌曲分段。 标记主歌、副歌、纯音乐段落和节奏变化,然后将它们划分为有界生成单元。一个音乐段落可以包含多个镜头,因此不要将副歌标签与生成一个连续片段的要求混淆。
分析音频并编写视觉脚本。 识别节奏、能量、人声段落和情绪变化,然后为每个片段分配一个镜头提示。对于一首离家主题的歌曲,安静的主歌可能使用静止的平台场景,而副歌则引入向前移动。
生成片段。 对于独立描述的场景使用text-to-video,或者在提供的视觉参考很重要时使用image-to-video。在将其纳入编辑之前,根据其指定目的审查每个结果。
组装最终剪辑。 将批准的片段按确定性顺序放置到主音轨上。标准化帧率、分辨率、宽高比和最终响度,使混合输出表现得像一个整体制作。
流程阶段、输入和输出
| 阶段 | 输入 | 输出 |
|---|---|---|
| 1. 歌曲分段 | 带时间戳的完整音轨 | 带时间码和标签的有界片段 |
| 2. 分析音频并编写脚本 | 片段、节奏、人声提示 | 每个片段一个镜头提示 |
| 3. 生成片段 | 镜头提示、可选参考静止图像 | 每个片段一个短片,并存储seed和model version |
| 4. 组装最终剪辑 | 片段和原始音轨 | 一个以恒定帧率渲染并标准化响度的输出 |
使每个片段都可恢复
有界片段有助于限制时间漂移,即在生成的序列持续时,对象、身份或动作发生变化。它们还允许您替换一个较弱的镜头,而无需放弃一个成功的序列。
存储一个制作清单,其中包含每个片段的时间码、歌词或纯音乐标签、节奏、能量、镜头提示、seed、model version和输出位置。在适用时,将参考图像标识符与该记录一起保存。seed有助于记录一次运行,但它不能保证在模型更新后结果完全相同。
制作规则: 将片段清单视为您的可编辑项目,而不仅仅是已完成下载的日志。
作为规划和组装的实用参考,AIMVG的音乐视频制作演练提供了一个有用的工作流程参考。实现渲染层的开发者可以使用AI视频生成API指南将这些片段记录连接到生成任务。
将提示词和图像转化为动态的模型
文本转视频为您提供了创造空间;图像转视频则为您提供了一个视觉起点。 这种区别比为整首歌曲选择一个模型更为重要。
通过文本转视频,您可以描述主体、场景、动作、摄像机和灯光。它适用于风景、象征性图像以及不需要精确重复面孔的开场镜头。独立的生成可能会对相同的描述做出不同的解释,因此仅仅重复措辞不应成为您的身份控制策略。
图像转视频始于您提供的一张静态图片。它可以固定服装、构图和面部外观,但并不能锁定后续的每一帧。一个困难的动作或摄像机角度仍然可能产生不希望的改变。
根据镜头匹配输入
对于一个反复出现的歌手,请准备一张清晰的参考图像,其中面部无遮挡,服装清晰可辨。Synchronicity Labs 关于图像转视频]是决定如何将静态图片转化为定向动态镜头时的有用参考。
以下系列提供的是起始候选模型,而非质量排名。请将每个角色视为需要根据您自己的素材进行测试的对象,并在提交前验证当前 endpoint 支持的输入。
按输入模式和音乐视频角色分类的模型系列
| 模型 | 输入模式 | 在音乐视频中的典型角色 | 注意事项 |
|---|---|---|---|
| Kling 3.0 Standard | 文本转视频或图像转视频 | 通用镜头和初始候选 | 在规划片段前检查剪辑长度限制 |
| Veo 3.1 Fast | 文本转视频 | 情绪迭代和开场镜头 | 验证当前分辨率和音频选项 |
| Seedance 2.0 | 图像转视频 | 固定于静态图像的艺术家或角色镜头 | 需要一张清晰的参考图像 |
| Wan 2.6 | 文本转视频 | 器乐和抽象片段 | 在接受前检查运动连续性 |
| PixVerse V5.6 | 文本转视频 | 风格化或实验性片段 | 检查风格化是否保留了所需细节 |
将外观与表演分离
视觉上一致的面孔并不自动意味着歌唱表演。唇形同步和音频驱动模型处理与所提供音频对应的嘴部动作;不应假定普通的图像动画能完成这项工作。
一种实用的组合是:文本转视频用于营造氛围的段落,图像转视频用于重复出现的艺术家镜头,以及音频驱动步骤用于可见的歌唱部分。如果概念更适合作为叙事或视觉化呈现,您也可以完全避免表演特写镜头。
保持提示词专注于可观察的动作。文本转视频提示词指南]可以帮助将抽象情绪转化为摄像机方向和主体运动。剪辑限制、分辨率选项和生成时间在不同版本之间会有变化,因此请根据片段要求选择模型,而非品牌熟悉度。
检查唇形同步和节拍对齐
即使面容姣好,也可能唱错音节。视觉保真度和音视频同步是独立的验收标准:唇形同步评估论文 审查了 615 个生成的片段,并使用包括 地标距离 (LMD) 和 唇形同步误差置信度 (LSE-C) 在内的指标来评估嘴部动作和音频对应关系。
LMD 衡量嘴部区域地标误差与预期动作的偏差。LSE-C 评估唇部动作与语音轨道的匹配置信度。两者都不应被视为完整的艺术评分,并且当应用于持续歌唱、和声或富有表现力的嘴形时,以语音为导向的衡量标准需要仔细解读。
按顺序运行检查
- 提取节拍和起始时间戳。 使用音频分析工具识别节奏位置和音符起音。标记哪些事件需要剪切或动作强调,而不是将每个节拍都强制转换为过渡。
- 标记人声片段。 识别可见表演者应该唱歌的位置。使用正确的人声片段并保留其相对于主轨道的偏移量。
- 评分并检查每个片段。 对可见的歌唱应用嘴部相关指标,然后评估时机和音乐契合度。以正常速度和逐帧方式观看。
- 仅重新生成失败的片段。 在请求替换之前,记录失败是关于时机、发音、图像质量还是音乐诠释。
同步检查及其适用范围
| 检查项 | 衡量内容 | 适用范围 |
|---|---|---|
| 嘴部地标误差 (LMD) | 嘴部区域地标与预期动作的距离 | 人声片段 |
| 唇形同步置信度 (LSE-C) | 唇部动作是否与语音轨道匹配 | 人声片段 |
| 节拍或起音对齐 | 剪切和动作强调是否落在音乐事件上 | 每个片段边界 |
| 节奏和情绪匹配 | 动作节奏和基调是否与音轨一致 | 伴奏片段 |
在最终渲染前定义门限
对于每位歌手、每种风格或每个模型,都没有通用的合格分数。使用您已审查并接受的片段来校准您的门限,然后在项目中保持这些设置一致。
- 嘴部动作门限: 拒绝发音错误不可接受或同步置信度低的可见歌唱。
- 时机门限: 拒绝在指定音乐事件上意外的失误。
- 动作一致性门限: 拒绝与预期节奏、情绪或主题相矛盾的动作。
- 感知门限: 即使数值分数看起来可接受,也要拒绝分散注意力的面部扭曲。
假设歌手的嘴形与正确的歌词一致,但整个表演开始得晚了。在委托新的表演之前,修正片段的偏移量。如果时机正确但嘴形发音不同,仅靠编辑无法修复。
节拍前的刻意剪切是可行的。预期强调后的意外剪切是制作错误。
将分数和审查笔记与片段记录一起保存。这为您提供了每次拒绝的理由,并使替换选择不那么随意。
常见问题及解决方法
当一个角色在不同镜头之间更换服装或面部时,首先检查源素材和生成指令。不要试图用过渡效果来掩盖每一个身份不匹配的问题。判断问题是出在参考素材、生成效果还是组装环节。
在重新生成前进行诊断
常见的制作问题、原因及解决方法
| 症状 | 可能原因 | 解决方法 |
|---|---|---|
| 角色在不同镜头间变化 | 独立片段间的提示词漂移 | 对每个角色使用一张固定的参考静止图像进行 image-to-video 生成 |
| 口型与人声不同步 | 片段时间与人声轨道不匹配 | 使用校正后的时间码重新生成该片段,并重新检查 lip-sync 置信度 |
| 剪辑点不在节拍上 | 边界是凭肉眼设置,而非基于检测到的起始点 | 在组装时根据 onset timestamps 重新剪辑 |
| 长片段中出现闪烁或变形 | 片段长度超过模型稳定保持的范围 | 使用更短的片段并在剪辑中拼接 |
| 片段间颜色或帧率不同 | 输出设置混杂 | 在组装时统一帧率、分辨率和宽高比;单独匹配颜色 |
| 剪辑点之间响度不均 | 最终混音未进行响度标准化 | 对整个剪辑进行响度标准化 |
| 崩溃后一个片段失败 | 使用了整个项目重新运行,而非片段恢复 | 仅从其存储的 seed 和 metadata 重新生成该片段 |
区分编辑修复和设计更改
组装修复包括移动剪辑点、校正偏移、匹配颜色或修复导出设置。在支付新图像费用之前,请尝试这些方法。裁剪可以解决构图不匹配的问题,但请仔细预览结果,以免移除歌手的手或剪掉重要的动作。
生成修复需要一个新的片段,因为实际内容有误。例如,面部变形、不正确的发音或遮挡主体的摄像机移动。更改具体的失败指令,而不是重写整个提示词。
概念修复需要更广泛的重新思考。如果每个镜头都依赖于您所选方法无法保留的复杂编排,请简化表演或切换到叙事处理方式。
对于参考驱动的工作,截图转视频指南提供了一个有用的起点,可以将准备好的图像转换为动态影像。首先检查静止图像:内置模糊、面部遮挡和混乱的解剖结构都是动画制作的糟糕基础。
除非您的编排有意改变,否则请将歌曲作为连续的主音轨。意外的片段音频可能会引入响度跳变,即使原始录音是一致的。崩溃后,恢复已完成的文件并从失败的片段继续,而不是将整个制作视为丢失。
披露 AI 参与而不失信任
AI 辅助和 AI 生成描述了不同的贡献。人类表演经过 AI 清理与合成人声不同,一概而论的标签可能会模糊而非澄清这种区别。
在工作时记录录制和编辑的贡献。
根据视听作者身份研究,在一次有 120 名参与者的 2025 实验中,当归因于人类钢琴家时,相同的音频获得了更高的喜爱度、参与度、情感影响力和质量评分,并且有 79% 人报告注意到了差异。这是谨慎撰写披露声明的理由,而不是隐瞒实质性贡献的借口。
标注贡献,而不仅仅是项目
- 音乐和歌词: 分别说明是作曲还是歌词是生成的。
- 人声: 明确指出是合成歌声,而不是暗示是录制的人类表演。
- 视觉效果: 区分生成的场景和拍摄的素材。
- 编辑: 描述 AI 清理或效果,而不暗示底层表演是合成的。
对于混合项目,描述可以说明艺术家创作并演唱了歌曲,而视觉效果是 AI 生成并由人类编辑的。对于合成歌手,要让这个事实足够突出,以免观众将表演误认为是所描绘人物的录音。
披露原则: 具体说明哪些是生成的,并同样具体说明哪些是人类创作的。
当合成作者身份是核心前提时,使用标题;描述用于贡献详情;片尾字幕或结束卡片用于完整的制作记录。遵循适用的平台要求,而不是将放置位置纯粹视为营销选择。
作为额外的观看参考,嵌入式视频可在下方查看。
逐个市场测试真实措辞对观看时长、完成度、评论和观众信任度的影响。在所有测试中保持基本事实不变。一个能提高点击量但让观众对歌手感到困惑的标签,并非成功的披露。
在制作完整歌曲前,先测试你的第一个片段
从一个能揭示你最棘手制作问题的段落开始。如果最终视频依赖于表演特写,那么一个有可见歌唱和清晰节奏重音的副歌比氛围场景更能提供信息。
运行小型验收测试
选择一个有代表性的节选。 例如,你可以测试一个十到十五秒的副歌段落,前提是所选的端点支持该时长。同时包含一个人声乐句和你打算强调的音乐事件。
选择输入方式。 我们推荐使用 Kling 3.0 Standard 作为首选视频模型,通过文本生成视频或图像生成视频。当可识别性至关重要时,选择参考引导的镜头。
编写一个聚焦的镜头提示词。 指定主体、动作、构图、镜头运动和灯光。避免在同一次尝试中结合场景变化、服装变化和复杂表演。
生成并跟踪任务。 我们的图像和视频任务会返回一个你可以轮询的任务,或者你可以设置一个 Webhook 在结果准备好时通知你的应用程序。在网页工具中,使用其进度视图,而不是在等待时提交重复任务。
应用验收检查。 检查可见的歌唱、指定的节拍重音、身份一致性和分散注意力的伪影。记录失败类别,而不是仅仅因为片段看起来很棒就接受它。
仅在验收通过后进行扩展。 将成功的提示词结构和参考选择应用到你的片段计划中。保留测试结果,作为后续镜头的比较。
在提交生成请求之前,使用界面检查可用控件。
在扩展前检查成本
在提交前查看定价和失败政策。我们对视频请求的回复会说明 生成开始前可能产生的最高费用;已完成的视频按最终价格计费,失败的生成不计费。
如果测试通过了相关的对口型检查和指定的节拍检查,则继续进行完整的片段计划。如果失败,首先纠正时间错误,然后更改模型或参考图像(如果生成内容是问题所在)。在将该选择应用于整首歌曲之前重新测试。
UberLLM 通过统一 API 提供视频、图像、音乐和语音模型的访问,因此你可以在不为每个提供商维护不同集成的情况下,构建音乐视频流程的各个阶段。访问 UberLLM 以比较模型选项,并在投入到整首歌曲的制作之前运行一个有代表性的片段。