图像转动画:如何让静态图像动起来
本图像转动画指南涵盖了方法、分步动画制作、帧检查以及 2026 中常见运动故障的修复。
你有一张静态图片,需要在页面上线前动起来。产品照片需要在着陆页上轻微摆动,或者肖像照需要看起来像人物在说话。第一次预览看起来不错。然后你拖动到中间,一只手变形了,一个标志抖动了,或者到最后一秒脸已经不是同一个人了。
这个差距决定了图片转动画是否可用。一个你可以发布的片段,在每一帧中都保持了身份、几何形状和背景的完整性,并且你在上传前拥有动画化源文件的权利。我会像评估客户剪辑一样评估结果:对照书面动态规格,经过权利检查,而不是仅仅根据缩略图。
目录
- 选择适合您图像的动画方法
- 如何一步步为图像制作动画
- 编写能保持主体稳定的运动提示词
- 准备源图像并确认其版权
- 检查帧是否存在漂移、闪烁和几何扭曲
- 修复失败的片段,无需从头开始
- 在扩大规模前确认您的第一个片段
为您的图像选择正确的动画方法
瓶子的摇摆和头部转向摄像机是不同的任务。根据需要移动的部分来选择方法,而不是选择任何看起来有电影感的预设。
| 方法 | 运动来源 | 控制程度 | 最适合 |
|---|---|---|---|
| 基于图层的运动效果 | 您移动的抠图深度图层 | 高,但仅限于2D位移 | 标志、产品照片、细微的摄像机漂移 |
| 运动迁移模型 | 另一个人的驱动视频 | 中等,跟随参考 | 肖像和说话的头部 |
| 图像到视频模型 | 文本运动提示加源图像 | 中等,取决于提示措辞 | 场景、物体和摄像机移动 |
| 运动控制扩散 | 轨迹或姿态输入 | 高,最明确的约束 | 多部分动作和编排运动 |
表格中每向上一步,您将获得更多的运动效果,但需要更多的设置、更多的审查和更多的重试。图层保持图像完整,只滑动抠图,因此标志或产品照片很少会创造出新的形状。运动迁移将驱动表演复制到肖像上,这就是为什么说话的头部效果很好,以及为什么糟糕的参考会毁掉拍摄。图像到视频模型从一句话和静态图像中创造运动,因此场景和主体都可以改变。运动控制扩散接受轨迹或姿态输入,当两个身体部位必须按顺序移动时,这是正确的工具。
运动迁移本身源于学习到的关键点,而不是手动构建的装置。一篇图像动画方法综述]追溯了从Monkey-Net的自监督关键点和密集光流,到First Order Motion Model围绕这些点的局部仿射变换的演变。
如果运动应保持在画面内部,请从图层开始。如果动作来自人物,请使用迁移。如果场景必须改变,请使用图像到视频。 姿态或路径输入适用于您在生成前可以绘制的多部分动作。模型选择和发送静态图像的调用位于AI视频生成API指南]中。
在您打开工具之前,请回答一个问题:什么必须移动,什么必须保持不变?
如何一步步制作图像动画
在批量处理任何内容之前,先在一张静态图上运行此操作。关键在于获得一个可以重复运行的片段,而不是一次碰运气的预览。
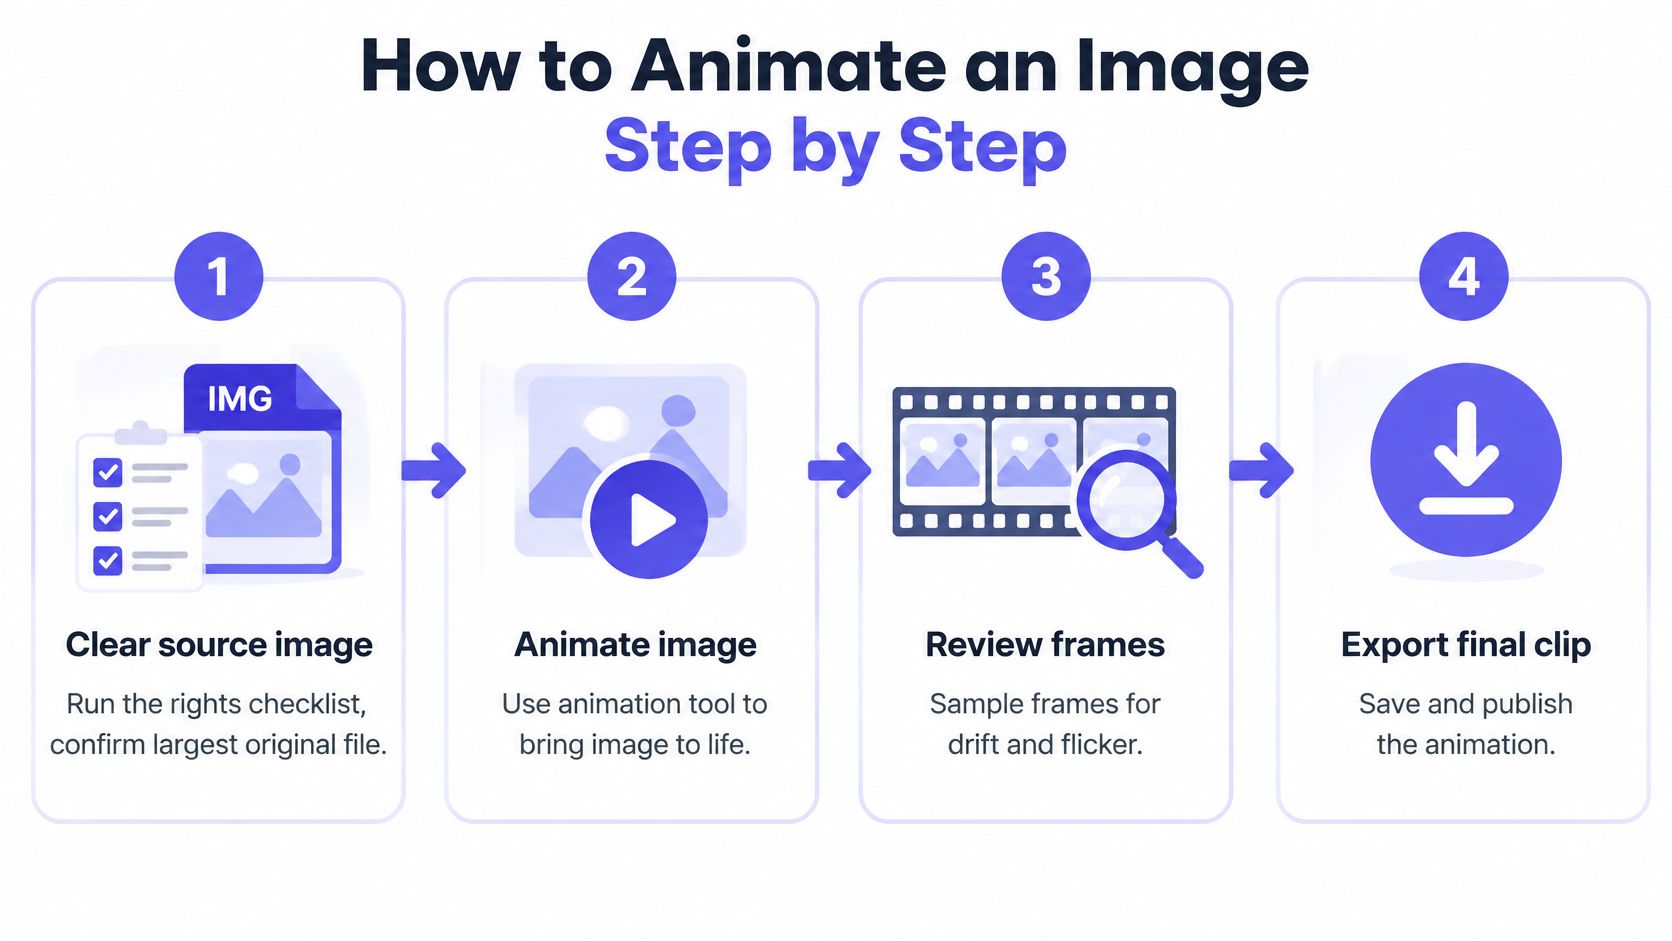
- 首先清理源文件。 稍后在本指南中运行版权清单,然后确认文件是您拥有的最大原始文件。压缩导出是画面闪烁的根源。
- 写一个动作描述句。 描述一个单一的动作,例如头部向左转动或水面泛起涟漪。一个动作更容易被接受或拒绝。
- 将时长设置为 3 到 5 秒。 较短的片段能更好地保持主体特征。五秒钟的测试足以观察到漂移,也短到可以随时舍弃。
- 选择模型并发送静态图。 将模型标识符与源图像一起传递。稍后切换模型是一项新的测试,而不是微调。
- 锁定一个 seed。 固定 seed 允许您在进行一项更改后重新运行相同的设置。没有它,您就无法区分更好的 prompt 和不同的生成结果。
- 等待任务完成,而不是等待标签页。 文本是 token by token 流式返回的,而图像和视频任务会返回一个您可以轮询或由 webhook 报告就绪的任务。在 2026年10月29日 上的一次测试中,一个 5 秒的 Kling 3.0 片段大约需要 80 秒来生成,因此请预留等待时间,以免您误以为任务失败。
- 下载并归档运行结果。 将源文件、prompt、模型标识符和 seed 一起保存。失败的输出只有在您能改变一个变量并再次尝试时才有用。
同样的想法也出现在更简单的运动中。平移和缩放列表照片 是一个有用的参考,当一个属性静态图只需要缓慢的推拉,而不是生成式的表演时。
在您第一次付费运行之前,简短地演练一下这种生成和审查的循环是值得的。
只有当片段能够播放、主体在第一帧和最后一帧中都可识别,并且动作与您编写的句子相符时,才算通过。
编写保持主体稳定的运动提示词
将提示词视为规范,而非情绪。“电影感、柔和、生动”并不能告诉模型哪个部分移动,哪个部分必须保持不动。
将摄像机运动与主体运动分开,并逐一测试。锁定摄像机而主体移动,比两者同时移动更容易保持稳定。每个片段只保留一个动作。在相同的五秒内堆叠推轨、摇摄和旋转,会导致主体身份模糊。
提交前请填写此表。
| 约束 | 需指定内容 | 示例 |
|---|---|---|
| 起始姿势 | 第一帧的姿势 | 头向左转 10 度,双臂置于身体两侧 |
| 结束姿势 | 最后一帧的姿势 | 头面向窗户,杯子与胸同高 |
| 运动轨迹 | 移动部分的路径 | 杯子以短弧线移向嘴巴 |
| 动作顺序 | 事件序列 | 先转头,然后举起杯子 |
| 接触点 | 什么接触什么 | 右手保持握住杯柄 |
| 速度或缓动 | 节奏和加速度 | 在 2 秒内缓慢缓入,无突然停止 |
假设一位穿红外套的女士将头转向窗户,用右手举起一个杯子,然后放下。摄像机保持锁定。举起动作在约两秒内缓慢缓入,并且在结束时没有突然停止。这段话就是完整的提示词。此类规范的措辞模式可在文本到视频提示词指南中找到。
实用规则: 当一个片段违反约束时,缩短运动或加强条件。不要添加更多形容词。
如果你无法在一个简短的段落中说明所有约束,那么该运动对于一个片段来说太大了。将其拆分为多个镜头。
准备源图像并明确其权利
公开照片不代表可以对其进行动画处理。无法发布的片段会浪费生成资源。
公开可用性不代表确立版权所有权、创建衍生作品的许可,或进行合成描绘的同意。关于源图像权利的指南指出,对照片进行动画处理可能会创建衍生作品,并且许可应明确涵盖修改或AI生成。摄影师、雇主或其他权利持有人可能与发布文件的人不同。同意出现在静态图像中不代表同意以动态形式出现、认可产品或发表新声明。
上传前请执行以下操作:
- 来源: 谁拍摄的,谁拥有的,以及谁发布的。
- 用途: 私人测试或商业发布。这些需要不同的许可。
- 人物: 可识别的成年人需要明确的同意。请勿对未成年人进行动画处理。
- 标志: 徽标、标签和品牌颜色需要单独的授权。
- 许可文本: 图库和知识共享条款,包括是否允许AI转换,以及是否需要署名。
然后准备像素。使用最大的原始图像,长边大约为1024像素或更多。裁剪图像,使主体清晰地位于画面中。标记您打算移动的区域。在帧审查时注意手部、文本和徽标。如果您已经在静态图像上在最终渲染前检查几何形状,请在此处执行相同的操作:源图像中的弯曲边缘在运动中也会变成弯曲边缘。通过照片编辑API进行裁剪和清理属于此步骤,在任何模型看到文件之前。
保留原始文件、许可和批准。如果列表中的任何一项不明确,请在发布前提交法律审查。许可和人格权因司法管辖区而异,因此猜测并非授权。
检查帧是否存在漂移、闪烁和几何扭曲
最常被忽视的错误是仅凭视频的首帧和尾帧来判断一个片段。端点可能匹配,但中间部分可能改变了面部、背景或肩带。
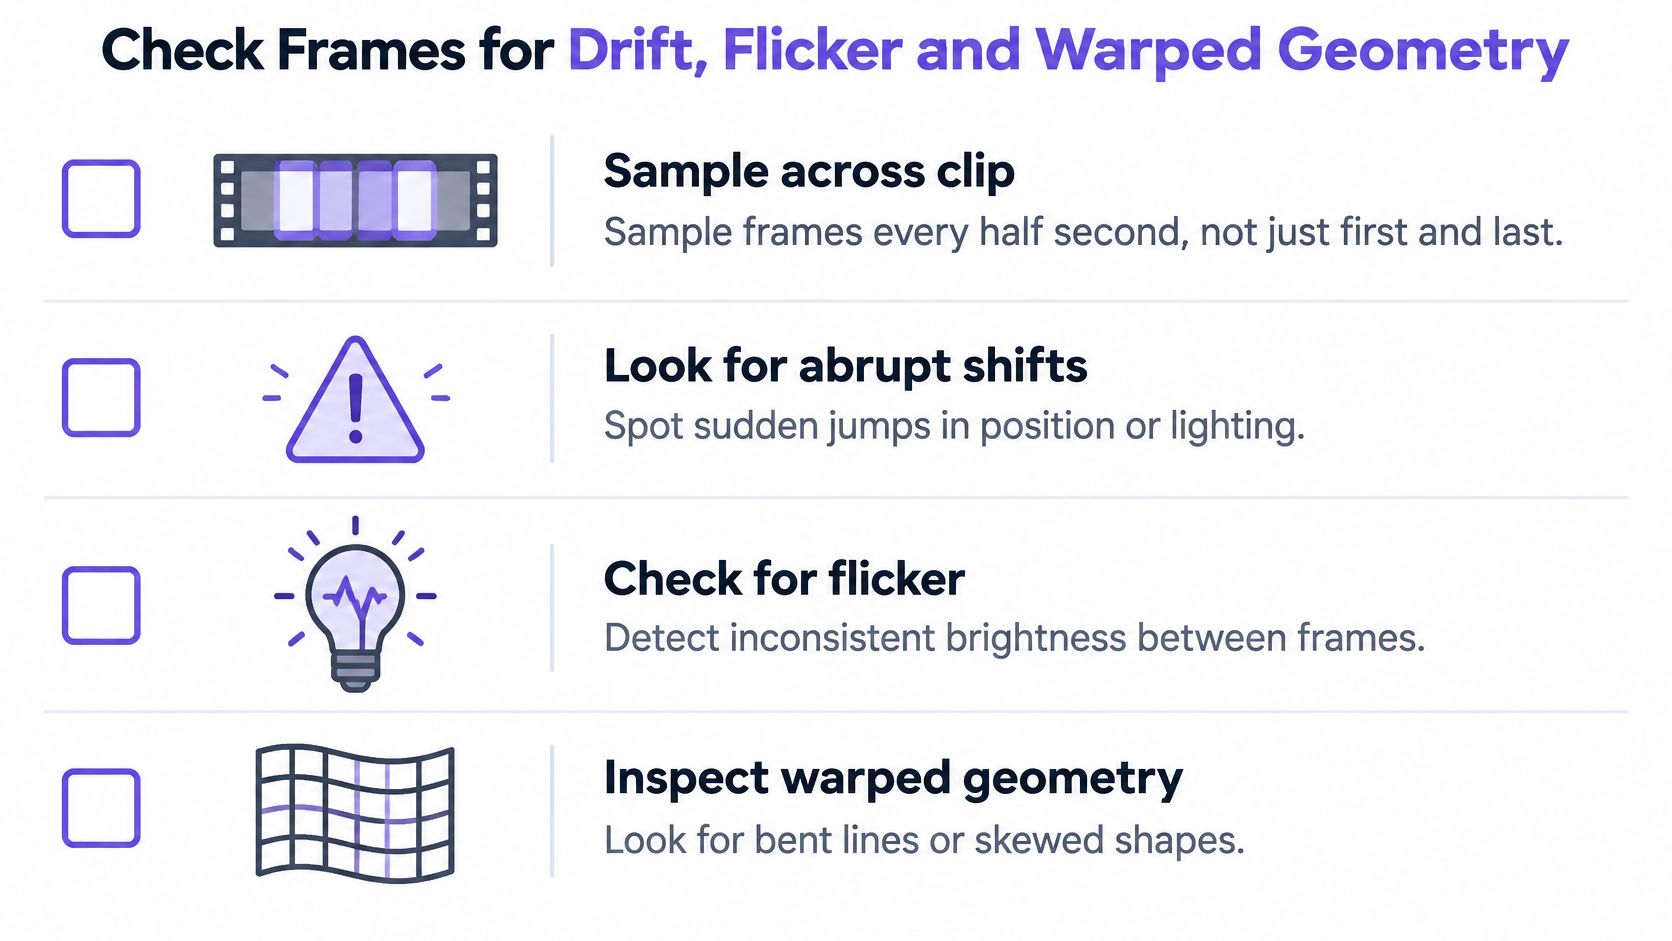
在整个片段中采样帧,大约每半秒一帧。寻找突然的过渡、身份漂移、遮挡错误和局部闪烁。不要止步于一个漂亮的开头。
分别对这些进行评分,就像 VBench 风格的评估] 将它们分开一样:
- 主体一致性: DINO 特征相似度,确保人物或产品保持同一物体。
- 背景一致性: CLIP 相似度,确保房间不会自行重绘。
- 时间闪烁: 帧间平均绝对差,即使运动看起来流畅,也能捕捉到不稳定的细节。
- 运动平滑度、动态程度和感知质量: 流畅的运动与稳定的主体不同。
一个片段可以流畅地播放,但仍可能改变主体的外观或在高频纹理中闪烁。平均值会掩盖这一点。手、脸、文字、肩带或天线等细微结构,以及任何从其他物体后面经过的东西,都需要人工检查。特征分数会将这些局部断裂模糊成一个及格数字。
当身份或背景质量下降时,即使运动看起来流畅,也要拒绝或重新生成。
在信任任何分数之前,先对静止图像进行标准化处理。移除压缩伪影,设置主体蒙版,并确定是相机还是物体应该移动。然后生成一个具有保守位移的短片段。一个长的、“更具电影感”的镜头更容易出现明显的失败,因为身份有更多的帧可以发生漂移。
修复失败的片段,无需从头开始
一个手部动作不佳的片段很少需要重新制作模型。只需更改一个变量,保留种子,然后重新运行相同的镜头。同时更改种子、提示和模型会使你难以确定是哪个因素解决了问题。
| 症状 | 可能原因 | 修复方法 |
|---|---|---|
| 面部或手部变形 | 大位移或模糊运动 | 缩短片段并降低运动强度,然后使用相同的种子重新运行 |
| 背景移动或融化 | 摄像机移动与主体运动冲突 | 锁定摄像机,只移动主体 |
| 纹理或细节闪烁 | 压缩或嘈杂的源文件 | 用更清晰的文件替换源文件并重新运行 |
| 动作顺序错误 | 缺少事件约束 | 在提示中说明顺序,或将动作拆分为更短的镜头 |
| 物体跳入或跳出 | 遮挡错误 | 遮罩物体并以更强的条件重新生成 |
TC-Bench 检查请求的过渡是否完成,在中间帧中保持一致,并保留对象身份。它使用起始帧、结束帧、中间帧和采样帧,而不是仅仅依赖于端点相似性。该研究中的程序化运动图形评估报告的失败率如下:参考姿态不匹配为 41.5%,运动轨迹不匹配为 38.75%,事件协调不匹配为 32.41%,以及链接部分和空间接触错误约为 39–40%。
| 失败类型 | 报告率 |
|---|---|
| 参考姿态不匹配 | 41.5% |
| 运动轨迹不匹配 | 38.75% |
| 事件协调不匹配 | 32.41% |
| 链接部分和空间接触错误 | 约 39-40% |
在更改分辨率或切换模型之前,运动规范错误是一种常见的失败模式,需要检查。首先修复请求的动作:明确其顺序,减少位移,或指定哪些部分应保持静止。
使用一个简短的重试阶梯。缩短运动,降低位移,加强对源文件的条件控制,然后将动作拆分为更短的镜头。将源图像、运动规范、模型标识符、种子和帧分数与任务一起保存,以便每次重试只测试一个更改。
在两次重试,每次只更改一个变量之后,停止重新生成相同的镜头。更改动画方法,或从更短的片段组装序列并手动编辑它们。
批量制作前,先确认你的第一个片段
选择一张已通过版权检查的静态图片。写一句描述动作的句子。使用 Kling 3.0 Standard 生成一个 5 秒的片段,可以通过文本生成视频或图片生成视频,这是我建议用于此测试的模型。一个余额可以覆盖文本、图片、视频和音乐模型,因此此测试不需要单独的供应商账户。视频在生成完成后按最终价格计费,这意味着一个简短的测试就能让你在批量制作前了解成本。
然后进行帧检查。对片段进行抽样检查,分别评估主体和背景,并检查手部、面部和文本。
通过: 只有当主体、背景和动作都通过时,才能批量制作。
失败: 如果在两次单次更改重试后仍有任何检查失败,请更改方法。不要再重复购买十个同样失败的片段。
保存该测试记录、源文件、prompt、模型标识符和 seed,作为后续所有片段的基准。下一个镜头应该只进行一个有意的更改,而不是凭空猜测。
UberLLM 通过一个 API key 路由图片生成视频和文本生成视频任务,你可以轮询任务状态,或者在片段准备好时接收 webhook 通知。如果你正在将静态图片转换为短小、可检查的镜头,而不是一次漫长的赌博,请从 UberLLM](https://uberllm.com) 上的单个 seeded 测试开始,并将源文件、prompt 和 seed 与结果一起保存。