Clip musical généré par IA : Comment ça marche et outils utilisés
Découvrez ce qu'est un clip musical généré par IA, comment le pipeline en quatre étapes en crée un, et quels modèles et vérifications le font fonctionner.
Les créateurs de musique devraient voir 24% de leurs revenus menacés d'ici 2028, selon l'étude d'impact économique de la CISAC, résumée par GEMA. Cette projection éclaire les clips musicaux générés par l'IA sous un jour nouveau : ils ne sont pas de simples expériences visuelles, mais des choix de production ayant des conséquences pour les artistes, les monteurs et le public.
En créer un de manière responsable demande plus qu'une invite convaincante. Il vous faut un plan de production basé sur la chanson, des clips que vous pouvez réparer indépendamment, des vérifications de synchronisation mesurables, et un compte rendu clair de ce que les personnes et les modèles ont contribué.
Table des matières
- Ce qu'est réellement une vidéo musicale générée par IA
- Les quatre étapes, de la chanson à la vidéo finale
- Modèles qui transforment les invites et les images en mouvement
- Vérification de la synchronisation labiale et de l'alignement rythmique
- Problèmes courants et comment les résoudre
- Divulguer l'implication de l'IA sans perdre la confiance
- Testez votre premier clip avant de vous engager sur une chanson complète
Ce qu'est réellement un clip musical généré par IA
Un clip musical généré par IA est un clip musical dont les visuels, la bande sonore, ou les deux, sont produits avec des modèles génératifs plutôt que d'être entièrement enregistrés ou filmés. Supposons que vous ayez enregistré une chanson sur le fait de quitter la maison : vous pourriez générer des paysages vus d'une fenêtre de train, animer un portrait du chanteur et assembler ces plans autour de votre enregistrement existant.
Dans une enquête 2026 menée aux États-Unis auprès de 1,003 créateurs de vidéos, musiciens, spécialistes du marketing et superviseurs musicaux, 19% ont utilisé l'IA générative pour trouver ou créer de la musique pour la vidéo, tandis que 32.7% avaient utilisé de la musique générée par IA comme audio final dans du contenu publié, selon Berklee. Ces mesures concernent la musique dans les flux de travail vidéo, et non la part des clips musicaux entièrement générés par IA.
Trois façons pour un projet d'utiliser l'IA
- Entièrement synthétique : La chanson et les images animées proviennent toutes deux de modèles génératifs, une personne dirigeant et sélectionnant les résultats.
- Hybride : Une piste enregistrée par un humain accompagne des scènes générées, comme la séquence de la fenêtre de train.
- Assisté par IA : Vous filmez la performance, puis utilisez l'IA pour le montage ou les effets. Ce n'est pas nécessairement un clip généré par IA au sens strict.
Considérez la chanson comme la partition et les prompts comme une liste de plans qu'un modèle interprète. Vous êtes toujours responsable de décider ce qui apparaît à l'écran.
Le Text-to-video transforme des instructions écrites en un clip. L'Image-to-video anime une image fixe fournie. Un segment est une partie délimitée de la chanson, un shot prompt dirige son imagerie, et le montage final combine le matériel sélectionné.
Avant de choisir les outils, nommez les parties de votre projet : enregistrement, voix, paroles, images de référence, plans générés et montage. Indiquez celles qui sont faites par des humains et celles que vous générerez. Ce simple inventaire vous indique quelle version vous êtes en train de créer.
Les quatre étapes : de la chanson à la vidéo finale
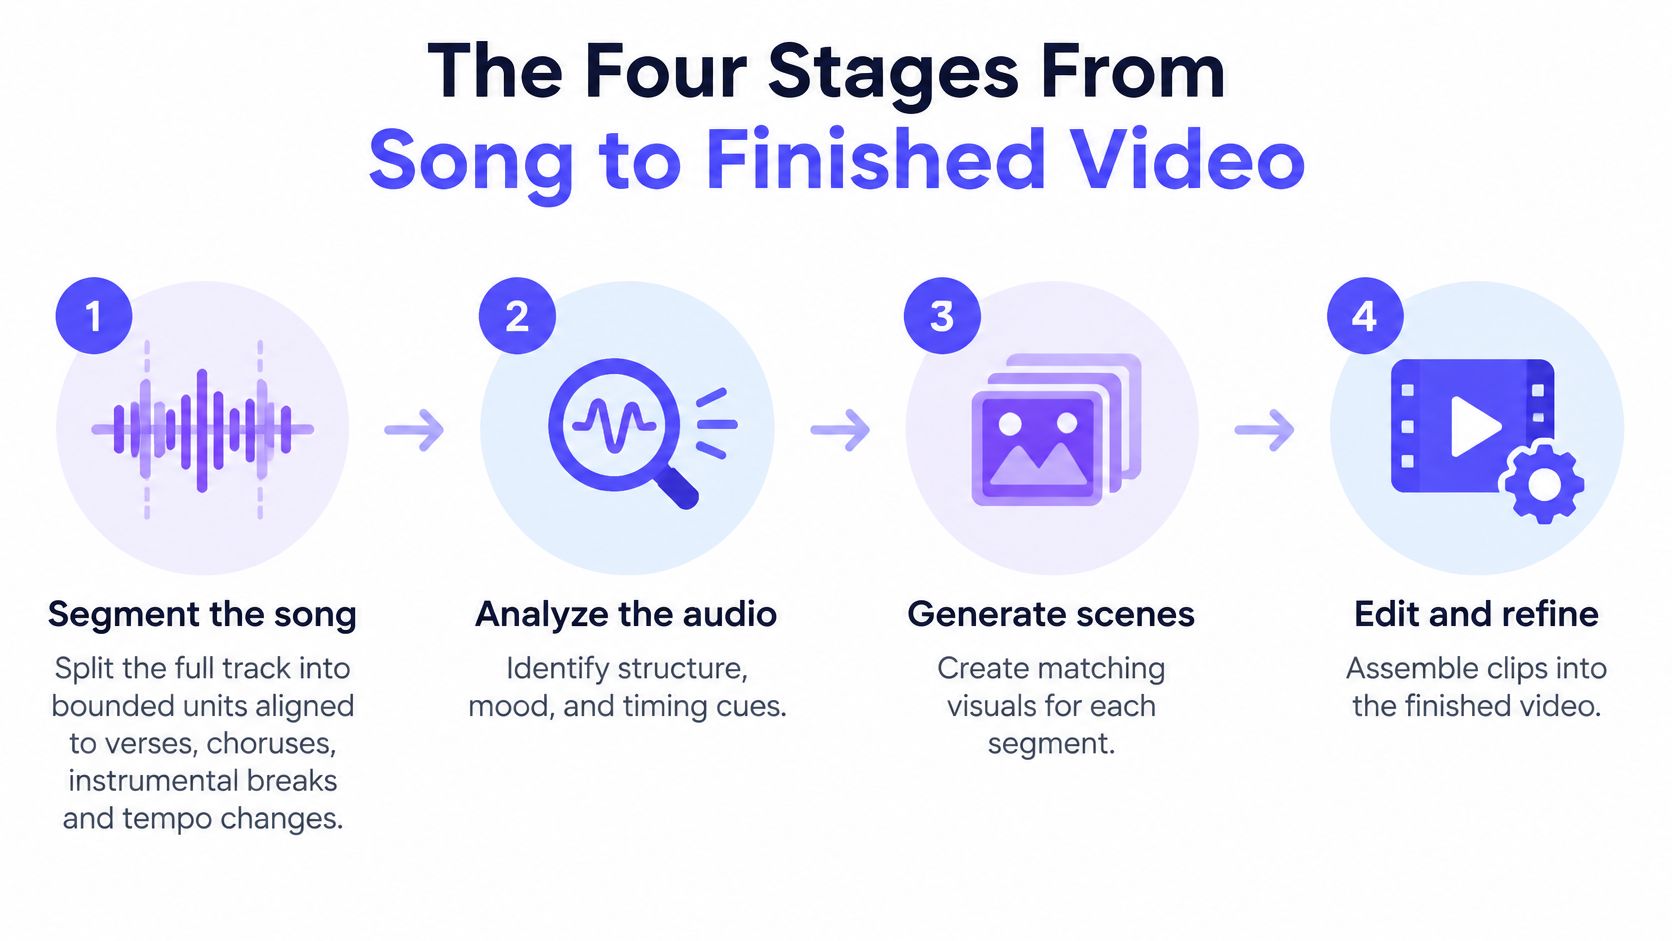
Une production de la durée d'une chanson est plus facile à contrôler si vous la traitez comme une collection de tâches gérables. Le pipeline Du son à l'image publié suit la segmentation de la chanson, l'analyse audio et la génération de script, la génération de texte en vidéo, et l'assemblage final.
Le flux de travail ci-dessous sépare les décisions créatives des tâches de rendu.
Construire autour de la structure musicale
Segmenter la chanson. Marquez les couplets, les refrains, les pauses musicales et les changements de tempo, puis divisez-les en unités de génération délimitées. Une section musicale peut contenir plusieurs plans, ne confondez donc pas une étiquette de refrain avec l'exigence de générer un clip continu.
Analyser l'audio et écrire le script visuel. Identifiez le tempo, l'énergie, les passages vocaux et les changements d'ambiance, puis attribuez un prompt de plan à chaque segment. Pour la chanson de départ, un couplet calme pourrait utiliser une scène de plateforme statique, tandis que le refrain introduit un mouvement vers l'avant.
Générer les clips. Utilisez le text-to-video pour les scènes décrites indépendamment ou l'image-to-video lorsqu'une référence visuelle fournie est importante. Examinez chaque résultat par rapport à son objectif assigné avant de l'accepter dans le montage.
Assembler le montage final. Placez les clips approuvés dans un ordre déterministe par rapport à la piste maîtresse. Standardisez le frame rate, la résolution, l'aspect ratio et le loudness final afin que les sorties mixées se comportent comme une seule production.
Étapes du pipeline, entrées et sorties
| Étape | Entrée | Sortie |
|---|---|---|
| 1. Segmenter la chanson | Piste complète avec horodatages | Segments délimités avec timecodes et étiquettes |
| 2. Analyser l'audio et écrire le script | Segments, tempo, repères vocaux | Un prompt de plan par segment |
| 3. Générer les clips | Prompts de plan, images de référence optionnelles | Un court clip par segment, avec seed et version du modèle stockés |
| 4. Assembler le montage final | Clips et piste originale | Un rendu à frame rate constant avec loudness normalisé |
Rendre chaque segment récupérable
Les clips délimités aident à limiter la dérive temporelle, où les objets, les identités ou les actions changent à mesure qu'une séquence générée se poursuit. Ils vous permettent également de remplacer un plan faible sans jeter une séquence réussie.
Stockez un manifeste de production contenant le timecode, l'étiquette lyrique ou musicale, le tempo, l'énergie, le prompt de plan, le seed, la version du modèle et l'emplacement de sortie de chaque segment. Conservez les identifiants des images de référence à côté de cet enregistrement, le cas échéant. Un seed aide à documenter une exécution, mais ce n'est pas une garantie de résultats identiques lors des mises à jour du modèle.
Règle de production : Traitez le manifeste de segment comme votre projet éditable, pas seulement comme un journal des téléchargements terminés.
Pour un compagnon pratique à la planification et à l'assemblage, le guide de production de vidéoclips d'AIMVG fournit une référence de flux de travail utile. Les développeurs implémentant la couche de rendu peuvent utiliser le guide de l'API de génération vidéo IA pour connecter ces enregistrements de segments aux tâches de génération.
Modèles qui transforment les invites et les images en mouvement
Le texte-vers-vidéo vous donne de la marge pour inventer ; l'image-vers-vidéo vous offre un point de départ visuel. Cette distinction est plus importante que de choisir un seul modèle pour une chanson entière.
Avec le texte-vers-vidéo, vous décrivez le sujet, le décor, l'action, la caméra et l'éclairage. C'est utile pour les paysages, l'imagerie symbolique et les plans d'établissement où un visage récurrent exact n'est pas essentiel. Des générations indépendantes peuvent interpréter la même description différemment, donc une formulation répétée seule ne devrait pas être votre stratégie de contrôle d'identité.
L'image-vers-vidéo commence avec une image fixe que vous fournissez. Elle peut ancrer les vêtements, la composition et l'apparence faciale, mais elle ne fige pas chaque image ultérieure. Un mouvement ou un angle de caméra difficile peut toujours produire des changements indésirables.
Adaptez l'entrée au plan
Pour un chanteur récurrent, préparez une image de référence nette avec un visage dégagé et des vêtements lisibles. Synchronicity Labs sur l'image-vers-vidéo est un compagnon utile pour décider comment transformer une image fixe en un plan en mouvement dirigé.
Les familles suivantes proposent des candidats de départ, pas un classement de qualité. Considérez chaque rôle comme quelque chose à tester avec votre propre matériel, et vérifiez les entrées prises en charge par l'endpoint actuel avant de soumettre.
Familles de modèles par mode d'entrée et rôle dans un clip musical
| Modèle | Mode d'entrée | Rôle typique dans un clip musical | À surveiller |
|---|---|---|---|
| Kling 3.0 Standard | Texte vers vidéo ou image vers vidéo | Plans polyvalents et un candidat initial | Vérifiez les limites de durée des clips avant de planifier les segments |
| Veo 3.1 Fast | Texte vers vidéo | Itération sur l'ambiance et les plans d'établissement | Vérifiez la résolution actuelle et les options audio |
| Seedance 2.0 | Image vers vidéo | Plans d'artiste ou de personnage ancrés à une image fixe | Nécessite une image de référence nette |
| Wan 2.6 | Texte vers vidéo | Segments instrumentaux et abstraits | Inspectez la continuité du mouvement avant d'accepter |
| PixVerse V5.6 | Texte vers vidéo | Segments stylisés ou expérimentaux | Vérifiez que la stylisation préserve les détails requis |
Séparez l'apparence de la performance
Un visage visuellement cohérent n'est pas automatiquement une performance de chant. Les modèles de synchronisation labiale et pilotés par l'audio gèrent le mouvement de la bouche par rapport à l'audio fourni ; l'animation d'image ordinaire ne devrait pas être supposée faire ce travail.
Une combinaison pratique est le texte-vers-vidéo pour les passages atmosphériques, l'image-vers-vidéo pour les plans d'artiste récurrents, et une étape pilotée par l'audio pour le chant visible. Vous pouvez également éviter complètement les gros plans de performance si le concept fonctionne mieux comme narration ou visualiseur.
Gardez les invites axées sur l'action observable. Le guide d'invites texte-vers-vidéo peut aider à traduire une ambiance abstraite en direction de caméra et en mouvement du sujet. Les limites de clip, les options de résolution et le temps de génération changent entre les versions, alors choisissez le modèle en fonction des exigences du segment, et non de la familiarité avec la marque.
Vérification de la synchronisation labiale et de l'alignement rythmique
Un beau visage peut toujours chanter la mauvaise syllabe. La fidélité visuelle et la synchronisation audiovisuelle sont des critères d'acceptation distincts : le document d'évaluation de la synchronisation labiale examine 615 clips générés et utilise des mesures telles que la Distance des points de repère (LMD) et la Confiance d'erreur de synchronisation labiale (LSE-C) pour évaluer le mouvement de la bouche et la correspondance audio.
La LMD mesure l'erreur des points de repère de la région buccale par rapport au mouvement attendu. La LSE-C estime la confiance que le mouvement des lèvres correspond à la piste vocale. Aucune des deux ne doit être traitée comme un score artistique complet, et une mesure orientée vers la parole nécessite une interprétation prudente lorsqu'elle est appliquée au chant soutenu, aux chœurs ou aux formes de bouche expressives.
Exécuter les vérifications dans l'ordre
- Extraire les horodatages des battements et des débuts. Utilisez un outil d'analyse audio pour identifier les positions rythmiques et les attaques de notes. Marquez les événements qui nécessitent une coupe ou un accent de mouvement, plutôt que de forcer chaque battement à devenir une transition.
- Marquer les segments vocaux. Identifiez où un interprète visible devrait chanter. Utilisez l'extrait vocal correct et préservez son décalage par rapport à la piste principale.
- Évaluer et inspecter chaque clip. Appliquez des mesures liées à la bouche au chant visible, puis évaluez le timing et l'adéquation musicale. Regardez à vitesse normale ainsi qu'image par image.
- Regénérer uniquement les segments échoués. Enregistrez si l'échec concerne le timing, l'articulation, la qualité de l'image ou l'interprétation musicale avant de demander un remplacement.
Vérifications de synchronisation et où chacune s'applique
| Vérification | Ce qu'elle mesure | S'applique à |
|---|---|---|
| Erreur des points de repère de la bouche (LMD) | Distance des points de repère de la région buccale par rapport au mouvement attendu | Segments vocaux |
| Confiance de synchronisation labiale (LSE-C) | Si le mouvement des lèvres correspond à la piste vocale | Segments vocaux |
| Alignement des battements ou des débuts | Si les coupes et les accents de mouvement tombent sur des événements musicaux | Chaque limite de segment |
| Correspondance rythme et ambiance | Si le rythme et le ton du mouvement suivent la piste | Segments instrumentaux |
Définir des seuils avant le rendu final
Il n'y a pas de score de réussite universel fourni pour chaque chanteur, style ou modèle. Calibrez vos seuils en utilisant des clips que vous avez examinés et acceptés, puis maintenez ces paramètres cohérents au sein du projet.
- Seuil de mouvement de la bouche : Rejeter le chant visible présentant une erreur d'articulation inacceptable ou une faible confiance de synchronisation.
- Seuil de timing : Rejeter les ratés involontaires lors des événements musicaux désignés.
- Seuil de cohérence de mouvement : Rejeter les mouvements qui contredisent le rythme, l'ambiance ou le sujet prévu.
- Seuil perceptuel : Rejeter la distorsion faciale gênante même lorsqu'un score numérique semble acceptable.
Supposons que la bouche du chanteur suive les bons mots mais que toute la performance commence en retard. Corrigez le décalage du clip avant de commander une nouvelle performance. Si le timing est correct mais que la bouche articule des sons différents, une simple édition ne le réparera pas.
Une coupe délibérée avant le battement peut fonctionner. Une coupe accidentelle après l'accent prévu est une erreur de production.
Enregistrez les scores et les notes de révision avec l'enregistrement du segment. Cela vous donne une raison pour chaque rejet et rend la sélection de remplacement moins arbitraire.
Problèmes courants et comment les résoudre
Lorsqu'un personnage change de tenue ou de visage entre les plans, examinez d'abord le matériel source et les instructions de génération. N'essayez pas de masquer chaque incohérence d'identité avec une transition. Décidez si le problème relève de la référence, de la performance générée ou de l'assemblage.
Diagnostiquer avant de régénérer
Problèmes de production courants, causes et solutions
| Symptôme | Cause probable | Solution |
|---|---|---|
| Les personnages changent entre les plans | Dérive du prompt entre segments indépendants | Utilisez l'image-vers-vidéo avec une image de référence fixe par personnage |
| La bouche n'est pas synchronisée avec les voix | Le timing du segment ne correspond pas à la piste vocale | Régénérez le segment avec des timecodes corrigés et revérifiez la confiance de la synchronisation labiale |
| Les coupes ne tombent pas sur le rythme | Limites définies à l'œil, et non par les débuts détectés | Recoupez sur les horodatages de début lors de l'assemblage |
| Scintillement ou morphing dans les clips longs | Clip plus long que la stabilité du modèle | Utilisez des segments plus courts et joignez-les au montage |
| La couleur ou la fréquence d'images diffère entre les clips | Paramètres de sortie mélangés | Normalisez la fréquence d'images, la résolution et le rapport d'aspect à l'assemblage ; faites correspondre la couleur séparément |
| Volume sonore inégal entre les coupes | Pas de normalisation du volume sur le mixage final | Normalisez le volume sur l'ensemble du montage |
| Un clip a échoué après un crash | Relance du projet entier utilisée au lieu de la récupération de segment | Régénérez uniquement ce segment à partir de sa graine et de ses métadonnées stockées |
Séparer les réparations de montage des changements de conception
Les réparations d'assemblage incluent le déplacement d'une coupe, la correction d'un décalage, l'harmonisation des couleurs ou la correction d'un paramètre d'exportation. Essayez-les avant de payer pour de nouvelles images. Le recadrage peut résoudre un problème de cadrage, mais prévisualisez attentivement le résultat pour ne pas supprimer les mains d'un chanteur ou couper une action importante.
Les réparations de génération nécessitent un nouveau clip car le contenu réel est incorrect. Les exemples incluent un visage qui se transforme, une articulation incorrecte ou un mouvement de caméra qui obscurcit le sujet. Modifiez l'instruction spécifique qui a échoué plutôt que de réécrire l'intégralité du prompt.
Les réparations de concept nécessitent une réflexion plus large. Si chaque plan dépend d'une chorégraphie complexe que l'approche choisie ne peut pas préserver, simplifiez la performance ou passez à un traitement narratif.
Pour les travaux basés sur des références, le guide capture d'écran-vers-vidéo offre un point de départ utile pour transformer une image préparée en mouvement. Inspectez d'abord l'image fixe : le flou intégré, les visages obstrués et l'anatomie confuse sont de mauvaises bases pour l'animation.
Gardez la chanson comme piste maîtresse continue, sauf si votre arrangement change intentionnellement. L'audio de clip accidentel peut introduire des sauts de volume même lorsque l'enregistrement original est cohérent. Après un crash, récupérez les fichiers terminés et reprenez à partir du segment échoué plutôt que de considérer l'ensemble de la production comme perdue.
Divulguer l'implication de l'IA sans perdre la confiance
Assisté par l'IA et généré par l'IA décrivent des contributions différentes. Une performance humaine avec un nettoyage par l'IA n'est pas la même chose qu'un chanteur synthétique, et une étiquette générique peut obscurcir cette distinction plutôt que de la clarifier.
Conservez un registre des contributions d'enregistrement et d'édition pendant que vous travaillez.
Dans une expérience 2025 avec 120 participants, un audio identique a reçu des évaluations plus élevées en termes d'appréciation, d'engagement, d'impact émotionnel et de qualité lorsqu'il était attribué à un pianiste humain, et 79% ont déclaré avoir remarqué des différences, selon l'étude sur la paternité audiovisuelle. C'est une raison de rédiger la divulgation avec soin, pas une justification pour dissimuler des contributions matérielles.
Étiquetez la contribution, pas seulement le projet
- Musique et paroles : Indiquez séparément si la composition ou les paroles ont été générées.
- Voix : Identifiez une voix chantée synthétique plutôt que d'impliquer une performance humaine enregistrée.
- Visuels : Distinguez les scènes générées des séquences filmées.
- Montage : Décrivez le nettoyage ou les effets de l'IA sans suggérer que la performance sous-jacente était synthétique.
Pour un projet hybride, une description pourrait indiquer que l'artiste a écrit et interprété la chanson, tandis que les visuels ont été générés par l'IA et édités par des humains. Pour un chanteur synthétique, rendez ce fait suffisamment visible pour que les spectateurs ne confondent pas la performance avec un enregistrement de la personne représentée.
Principe de divulgation : Soyez précis sur ce qui a été généré et tout aussi précis sur ce que les humains ont créé.
Utilisez le titre lorsque la paternité synthétique est au cœur de la prémisse, la description pour les détails de la contribution, et les crédits ou une carte de fin pour le registre de production complet. Suivez les exigences de la plateforme applicables plutôt que de considérer le placement comme un pur choix marketing.
Pour une référence visuelle supplémentaire, la vidéo intégrée est disponible ci-dessous.
Testez une formulation véridique par rapport au temps de visionnage, à l'achèvement, aux commentaires et à la confiance du public, marché par marché. Gardez les faits sous-jacents inchangés d'un test à l'autre. Une étiquette qui améliore les clics mais laisse les spectateurs confus quant au chanteur n'est pas une divulgation réussie.
Testez votre premier extrait avant de vous engager sur une chanson complète
Commencez par un passage qui peut révéler votre problème de production le plus difficile. Un refrain avec un chant visible et un accent rythmique clair est plus informatif qu'un décor atmosphérique si la vidéo finale dépend de gros plans de performance.
Effectuez un petit test d'acceptation
Choisissez un extrait représentatif. Par exemple, vous pourriez tester un passage de refrain de dix à quinze secondes, à condition que l'endpoint sélectionné prenne en charge cette durée. Incluez à la fois une phrase vocale et un événement musical que vous souhaitez accentuer.
Choisissez l'approche d'entrée. Nous recommandons Kling 3.0 Standard comme premier modèle vidéo à utiliser, en utilisant le text-to-video ou l'image-to-video. Choisissez une prise de vue basée sur une référence lorsque la reconnaissabilité est essentielle.
Rédigez un prompt de prise de vue ciblé. Spécifiez le sujet, l'action, le cadrage, le mouvement de caméra et l'éclairage. Évitez de combiner un changement de lieu, un changement de costume et une performance complexe dans le même essai.
Générez et suivez la tâche. Nos tâches d'image et de vidéo renvoient une tâche que vous pouvez interroger (poll), ou vous pouvez configurer un webhook pour notifier votre application lorsque le résultat est prêt. Dans un outil web, utilisez sa vue de progression au lieu de soumettre des tâches en double pendant l'attente.
Appliquez les vérifications d'acceptation. Inspectez le chant visible, les accents rythmiques désignés, l'identité et les artefacts distrayants. Enregistrez la catégorie d'échec plutôt que d'accepter un extrait parce qu'il semble impressionnant.
Passez à l'échelle uniquement après acceptation. Intégrez la structure de prompt réussie et les choix de référence dans votre plan de segment. Conservez le résultat du test comme comparaison pour les prises de vue ultérieures.
Utilisez l'interface pour inspecter les contrôles disponibles avant de soumettre une requête de génération.
Vérifiez le coût avant de passer à l'échelle
Examinez les tarifs et les politiques d'échec avant de soumettre. Notre réponse à une requête vidéo indique le coût maximal avant le début de la génération ; une vidéo terminée est facturée à son prix final, et les générations échouées ne sont pas facturées.
Si le test réussit à la fois la vérification de synchronisation labiale pertinente et vos vérifications de rythme désignées, passez au plan de segment complet. S'il échoue, corrigez d'abord les erreurs de timing, puis changez le modèle ou l'image de référence lorsque le contenu généré est le problème. Retestez avant de multiplier ce choix sur toute la chanson.
UberLLM offre un accès aux modèles vidéo, image, musique et parole via une API unifiée, afin que vous puissiez construire les différentes étapes d'un pipeline de clip musical sans maintenir une intégration différente pour chaque fournisseur. Visitez UberLLM pour comparer les options de modèle et exécuter un extrait représentatif avant de vous engager dans une production de chanson complète.