Comment choisir et intégrer une API de génération d'images
Comparez les capacités des API de génération d'images, les champs de requête, les résultats asynchrones, les tests de modèles, la gestion des erreurs et la facturation, avec les étapes pour l'intégration en production.
Plus de 15 milliard d'images avaient été créées avec des algorithmes de texte-vers-image en août 2023,, soit une moyenne d'environ 34 millions par jour depuis le lancement de DALL-E 2, selon une analyse Everypixel des statistiques d'images IA. La même analyse attribue environ 12.6 milliards d'entre elles, soit environ 80%, aux modèles, services et applications basés sur Stable Diffusion.
À ce volume, la génération d'images cesse d'être une démo créative pour devenir une infrastructure. Les questions qui décident si un produit est livré ne portent plus sur le modèle qui peint les plus jolies images, mais commencent à concerner les contrats de requête, les états des tâches, le comportement en cas de timeout, et si une génération échouée figure toujours sur votre facture.
Ceci est un guide pour les développeurs sur la couche API de génération d'images. Il couvre la façon dont les requêtes sont structurées, comment les tâches évoluent au cours d'un cycle de vie, comment tester un modèle au lieu de faire confiance à un classement, et où se cachent les coûts. Le prix par image est le chiffre le plus facile à comparer et le moins utile en soi.
Table des matières
- Capacités de l'API de génération d'images en un coup d'œil
- Modèles de requêtes et champs de réponse
- Tâches asynchrones, états des tâches et récupération des résultats
- Critères de sélection des modèles et comment les tester
- Vérification de la fidélité et de la provenance des modifications avant le lancement
- Latence, erreurs et comportement de réessai en production
- Comment intégrer une API d'image étape par étape
- Unités de facturation et comment comparer les coûts réels
- Effectuer un appel test avant de choisir votre modèle
Capacités de l'API de génération d'images en un coup d'œil
| Capacité | Entrée | Sortie | Modèle de récupération |
|---|---|---|---|
| Génération de texte | messages et paramètres | texte en streaming | réponse en streaming |
| Texte vers image | prompt, taille, identifiant de modèle | une ou plusieurs images | tâche, interrogée ou webhook |
| Édition d'image | image source, instruction, masque optionnel si pris en charge | image éditée | tâche, interrogée ou webhook |
| Texte vers vidéo | prompt, durée, résolution | fichier vidéo | tâche, interrogée ou webhook |
| Image vers vidéo | image source, prompt, durée | fichier vidéo | tâche, interrogée ou webhook |
| Génération de musique | prompt, style, durée | fichier audio | tâche, interrogée ou webhook |
| Synthèse vocale | texte, voix | fichier audio | audio en streaming ou fichier retourné |
Un seul endpoint et une seule clé peuvent couvrir plusieurs familles de modèles à la fois, car l'identifiant de modèle est ce qui sélectionne la famille et la version. Cette commodité a un revers. Chaque famille accepte un ensemble de paramètres différent, de sorte qu'un corps de requête valide pour un modèle peut échouer sur un autre, et les tailles, masques, prise en charge des seeds et limites de sorties multiples diffèrent entre eux.
Une API de génération d'images est un service d'inférence hébergé composé de trois parties : un contrat de requête qui transforme un prompt et des paramètres en un appel signé, un objet de résultat qui contient l'image et ses métadonnées, et un cycle de vie de tâche pour les opérations qui dépassent une seule réponse HTTP. Chaque partie nécessite ses propres décisions de conception, et chacune échoue différemment.
Le modèle est plus récent qu'il n'y paraît. La sortie publique de Stable Diffusion le 22 août 2022 a établi la forme de service que la plupart des fournisseurs utilisent encore, comme TechCrunch l'a rapporté lors du lancement : une application envoie un prompt et des paramètres, le fournisseur exécute le travail GPU, et une image ou une tâche est renvoyée. Ce modèle fonctionnait sur du matériel grand public haut de gamme et produisait des images de 512×512 pixels en quelques secondes, entraîné sur LAION-5B, un ensemble de données d'environ 5.85 milliards de paires image-texte avec un sous-ensemble filtré esthétiquement d'environ 600 millions. Stability AI a affirmé que plus de 15,000 testeurs généraient environ 2 millions d'images par jour pendant l'accès public anticipé, ce qui est le signal précoce le plus clair que l'accès hébergé, et non les logiciels de bureau, était la forme de la demande.
Les sections suivantes suivent l'ordre dans lequel une intégration réelle rencontre ces problèmes : champs de requête et objets de réponse d'abord, puis états de tâche asynchrones, tests de sélection de modèle, fidélité et provenance de l'édition, latence et tentatives, intégration étape par étape, unités de facturation, et un appel de test final. Les équipes qui intègrent des générations dans un pipeline automatisé veulent généralement que la boucle complète soit démontrée une fois, et cette présentation d'une API d'image pour les workflows d'automatisation montre le cycle complet, du déclencheur à l'actif stocké.
Modèles de requêtes et champs de réponse
La plupart des premières intégrations échouent au niveau du corps de la requête, et rarement à cause du prompt. Construisez les champs dans l'ordre où ils sont transmis et le débogage sera plus rapide.
- Identifiant du modèle. Pensez-y en premier, car il détermine quels champs restants sont valides. Un prompt négatif ou un masque accepté par un modèle sera rejeté par le suivant.
- Prompt et prompt négatif. Le prompt négatif est un champ pris en charge par certaines familles de modèles et ignoré par d'autres, alors vérifiez plutôt que de supposer.
- Taille ou rapport d'aspect. Exprimez-le comme le modèle l'attend, en pixels ou en rapports nommés. Validez-le localement avant l'inférence, car un appel rejeté coûte un aller-retour, tandis qu'une génération qui échoue tardivement coûte un timeout et un emplacement dans la file d'attente.
- Nombre de sorties. Plusieurs sorties par appel semblent efficaces jusqu'à ce que vous remarquiez que la facturation est généralement proportionnelle au nombre de sorties, et non à l'appel lui-même.
- Format de sortie. PNG, JPEG ou WebP modifie votre travail de conversion en aval autant que votre nombre d'octets.
- Seed. Incluez-le chaque fois que la reproductibilité est importante. Sans lui, « relancer ça » signifie « relancer les dés ».
- Webhook URL. Les tâches longues se terminent après le retour de votre requête, et un callback est moins coûteux qu'une boucle de polling intensive.
- Idempotency key. La génération est coûteuse, donc une nouvelle tentative de création sans clé devient une deuxième tâche facturée et une image en double.
Validez avant de dépenser. Vérifiez d'abord le rapport d'aspect, l'identifiant du modèle et les champs requis dans votre propre code. Une vérification locale du schéma détecte la classe d'erreurs qui, autrement, apparaîtrait comme un 400 après une attente dans la file d'attente, et elle empêche complètement le trafic malformé d'atteindre un endpoint mesuré.
Le côté réponse est l'endroit où les équipes perdent des actifs qu'elles ont déjà payés. La référence de l'API d'image d'OpenAI montre la forme sur laquelle la plupart des fournisseurs convergent : un objet image avec une charge utile base64, une URL hébergée et, le cas échéant, un prompt révisé. Normalisez ce que le fournisseur renvoie dans votre propre schéma stable, et conservez un bloc de métadonnées brutes du fournisseur pour les contrôles que votre schéma ne modélise pas encore.
| Champ | Contenu | Note de production |
|---|---|---|
| URL de l'actif | lien vers le fichier généré | de courte durée et à accès contrôlé, donc téléchargez-le avant qu'il n'expire |
| b64_json | octets d'image encodés en base64 | convient pour les petites réponses synchrones, gourmand en mémoire pour les charges utiles importantes |
| revised_prompt | le prompt tel que le modèle l'a reformulé | stockez-le, car il explique les sorties inattendues |
| Identifiant du modèle | le modèle et la version qui ont produit la sortie | requis pour l'audit et la reproduction |
| Dimensions et format | largeur, hauteur et type MIME | confirmer par rapport au rapport d'aspect demandé |
| Checksum | hachage d'intégrité du fichier | vérifier après le téléchargement et après toute conversion de format |
Traitez base64 comme un détail de transport, pas comme une stratégie de stockage. Une image encodée gonfle la charge utile d'environ un tiers et reste en mémoire pendant que votre application analyse le JSON. Pour les médias de production, écrivez les octets décodés dans un stockage d'objets et fournissez plutôt à votre front-end une URL de récupération signée. Ajoutez le type MIME et un checksum à l'enregistrement pendant que vous y êtes, afin qu'un téléchargement corrompu soit détecté par votre pipeline plutôt que par un utilisateur.
La règle que j'imposerais en revue de code : chaque actif stocké doit contenir l'identifiant du modèle, le seed, le prompt effectif et l'horodatage de la requête dans ses métadonnées. Sans ces quatre éléments, un ticket de support concernant « une image bizarre du mois dernier » n'aura pas de réponse.
Cette habitude est payante la première fois qu'une version de modèle change et que la sortie dérive. Les métadonnées stockées transforment une plainte vague en une comparaison que vous pouvez exécuter.
Tâches asynchrones, états des tâches et récupération des résultats
Le traitement d'images et de vidéos n'est pas renvoyé dans une complétion de chat. Créez une tâche, conservez l'identifiant, puis suivez son évolution.
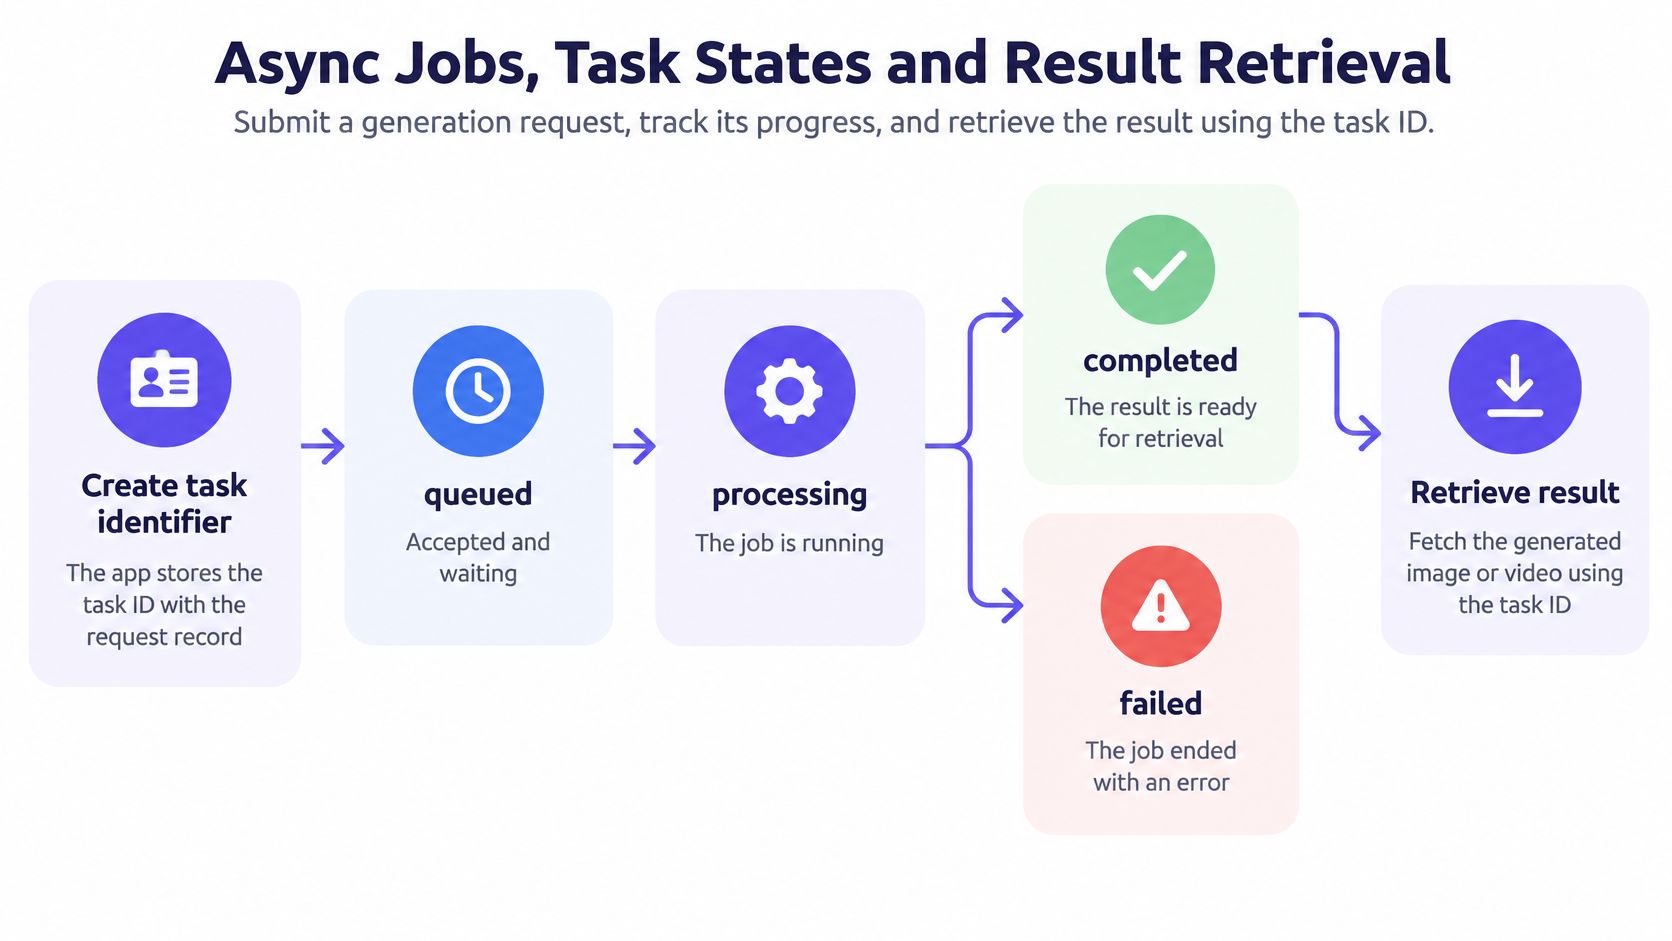
L'appel de création renvoie un identifiant de tâche, et votre application l'écrit dans le même enregistrement de requête qui contient le prompt et le modèle. À partir de là, la tâche signale l'un des cinq états, et chacun demande quelque chose de différent à votre code.
| État | Signification | Ce que fait l'application |
|---|---|---|
| en file d'attente | acceptée et en attente de capacité | conservez l'ID de tâche et effectuez un poll selon un calendrier |
| en cours d'exécution | génération en cours | attendez, et appliquez un timeout dimensionné pour la modalité |
| réussie | la sortie est prête | téléchargez et stockez l'actif immédiatement |
| échouée | la génération n'a pas abouti | lisez la catégorie d'erreur avant toute nouvelle tentative |
| expirée | la sortie n'est plus récupérable | régénérez, et ne le traitez pas comme un résultat manquant |
L'état expirée prend les équipes au dépourvu car cela ressemble à un bug dans leur propre système. Ce n'en est pas un. Les fournisseurs conservent les fichiers de résultats pendant une fenêtre limitée, et cette fenêtre est courte. Sur UberLLM, les liens d'images restent actifs pendant environ 15 minutes, et les fichiers de résultats vidéo et musicaux sont conservés pendant environ 3 heures après la fin de la tâche. Une boucle de polling qui vérifie toutes les dix minutes et agit au prochain cycle de déploiement manquera entièrement les liens d'images.
La récupération repose sur deux mécanismes, et les systèmes matures utilisent les deux. Le polling couvre les livraisons qu'un webhook a manquées, et c'est la seule option lorsque votre service ne peut pas exposer un endpoint public. Les webhooks réduisent les requêtes inutiles en vous indiquant exactement quand l'état a changé, ce qui est important lorsqu'une tâche prend une minute plutôt qu'une seconde. Les compromis entre webhooks et polling se résument à la gestion des échecs : les webhooks échouent lorsque votre récepteur est hors service, et le polling échoue de manière coûteuse lorsque votre intervalle est trop serré.
Les intervalles de polling devraient suivre la modalité, pas la base de code. Une seule boucle fixe qui fonctionne pour une tâche d'image de 4 secondes gaspille des dizaines d'appels sur une tâche vidéo qui dure une minute ou plus.
Les réponses textuelles sont streamées token par token, tandis que les tâches d'image et de vidéo vous confient une tâche que vous pollez ou qu'un webhook signale comme prête. Cette différence est architecturale, pas cosmétique : la requête qui renvoie instantanément possède toujours un travail qui n'est pas terminé, et quelqu'un doit s'en souvenir. Enregistrez les temps de transition d'état ainsi que l'état final, car l'écart entre en file d'attente et en cours d'exécution est l'endroit où les problèmes de capacité apparaissent avant d'atteindre les utilisateurs.
Critères de sélection des modèles et comment les tester
Les classements publics évaluent les modèles sur des prompts que personne dans votre produit n'enverra jamais. Ils mesurent la qualité des échantillons dans des conditions que vous ne contrôlez pas, et ils ne disent rien sur les latences extrêmes, la cohérence des refus ou la dérive des sorties entre les versions. Un ensemble de tests construit à partir de vos propres catégories d'images vous en dit plus en un après-midi qu'un classement en un mois, et il survit à la prochaine version du modèle.
L'évaluation doit être un comportement mesurable, pas une question de goût. Les programmes d'évaluation formels traitent la génération d'images de la même manière qu'un test de charge traite le débit : protocoles définis, entrées fixes et sorties notées plutôt que des impressions de réviseurs. Une API de production devrait enregistrer les mêmes dimensions reproductibles à chaque appel : catégorie de prompt, modèle et version, seed si disponible, résolution, latency, mode de défaillance et résultat de sécurité. Enregistrez la latency par requête pour que la queue reste visible, car une médiane saine peut masquer des tâches qui restent bloquées assez longtemps pour atteindre votre timeout.
| Critère | Comment mesurer | Signal de réussite |
|---|---|---|
| Adhérence au prompt | évaluation notée d'un ensemble de prompts fixes par catégorie | les objets, quantités et couleurs requis apparaissent dans la plupart des sorties |
| Qualité perceptuelle | examen comparatif à l'aveugle par l'équipe | les réviseurs choisissent les sorties sans savoir quel modèle les a produites |
| Rendu du texte | prompts qui exigent des mots ou des étiquettes exacts | les mots sont orthographiés correctement dans la plupart des échantillons |
| Cohérence d'identité | le même sujet sur plusieurs générations | le visage, le produit ou le personnage reste reconnaissable |
| Comportement de refus | prompts qui devraient être refusés | les refus sont cohérents et se classent dans des catégories claires |
| Reproductibilité | appels répétés avec la même seed et version de modèle | les sorties restent proches lorsque la seed et la version correspondent |
Évaluez chaque ligne séparément. Un nombre agrégé masque un modèle qui rend parfaitement les étiquettes de produits et refuse chaque prompt contenant un enfant, ou un modèle avec de beaux portraits et un texte qui se lit comme un CAPTCHA. L'échec qui fait mal est toujours spécifique à une catégorie, et le moyen de le faire passer inaperçu en production est de le moyenner en un score unique.
Le routage ajoute un problème de gouvernance que le test de modèle ne détectera pas. Lorsqu'une place de marché ou une couche de basculement (failover) change de fournisseur, le remplacement doit offrir des garanties de modération équivalentes, ou le résultat doit être explicitement marqué comme ayant des caractéristiques d'assurance différentes. La relaxation silencieuse des contrôles de sécurité est le pire comportement de basculement possible : rien ne génère d'erreur, et la sortie arrive simplement avec une révision plus faible derrière elle. Conservez les décisions de modération et les versions de modèle dans le registre d'audit, et exposez les catégories d'erreurs sur lesquelles votre application peut se baser.
Taille d'échantillon qui fonctionne en pratique : quelques dizaines de prompts par catégorie pour une première passe, avec les prompts et sorties exacts sauvegardés dans un repo. Réexécutez l'ensemble complet chaque fois qu'une chaîne de version de modèle change, pas chaque fois que quelqu'un se plaint.
Ce dernier point est celui que les équipes ignorent. Un identifiant de modèle peut pointer vers une nouvelle version sans aucun changement de votre côté, donc l'ensemble de tests n'est pas un artefact de lancement, c'est une suite de régression qui s'exécute à chaque cycle de publication. Lorsque les résultats sont présentés aux parties prenantes en dehors de l'ingénierie, une explication simple de ce que fait un seul modèle, expliquée par ImagesArt AI, donne à cette conversation une base commune avant que le débat sur la notation ne commence.
Vérifier la fidélité et la provenance des retouches avant le lancement
Une retouche esthétique n'est pas forcément une retouche réussie. Les retouches doivent être évaluées deux fois : une fois pour vérifier si le changement demandé a eu lieu, et une fois pour s'assurer que tout le reste est resté intact. Se baser uniquement sur le premier critère, c'est risquer d'obtenir une photo de produit où le modèle a redessiné le logo.
La recherche soutient cette distinction. L'article HQ-Edit introduit l'Alignement et la Cohérence comme métriques distinctes et rapporte qu'un affinage a amélioré l'Alignement de 12.3 points et la Cohérence de 5.64 points dans un système évalué. Deux chiffres évoluant indépendamment, c'est tout l'argument : un résultat peut suivre l'instruction tout en détruisant les parties que vous deviez préserver, ou tout préserver et ignorer l'instruction.
Le test d'acceptation que j'exécuterais avant le lancement :
- Choisissez 20 à 30 images sources qui incluent des visages, du texte imprimé, des logos et des arrière-plans chargés. De simples photos de produits recadrées feront passer un modèle qui s'effondre sur un visage.
- Rédigez une instruction par image et enregistrez le changement attendu sur la même ligne. Des instructions ambiguës génèrent des discussions sur les résultats plutôt que des constats.
- Masquez la région éditée et comparez le reste à la source. Les pixels en dehors du masque constituent votre score de préservation, et un diff numérique résout ce que l'œil ne peut pas distinguer.
- Évaluez l'alignement et la préservation dans des colonnes séparées, puis examinez les cas où ils sont en désaccord. Ce sont les prompts qui nécessitent une reformulation ou le modèle qui doit être remplacé.
- Faites passer chaque résultat par un redimensionnement et une conversion de format, puis confirmez que les filigranes ou les informations d'identification de contenu ont survécu. Une provenance qui disparaît dans votre pipeline CDN est une provenance que vous n'avez jamais eue.
- Confirmez la politique de contenu du fournisseur et toute obligation de divulgation qui s'applique sur les marchés où vous livrez. La politique varie selon le fournisseur, et une requête routée peut tomber sous une politique différente.
- Enregistrez la chaîne de traçabilité du fichier source à l'actif livré, y compris la version du modèle qui l'a traité.
L'étape cinq est celle que les équipes découvrent tardivement. Les informations d'identification et les filigranes invisibles sont des preuves d'origine, pas la preuve qu'un événement représenté est vrai. La fiabilité dépend d'identités de confiance, du processus de signature, et de la préservation des métadonnées à chaque étape en aval. Ainsi, le redimensionnement, le recadrage et le ré-encodage nécessitent tous une vérification. Un signal de provenance améliore la traçabilité, et il ne peut pas établir l'authenticité factuelle ni confirmer que les droits sont acquis.
La conclusion inconfortable pour quiconque développe une fonctionnalité d'édition : les métadonnées de provenance répondent à la question « d'où cela vient-il ? », et elles ne répondent jamais à « cette affirmation est-elle exacte ? » ou « avons-nous la licence ? ». Ces questions restent du ressort juridique et éditorial.
Si la surface d'édition est le produit, traitez la préservation de la région comme un critère éliminatoire plutôt qu'un score de qualité. Un guide API de retouche photo est un compagnon utile pour le côté endpoint et paramètres, et ce guide AskYourQA sur les tests d'IA aide à structurer l'évaluation afin que l'alignement et la préservation ne se fondent pas en une seule impression.
Latence, Erreurs et Comportement de Réessai en Production
La plupart des comparaisons d'API d'images classent le prix par image et la qualité des échantillons, puis s'arrêtent là. Les queues de latence, les taux d'échec et le comportement de récupération sont les chiffres qui décident si votre fonctionnalité semble défectueuse, et ce sont les chiffres que personne ne publie. Un benchmark de génération d'images déclare sans ambages que la latence et la disponibilité observée sont réservées à une phase future, tandis qu'un test indépendant a constaté que les fournisseurs ne publient généralement pas de chiffres de latence réels et ont dû mesurer eux-mêmes les temps de réponse, les taux d'erreur, les cold starts et le throughput, comme le documente l'analyse de génération d'images des API Benchmarks.
Mesurez les percentiles, pas les moyennes. Suivez p50, p95 et p99 séparément pour les appels d'images synchrones et asynchrones, puis ajoutez le taux de timeout, la pénalité de cold start, le temps entre la création et le résultat récupérable, et le taux de sortie réussie. Une seule moyenne masque la queue que les utilisateurs expérimentent, c'est-à-dire les deux secondes où la plupart des requêtes aboutissent et les quarante où quelques-unes n'aboutissent pas.
Les surprises de timing concernent généralement la modalité. Lors de notre test sur 29 octobre 2026, un clip Kling 3.0 de 5 secondes a pris environ 80 secondes à générer. Rien n'était faux ; la vidéo coûte simplement des minutes là où les images coûtent des secondes, et un timeout copié du chemin d'image annulera des tâches qui progressaient normalement.
| Symptôme | Cause probable | Solution |
|---|---|---|
| Les tâches restent en cours d'exécution après le timeout | fournisseur lent ou indisponible | annuler, puis réessayer avec la même clé d'idempotence ou rediriger si disponible |
| Images dupliquées après un timeout réseau | appel de création réessayé sans clé d'idempotence | envoyer une clé d'idempotence avec chaque requête de création |
| réponses 429 pendant les pics | limite de débit atteinte | reculer de manière exponentielle avec jitter et mettre les requêtes en file d'attente |
| réponses 503 | fournisseur ou route temporairement indisponible | réessayer plus tard avec une limite, et basculer uniquement si les garanties de sécurité sont maintenues |
| réponses 402 | solde ou vérification de paiement échoué | recharger le solde, puis renvoyer la même requête |
| réponses 404 | identifiant de modèle ou route introuvable | vérifier l'identifiant par rapport au catalogue actuel |
| Le lien de l'image ne se charge plus | l'URL signée a expiré | télécharger en cas de succès et stocker le fichier dans votre propre stockage |
Ne réessayez que ce qui est réessayable. Une 429 ou une 503 est transitoire et mérite un recul exponentiel avec jitter et une limite stricte. Une 402 ou une 404 échouera identiquement pour toujours, alors corrigez d'abord le solde ou l'identifiant du modèle. Notre API refuse les appels avec 402, 404, 429 et 503, et la catégorie est le signal, pas seulement le statut HTTP.
La lecture à contre-courant sur le coût : l'API par image la moins chère est souvent la plus coûteuse en production. Les réessais, les générations échouées et la latence de queue imprévisible repoussent le travail dans votre application et les utilisateurs hors de votre entonnoir.
La fiabilité est déjà un critère d'achat, pour 37% des organisations, derrière l'optimisation des coûts à 58%, la disponibilité des modèles à 49% et la vitesse à 41%, selon la même analyse de benchmarking. Et le compromis du marché est réel : le routage entre fournisseurs réduit les pannes, mais il ajoute également de la variance dans le temps d'attente, les performances régionales et le délai du filtre de sécurité. Chaque requête redirigée doit être mesurée comme sa propre route, avec ses propres percentiles, sinon le dashboard agrégé masquera précisément le chemin qui échoue.
Comment intégrer une API d'image étape par étape
Une intégration en production est une courte liste de décisions, et la plupart d'entre elles concernent les enregistrements plutôt que les requêtes. Voici la séquence qui résiste au contact avec le trafic réel.
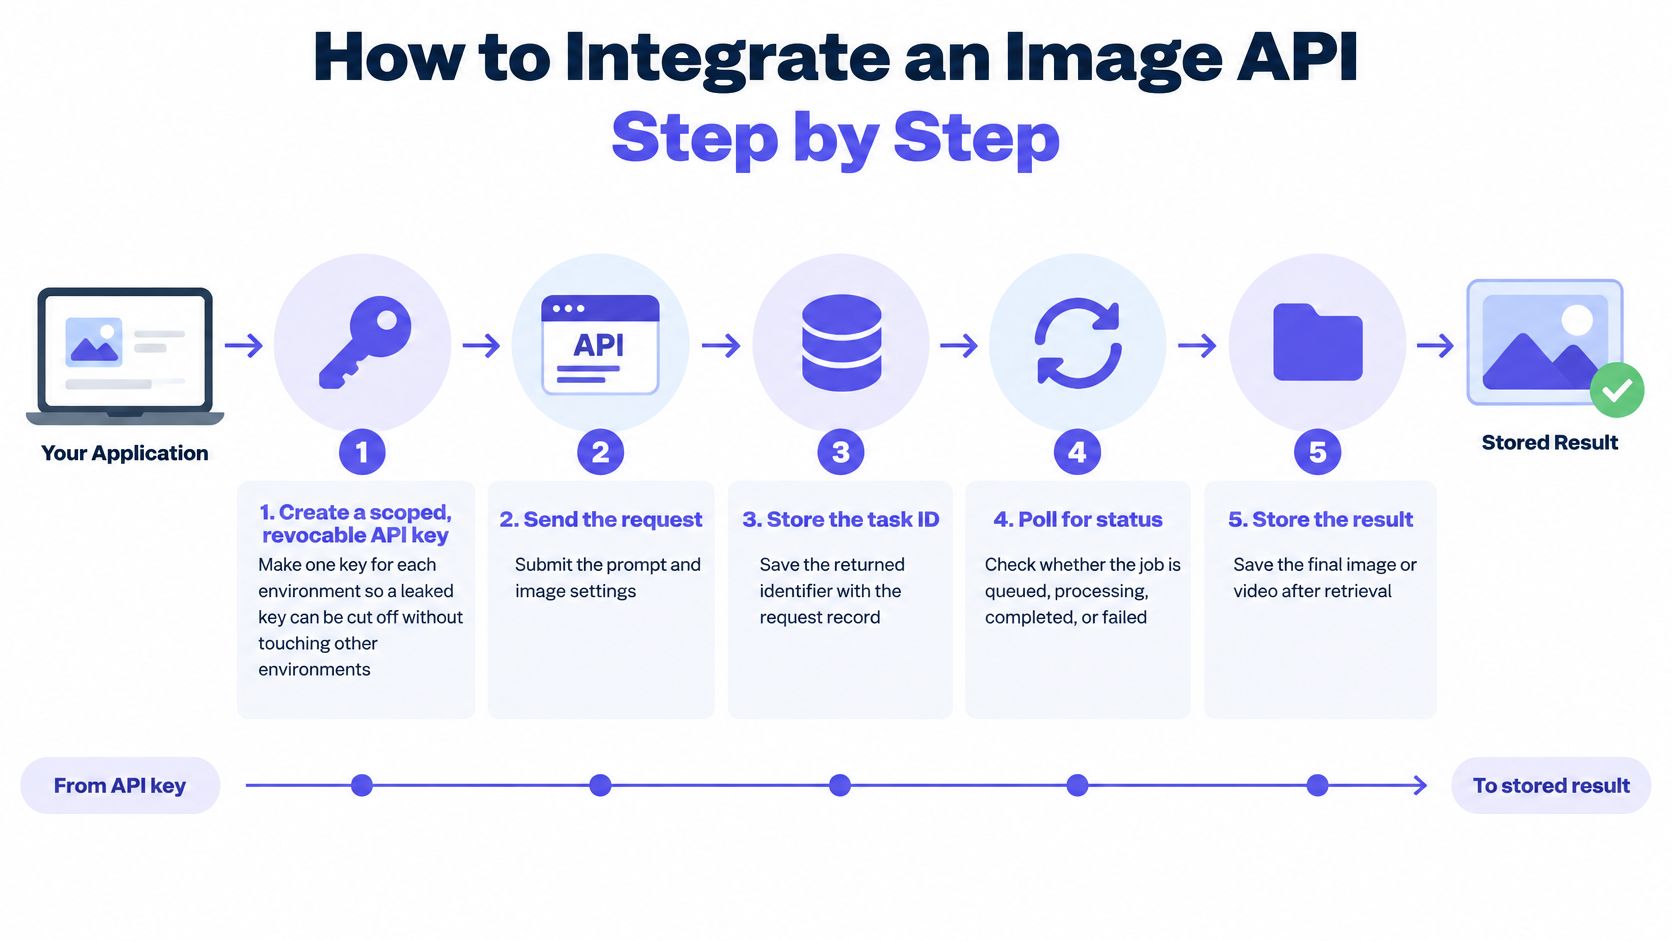
- Créez une clé à portée limitée et révocable pour chaque environnement. Des clés séparées signifient qu'une information d'identification de staging divulguée peut être révoquée sans affecter le trafic de production.
- Dirigez votre client existant vers la nouvelle base URL. La base compatible OpenAI est la base URL compatible OpenAI d'UberLLM, et comme la plateforme accepte les formats de communication d'OpenAI et d'Anthropic, les clients existants fonctionnent une fois que la base URL et les informations d'identification sont modifiées. Confirmez quels endpoints d'image dont vous dépendez sont pris en charge avant de basculer.
- Copiez l'identifiant du modèle en tant que chaîne complète depuis le catalogue actuel. Changer de modèle modifie alors exactement une valeur, ce qui est une différence d'une ligne au lieu d'une refactorisation. Les identifiants natifs du fournisseur fonctionnent de la même manière, tels que
fal-ai/kling-video/v3/standard/text-to-video. - Validez la taille et le rapport d'aspect localement, attachez une clé d'idempotence, puis envoyez l'appel de création. Les vérifications peu coûteuses appartiennent à votre côté du réseau.
- Stockez l'identifiant de la tâche avec l'enregistrement de la requête, puis interrogez (poll) ou enregistrez un webhook. Si le processus meurt entre la création et le stockage, vous avez payé pour un résultat que personne ne peut trouver.
- En cas de succès, téléchargez l'actif, vérifiez le checksum et enregistrez-le dans votre propre stockage. Attendre la prochaine requête utilisateur pour récupérer le fichier est la façon dont les liens expirés se transforment en tickets de support.
- Enregistrez l'identifiant du modèle, l'état, la durée et la catégorie d'erreur pour chaque tâche. Ces quatre champs répondent à la plupart des questions de production sans session de débogage.
- Exercez les chemins d'échec avant le lancement, y compris un 429, un délai d'attente de requête et un lien expiré. Un code de nouvelle tentative non testé double généralement le nombre d'images dupliquées plutôt que de le réduire.
Une courte démonstration vaut plus que la liste des champs pour la première version, surtout en ce qui concerne la récupération :
À quoi ressemble une intégration fonctionnelle à la fin de ce processus : chaque tâche a un état, chaque tâche réussie a un actif dans votre bucket, et chaque actif a une version de modèle enregistrée à côté. C'est la norme complète. C'est aussi la différence entre une démo qui a impressionné quelqu'un en mars et une fonctionnalité que vous pouvez encore déboguer en novembre.
Unités de facturation et comment comparer les coûts réels
Deux API peuvent toutes deux indiquer "par image" et pourtant vous facturer différemment, car l'unité, la dépendance à la taille et la politique d'échec modifient toutes l'arithmétique. Comparez d'abord l'unité, puis calculez le coût par sortie utilisable.
| Modalité | Unité de facturation habituelle | Ce qu'il faut vérifier |
|---|---|---|
| Génération de texte | tokens d'entrée et de sortie | l'entrée et la sortie sont facturées séparément |
| Génération d'images | par image ou par mégapixel | le modèle et la taille de sortie modifient le coût unitaire |
| Édition d'images | par modification ou par image de sortie | si l'image source entraîne un coût supplémentaire |
| Génération de vidéo | par clip ou par seconde, selon le fournisseur | facturé au prix final une fois la génération terminée |
| Musique et parole | par piste, par minute ou par caractère | l'unité que chaque modèle utilise réellement |
| Tâches échouées | facturé par tentative, ou pas facturé du tout | si les générations échouées apparaissent sur la facture |
La tarification par mégapixel pénalise les grandes sorties d'une manière que la tarification par image ne fait pas. Un modèle qui semble bon marché à 1024×1024 peut coûter plusieurs fois plus cher à la résolution d'impression, alors comparez à la taille que votre produit rend plutôt qu'à la taille de la capture d'écran marketing.
La vidéo nécessite sa propre ligne dans les prévisions. Un clip facturé à son prix final une fois la génération terminée est plus facile à projeter qu'un clip mesuré pendant son exécution, car vous prévoyez des sorties terminées plutôt qu'une incertitude de temps réel. Les modifications sont la ligne sournoise : vérifiez si l'image source est facturée comme une entrée, car un flux de travail de retouche qui envoie une source de 4 MB à chaque appel peut faire passer le coût unitaire bien au-delà du prix de modification annoncé.
Les générations échouées sont la ligne qui décide finalement entre deux fournisseurs. Prenez 1,000 tâches d'image avec un taux d'échec de 5%. Si les tâches échouées sont facturées, vous payez pour 1,000 tâches pour recevoir 950 images utilisables, ce qui représente environ 5% de plus par image utilisable que ce que l'étiquette suggère. Si les tâches échouées ne sont pas facturées, vous payez pour 950. Même prix affiché, prix effectif différent.
La formule que j'utiliserais pour une estimation mensuelle : volume attendu × prix unitaire × facteur de réessai, plus une marge pour les modifications et la vidéo. Le facteur de réessai est le nombre qui sépare une prévision d'un souhait.
Comparez ensuite les prix unitaires par rapport à votre propre test d'acceptation plutôt qu'à la galerie d'échantillons du fournisseur. Si vous voulez la logique sous-jacente de la tarification des tokens, des images et des clips en un seul endroit, cette analyse des modèles de tarification de l'IA explique comment chaque unité est mesurée.
Effectuez un appel de test avant de choisir votre modèle
Un appel de test doit répondre à plus que « Cette image est-elle belle ? » Vérifiez si le modèle répond à vos critères de qualité, comment il gère les modifications et comment sa réponse se comporte sous la charge attendue. Une image d'exemple solide ne peut pas vous dire comment l'API fonctionnera en production.
Choisissez un candidat pour le text-to-image et un autre qui prend en charge l'édition. Gardez l'ensemble de prompts fixe pour tous les candidats afin de pouvoir comparer les sorties sur les mêmes tâches. Avec UberLLM, vous pouvez changer de modèle en modifiant l'identifiant du modèle tout en conservant l'API key et l'endpoint.
Testez dans l'ordre : d'abord, évaluez les sorties par rapport à vos critères de sélection ; ensuite, exécutez le test d'acceptation des modifications si votre fonctionnalité édite des images ; puis mesurez la latence p50 et p95 à la concurrence attendue. Terminez en calculant le coût par sortie utilisable, y compris les tentatives. Un modèle qui ne satisfait pas aux critères de qualité n'a pas besoin de test de charge.
Enregistrez les prompts, les sorties et les logs de requêtes dans votre dépôt. Lorsque vous modifiez un identifiant ou une version de modèle, réexécutez le même ensemble et comparez les résultats. Pour les modifications, vérifiez si le résultat préserve les détails de la source dont votre application a besoin ; une image visuellement plausible peut toujours altérer l'identité ou d'autres caractéristiques importantes.
Feu vert ou feu rouge : Ne promouvez un modèle que s'il réussit les tests de qualité, d'édition et de charge au volume attendu. Déployez-le derrière un feature flag et gardez un deuxième candidat disponible pour le basculement (failover). S'il échoue, testez le candidat suivant avec le même ensemble.
Le prix fait partie de la décision, mais il ne doit pas la dicter. UberLLM propose la génération d'images Nano Banana 2 à $0.015 par image, comparé à un prix catalogue de $0.10 par image. Pour les tests vidéo, UberLLM recommande Kling 3.0 Standard comme point de départ pour le text-to-video ou l'image-to-video. Les requêtes d'images et de vidéos renvoient une tâche que vous pouvez interroger (poll) ou suivre via un webhook, alors incluez le temps d'achèvement et de récupération des résultats dans votre test.
UberLLM fournit des modèles de texte, d'image, de vidéo, de musique et de parole via des interfaces compatibles OpenAI et Anthropic. Utilisez son playground pour comparer les sorties d'images, puis exécutez les mêmes prompts de test via le client API de votre application. Évaluez ensemble la qualité, la fidélité des modifications, la latence et le coût par résultat utilisable avant de choisir un modèle.