¿Cómo elegir e integrar una API de generación de imágenes?
Compara las capacidades de la API de generación de imágenes, los campos de solicitud, los resultados asíncronos, las pruebas de modelos, el manejo de errores y la facturación, con los pasos para la integración en producción.
Más de 15 mil millones de imágenes se habían creado con algoritmos de texto a imagen para agosto de 2023,, un promedio de aproximadamente 34 millones al día desde que DALL-E 2 se lanzó, según un análisis de Everypixel de estadísticas de imágenes de IA. El mismo análisis atribuye aproximadamente 12.6 mil millones de ellas, aproximadamente 80%, a modelos, servicios y aplicaciones basados en Stable Diffusion.
A ese volumen, la generación de imágenes deja de ser una demostración creativa y se convierte en infraestructura. Las preguntas que deciden si un producto se lanza dejan de ser sobre qué modelo pinta imágenes más bonitas y empiezan a ser sobre contratos de solicitud, estados de trabajo, comportamiento de tiempo de espera (timeout behavior), y si una generación fallida aún aparece en tu factura.
Esta es una guía para desarrolladores sobre la capa de la API de generación de imágenes. Cubre cómo se estructuran las solicitudes, cómo las tareas se mueven a través de un ciclo de vida, cómo probar un modelo en lugar de confiar en una tabla de clasificación (leaderboard), y dónde se ocultan los costos. El precio por imagen es el número más fácil de comparar y el menos útil por sí solo.
Tabla de Contenidos
- Capacidades de la API de Generación de Imágenes de un Vistazo
- Patrones de Solicitud y Campos de Respuesta
- Trabajos Asíncronos, Estados de Tarea y Recuperación de Resultados
- Criterios de Selección de Modelos y Cómo Probarlos
- Verificación de la Fidelidad de Edición y Procedencia Antes del Lanzamiento
- Latencia, Errores y Comportamiento de Reintento en Producción
- Cómo Integrar una API de Imágenes Paso a Paso
- Unidades de Facturación y Cómo Comparar Costos Reales
- Realiza una Llamada de Prueba Antes de Elegir Tu Modelo
Capacidades de la API de Generación de Imágenes de un Vistazo
| Capacidad | Entrada | Salida | Patrón de recuperación |
|---|---|---|---|
| Generación de texto | mensajes y parámetros | texto en streaming | respuesta en streaming |
| Texto a imagen | prompt, tamaño, identificador de modelo | una o más imágenes | tarea, consultada o webhook |
| Edición de imagen | imagen de origen, instrucción, máscara opcional donde sea compatible | imagen editada | tarea, consultada o webhook |
| Texto a video | prompt, duración, resolución | archivo de video | tarea, consultada o webhook |
| Imagen a video | imagen de origen, prompt, duración | archivo de video | tarea, consultada o webhook |
| Generación de música | prompt, estilo, duración | archivo de audio | tarea, consultada o webhook |
| Síntesis de voz | texto, voz | archivo de audio | audio en streaming o un archivo devuelto |
Un endpoint y una API key pueden cubrir varias familias de modelos a la vez, porque el identificador de modelo es lo que selecciona la familia y la versión. Esa conveniencia tiene un doble filo. Cada familia acepta un conjunto de parámetros diferente, por lo que un cuerpo que valida para un modelo puede fallar en otro, y los tamaños, masks, el soporte de seed y los límites de salida múltiple difieren entre ellos.
Una API de generación de imágenes es un servicio de inferencia alojado con tres partes: un contrato de solicitud que convierte un prompt y configuraciones en una llamada firmada, un objeto de resultado que lleva la imagen más sus metadatos, y un ciclo de vida de trabajo para tareas que sobreviven a una única respuesta HTTP. Cada parte necesita sus propias decisiones de diseño, y cada una falla de manera diferente.
El patrón es más reciente de lo que parece. El lanzamiento público de Stable Diffusion el 22 de agosto de 2022 estableció la forma de servicio que la mayoría de los proveedores aún utilizan, como TechCrunch informó en su lanzamiento: una aplicación publica un prompt y parámetros, el proveedor ejecuta el trabajo de la GPU, y una imagen o una tarea regresa. Ese modelo se ejecutó en hardware de consumo de gama alta y produjo imágenes de 512×512 píxeles en unos pocos segundos, entrenado en LAION-5B, un conjunto de datos de aproximadamente 5.85 mil millones de pares imagen-texto con un subconjunto filtrado por estética de unos 600 millones. Stability AI afirmó que más de 15,000 testers estaban generando alrededor de 2 millones de imágenes al día durante el acceso público temprano, lo cual es la señal temprana más clara de que el acceso alojado, no el software de escritorio, era la forma de la demanda.
Las secciones siguientes siguen el orden en que una integración real se encuentra con estos problemas: campos de solicitud y objetos de respuesta primero, luego estados de tareas asíncronas, pruebas de selección de modelo, fidelidad y procedencia de edición, latencia y reintentos, integración paso a paso, unidades de facturación y una llamada de prueba final. Los equipos que conectan generaciones a un pipeline automatizado suelen querer que se demuestre el ciclo completo una vez, y este recorrido de una API de imágenes para flujos de trabajo de automatización muestra el ciclo completo desde el disparador hasta el activo almacenado.
Patrones de Solicitud y Campos de Respuesta
La mayoría de las primeras integraciones fallan en el cuerpo de la solicitud, y rara vez debido al prompt. Construye los campos en el orden en que se envían y la depuración será más corta.
- Identificador del modelo. Envíalo primero en tu propia lógica, porque decide cuáles de los campos restantes son válidos. Un negative prompt o una máscara que un modelo acepta será rechazado por el siguiente.
- Prompt y negative prompt. El negative prompt es un campo soportado en algunas familias y ignorado en otras, así que verifica en lugar de asumir.
- Tamaño o relación de aspecto. Exprésalo de la manera que el modelo espera, en píxeles o en relaciones con nombre. Valídalo localmente antes de la inferencia, porque una llamada rechazada cuesta un viaje de ida y vuelta, mientras que una generación que falla tarde cuesta un timeout y un espacio en la cola.
- Cantidad de salidas. Múltiples salidas por llamada parecen eficientes hasta que notas que la facturación generalmente escala con la cantidad, no con la llamada.
- Formato de salida. PNG, JPEG o WebP cambia tu trabajo de conversión posterior tanto como tu recuento de bytes.
- Seed. Inclúyelo siempre que la reproducibilidad sea importante. Sin él, "ejecutar eso de nuevo" significa "tirar los dados de nuevo".
- Webhook URL. Los trabajos largos terminan después de que tu solicitud ha regresado, y una devolución de llamada es más barata que un bucle de sondeo ajustado.
- Idempotency key. La generación es costosa, por lo que un reintento de creación sin una clave se convierte en un segundo trabajo facturado y una imagen duplicada.
Valida antes de gastar. Verifica primero la relación de aspecto, el identificador del modelo y los campos requeridos en tu propio código. Una verificación de esquema local detecta la clase de error que de otro modo aparecería como un 400 después de una espera en la cola, y mantiene el tráfico malformado completamente fuera de un endpoint medido.
El lado de la respuesta es donde los equipos pierden activos por los que ya han pagado. La referencia de la API de imágenes de OpenAI muestra la forma en la que la mayoría de los proveedores convergen: un objeto de imagen con un payload base64, una URL alojada y, donde se admita, un prompt revisado. Normaliza lo que el proveedor devuelva en tu propio esquema estable, y guarda un bloque de metadatos del proveedor en bruto para los controles que tu esquema aún no modela.
| Campo | Qué contiene | Nota de producción |
|---|---|---|
| URL del activo | enlace al archivo generado | de corta duración y con control de acceso, así que descárgalo antes de que expire |
| b64_json | bytes de imagen codificados en base64 | bien para respuestas síncronas pequeñas, consume mucha memoria para payloads grandes |
| revised_prompt | el prompt tal como el modelo lo reformuló | guárdalo, porque explica salidas que no esperabas |
| Identificador del modelo | el modelo y la versión que produjeron la salida | requerido para auditoría y reproducción |
| Dimensiones y formato | ancho, alto y tipo MIME | confirma con la relación de aspecto solicitada |
| Checksum | hash de integridad del archivo | verifica después de la descarga y después de cualquier conversión de formato |
Trata base64 como un detalle de transporte, no como una estrategia de almacenamiento. Una imagen codificada infla el payload en aproximadamente un tercio y permanece en memoria mientras tu aplicación analiza JSON. Para medios de producción, escribe los bytes decodificados en el almacenamiento de objetos y entrega a tu front end una URL de recuperación firmada en su lugar. Añade el tipo MIME y un checksum al registro mientras estás allí, para que una descarga corrupta sea detectada por tu pipeline en lugar de por un usuario.
La regla que aplicaría en la revisión de código: cada activo almacenado lleva el identificador del modelo, el seed, el prompt efectivo y la marca de tiempo de la solicitud en sus metadatos. Sin esos cuatro, un ticket de soporte sobre "una imagen extraña del mes pasado" no tiene respuesta.
Ese hábito da sus frutos la primera vez que una versión del modelo cambia y la salida se desvía. Los metadatos almacenados convierten una queja vaga en una comparación que puedes ejecutar.
Trabajos Asíncronos, Estados de Tarea y Recuperación de Resultados
El trabajo de imagen y video no se devuelve dentro de una finalización de chat. Cree un trabajo, guarde el identificador y luego observe su progreso.
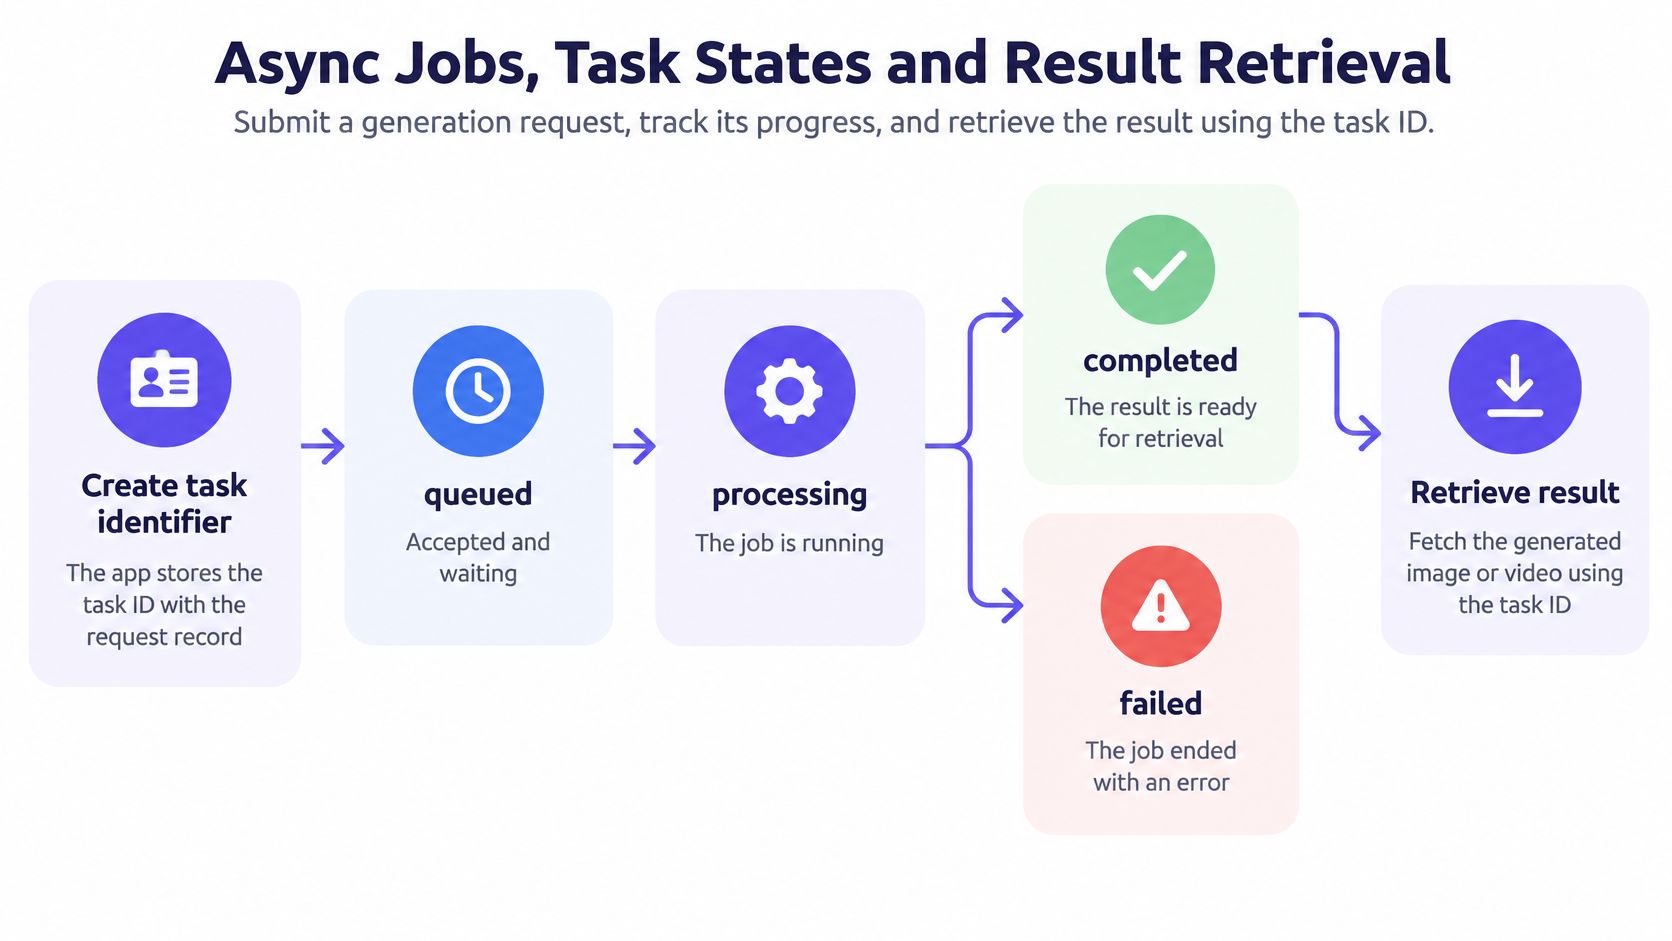
La llamada de creación devuelve un identificador de tarea, y su aplicación lo escribe en el mismo registro de solicitud que contiene el prompt y el modelo. A partir de ahí, el trabajo informa uno de cinco estados, y cada uno requiere algo diferente de su código.
| Estado | Significado | Lo que hace la aplicación |
|---|---|---|
| en cola | aceptado y esperando capacidad | guardar el ID de tarea y consultar periódicamente |
| en ejecución | generación en curso | esperar y aplicar un tiempo de espera dimensionado para la modalidad |
| exitoso | la salida está lista | descargar y almacenar el activo inmediatamente |
| fallido | la generación no se completó | leer la categoría de error antes de cualquier reintento |
| caducado | la salida ya no es recuperable | regenerar y no tratarlo como un resultado faltante |
El estado caducado sorprende a los equipos porque parece un error en su propio sistema. No lo es. Los proveedores guardan los archivos de resultados por un período limitado, y ese período es corto. En UberLLM, los enlaces de imagen permanecen activos durante aproximadamente 15 minutos, y los archivos de resultados de video y música se guardan durante aproximadamente 3 horas después de que finaliza el trabajo. Un bucle de polling que verifica cada diez minutos y actúa en el siguiente ciclo de despliegue perderá los enlaces de imagen por completo.
La recuperación se basa en dos mecanismos, y los sistemas maduros usan ambos. El polling cubre las entregas que un webhook perdió, y es la única opción cuando su servicio no puede exponer un endpoint público. Los webhooks reducen las solicitudes desperdiciadas al indicarle exactamente cuándo cambió el estado, lo cual es importante cuando un trabajo tarda un minuto en lugar de un segundo. Las ventajas y desventajas entre webhooks y polling se reducen al manejo de fallos: los webhooks fallan cuando su receptor está inactivo, y el polling falla de manera costosa cuando su intervalo es demasiado ajustado.
Los intervalos de polling deben seguir la modalidad, no el código base. Un único bucle fijo que funciona para un trabajo de imagen de 4 segundos desperdicia docenas de llamadas en un trabajo de video que se ejecuta durante un minuto o más.
Las respuestas de texto se transmiten token por token, mientras que los trabajos de imagen y video le entregan una tarea que usted consulta o que un webhook informa como lista. Esa diferencia es arquitectónica, no cosmética: la solicitud que regresa instantáneamente aún posee trabajo que no ha terminado, y alguien tiene que recordarlo. Registre los tiempos de transición de estado, así como el estado final, porque la brecha entre en cola y en ejecución es donde aparecen los problemas de capacidad antes de que lleguen a los usuarios.
Criterios de Selección de Modelos y Cómo Probarlos
Las clasificaciones públicas puntúan los modelos con prompts que nadie en tu producto enviará jamás. Miden la calidad de las muestras bajo condiciones que no controlas, y no dicen nada sobre las colas de latencia, la consistencia de los rechazos o cómo los resultados varían entre versiones. Un conjunto de pruebas construido a partir de tus propias categorías de imágenes te dice más en una tarde de lo que una tabla de clasificación te dice en un mes, y sobrevive a la próxima versión del modelo.
La evaluación debe ser un comportamiento medible, no una cuestión de gusto. Los programas de evaluación formales tratan la generación de imágenes de la misma manera que una prueba de carga trata el rendimiento: protocolos definidos, entradas fijas y salidas puntuadas en lugar de impresiones del revisor. Una API de producción debería registrar las mismas dimensiones reproducibles en cada llamada: categoría del prompt, modelo y versión, seed si está disponible, resolución, latencia, modo de fallo y resultado de seguridad. Registra la latencia por solicitud para que la cola permanezca visible, porque una mediana saludable puede ocultar trabajos que se cuelgan lo suficiente como para alcanzar tu tiempo de espera.
| Criterio | Cómo medir | Señal de aprobación |
|---|---|---|
| Adherencia al prompt | revisión puntuado de un conjunto fijo de prompts por categoría | los objetos, recuentos y colores requeridos aparecen en la mayoría de las salidas |
| Calidad perceptual | revisión ciega lado a lado por el equipo | los revisores eligen las salidas sin saber qué modelo las generó |
| Renderizado de texto | prompts que requieren palabras o etiquetas exactas | las palabras están escritas correctamente en la mayoría de las muestras |
| Consistencia de identidad | el mismo sujeto a través de varias generaciones | la cara, el producto o el personaje se mantiene reconocible |
| Comportamiento de rechazo | prompts que deberían ser rechazados | los rechazos son consistentes y caen en categorías claras |
| Reproducibilidad | llamadas repetidas con la misma seed y versión del modelo | las salidas se mantienen similares cuando la seed y la versión coinciden |
Puntúa cada fila por separado. Un número agregado oculta un modelo que renderiza etiquetas de productos perfectamente y rechaza cada prompt que contiene un niño, o uno con retratos hermosos y texto que se lee como un CAPTCHA. El fallo que duele siempre es específico de la categoría, y promediarlo en una única puntuación es cómo llega a producción desapercibido.
El enrutamiento añade un problema de gobernanza que la prueba del modelo no detectará. Cuando un marketplace o una capa de failover cambia de proveedor, el reemplazo debe ofrecer garantías de moderación equivalentes, o el resultado debe marcarse explícitamente como con características de aseguramiento diferentes. La relajación silenciosa de las comprobaciones de seguridad es el peor comportamiento posible de failover: nada da error, y la salida simplemente llega con una revisión más débil detrás. Mantén las decisiones de moderación y las versiones del modelo en el registro de auditoría, y expón categorías de error sobre las que tu aplicación pueda ramificarse.
Tamaño de muestra que funciona en la práctica: unas pocas docenas de prompts por categoría para una primera pasada, con los prompts y salidas exactos guardados en un repositorio. Vuelve a ejecutar todo el conjunto cada vez que cambie la cadena de versión de un modelo, no cada vez que alguien se queje.
Ese último punto es el que los equipos suelen omitir. Un identificador de modelo puede apuntar a una nueva compilación sin ningún cambio por tu parte, por lo que el conjunto de pruebas no es un artefacto de lanzamiento, es una suite de regresión que se ejecuta en cada ciclo de lanzamiento. Cuando los resultados llegan a los interesados fuera de ingeniería, una explicación sencilla de lo que hace un solo modelo, explicada por ImagesArt AI, proporciona a esa conversación una base común antes de que comience el debate sobre la puntuación.
Verificación de la fidelidad y procedencia de la edición antes del lanzamiento
Una edición que se ve bien no es una edición exitosa. La edición debe puntuarse dos veces: una por si el cambio solicitado se realizó y otra por si todo lo demás permaneció en su lugar. Lanzar basándose solo en la primera puntuación es cómo se obtiene una foto de producto donde el modelo redibujó el logo.
La investigación respalda esta división. El artículo HQ-Edit introduce la Alineación y la Coherencia como métricas separadas e informa que el ajuste fino (fine-tuning) mejoró la Alineación en 12.3 puntos y la Coherencia en 5.64 puntos en un sistema evaluado. Dos números que se mueven de forma independiente es el argumento principal: una salida puede seguir la instrucción y aun así destruir las partes que necesitabas preservar, o preservar todo e ignorar la instrucción.
La prueba de aceptación que ejecutaría antes del lanzamiento:
- Selecciona entre 20 y 30 imágenes de origen que incluyan caras, texto impreso, logotipos y fondos complejos. Las fotos de producto recortadas por sí solas pasarán un modelo que se desmorona con una cara.
- Escribe una instrucción por imagen y registra el cambio esperado en la misma fila. Las instrucciones ambiguas producen discusiones sobre los resultados en lugar de hallazgos.
- Enmascara la región editada y compara el resto con la fuente. Los píxeles fuera de la máscara son tu puntuación de preservación, y una comparación numérica resuelve lo que la inspección visual no puede.
- Puntúa la alineación y la preservación en columnas separadas, luego observa los casos en los que no coinciden. Esos son los prompts que necesitan ser reformulados o el modelo que necesita ser reemplazado.
- Pasa cada salida por un redimensionamiento y una conversión de formato, luego confirma que las marcas de agua o las credenciales de contenido sobrevivieron. La procedencia que muere en tu pipeline de CDN es una procedencia que nunca tuviste.
- Confirma la política de contenido del proveedor y cualquier deber de divulgación que se aplique en los mercados a los que envías. La política varía según el proveedor, y una solicitud enrutada puede caer bajo una diferente.
- Registra la cadena de custodia desde el archivo de origen hasta el activo entregado, incluyendo qué versión del modelo lo manejó.
El paso cinco es el que los equipos descubren tarde. Las credenciales y las marcas de agua invisibles son evidencia sobre el origen, no prueba de que un evento representado sea verdadero. La fiabilidad depende de identidades confiables, del proceso de firma y de si cada paso posterior preserva los metadatos, por lo que el redimensionamiento, el recorte y la recodificación necesitan una verificación. Una señal de procedencia mejora la trazabilidad, y no puede establecer la autenticidad fáctica ni confirmar que los derechos estén autorizados.
La conclusión incómoda para cualquiera que construya una función de edición: los metadatos de procedencia responden "¿de dónde vino esto?", y nunca responden "¿es esta afirmación precisa?" o "¿tenemos la licencia?". Esas siguen siendo preguntas legales y editoriales.
Si la superficie de edición es el producto, trata la preservación de la región como una barrera estricta en lugar de una puntuación de calidad. Una guía de API de edición de fotos es un compañero útil para el lado del endpoint y los parámetros, y esta guía de AskYourQA para pruebas de IA ayuda a estructurar la puntuación para que la alineación y la preservación no se fusionen en una sola impresión.
Latencia, Errores y Comportamiento de Reintentos en Producción
La mayoría de las comparaciones de API de imágenes clasifican el precio por imagen y la calidad de la muestra, y luego se detienen. Las colas de latencia, las tasas de fallo y el comportamiento de recuperación son los números que deciden si tu función se siente rota, y son los números que nadie publica. Un benchmark de generación de imágenes afirma directamente que la latencia y el tiempo de actividad observado están reservados para una fase futura, mientras que una prueba independiente encontró que los proveedores generalmente no publican cifras de latencia reales y tuvieron que medir los tiempos de respuesta, las tasas de error, los arranques en frío (cold starts) y el rendimiento (throughput) por sí mismos, como el análisis de generación de imágenes de API Benchmarks documenta.
Mide percentiles, no promedios. Haz un seguimiento de p50, p95 y p99 por separado para las llamadas de imágenes síncronas y asíncronas, luego añade la tasa de timeout, la penalización por arranque en frío (cold-start penalty), el tiempo desde la creación hasta el resultado recuperable, y la tasa de salida exitosa. Un solo promedio oculta la cola que experimentan los usuarios, que son los dos segundos donde la mayoría de las solicitudes aterrizan y los cuarenta donde unas pocas no lo hacen.
Las sorpresas de tiempo suelen estar relacionadas con la modalidad. En nuestra prueba en 29 de octubre de 2026, un clip de Kling 3.0 de 5 segundos tardó aproximadamente 80 segundos en generarse. Nada estaba mal; el vídeo simplemente cuesta minutos donde las imágenes cuestan segundos, y un timeout copiado de la ruta de la imagen cancelará trabajos que estaban progresando normalmente.
| Síntoma | Causa probable | Solución |
|---|---|---|
| Las tareas permanecen en ejecución más allá del timeout | proveedor lento o no disponible | cancela, luego reintenta con la misma idempotency key o redirige si está disponible |
| Imágenes duplicadas después de un timeout de red | llamada de creación reintentada sin una idempotency key | envía una idempotency key con cada solicitud de creación |
| respuestas 429 durante ráfagas | límite de tasa alcanzado | retrocede exponencialmente con jitter y encola las solicitudes |
| respuestas 503 | proveedor o ruta temporalmente no disponible | reintenta más tarde con un límite, y haz fail over solo si las garantías de seguridad se mantienen |
| respuestas 402 | falló la verificación de saldo o pago | recarga el saldo, luego reenvía la misma solicitud |
| respuestas 404 | identificador de modelo o ruta no encontrado | verifica el identificador contra el catálogo actual |
| El enlace de la imagen ya no carga | la URL firmada ha expirado | descarga al tener éxito y almacena el archivo en tu propio almacenamiento |
Reintenta solo lo que sea reintentable. Un 429 o un 503 es transitorio y merece un retroceso exponencial (exponential backoff) con jitter y un límite estricto (hard cap). Un 402 o un 404 fallará idénticamente para siempre, así que primero corrige el saldo o el identificador del modelo. Nuestra API rechaza llamadas con 402, 404, 429 y 503, y la categoría es la señal, no solo el HTTP status.
La lectura contraria sobre el coste: la API por imagen más barata es a menudo la más cara en producción. Los reintentos, las generaciones fallidas y la latencia de cola impredecible devuelven el trabajo a tu aplicación y sacan a los usuarios de tu embudo.
La fiabilidad ya es un criterio de compra, en el 37% de las organizaciones, por detrás de la optimización de costes en el 58%, la disponibilidad del modelo en el 49% y la velocidad en el 41%, según el mismo análisis de benchmarking. Y la compensación del mercado es real: el enrutamiento entre proveedores reduce las interrupciones, pero también añade varianza en el tiempo de cola, el rendimiento regional y el retraso del filtro de seguridad. Cada solicitud redirigida debe medirse como su propia ruta, con sus propios percentiles, o el panel de control agregado ocultará exactamente la ruta que está fallando.
Cómo integrar una API de imágenes paso a paso
Una integración en producción es una lista corta de decisiones, y la mayoría de ellas se refieren a registros en lugar de solicitudes. Aquí está la secuencia que sobrevive al contacto con el tráfico real.
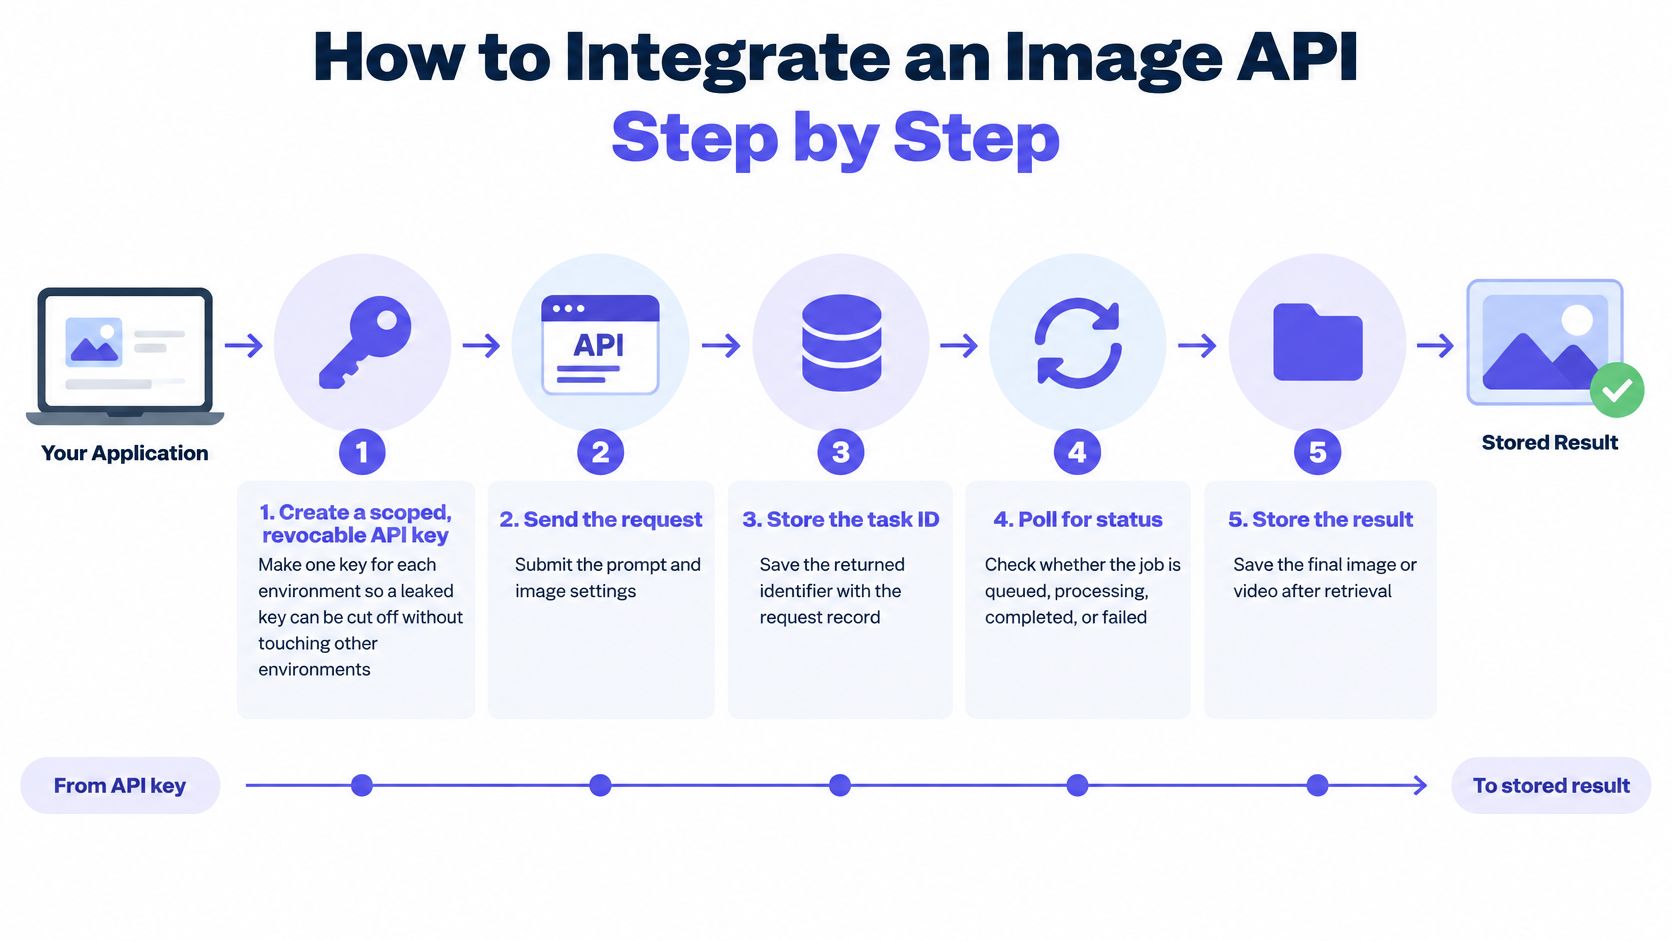
- Cree una API key con ámbito y revocable para cada entorno. Las API keys separadas significan que una credencial de staging filtrada puede ser revocada sin afectar el tráfico de producción.
- Apunte su cliente existente a la nueva base URL. La base compatible con OpenAI es la base URL compatible con OpenAI de UberLLM, y debido a que la plataforma acepta los formatos de cable de OpenAI y Anthropic, los clientes existentes funcionan una vez que la base URL y las credenciales cambian. Confirme qué endpoints de imagen de los que depende son compatibles antes de realizar el cambio.
- Copie el identificador del modelo como una cadena completa del catálogo actual. Cambiar de modelo entonces cambia exactamente un valor, lo que es un diff de una línea en lugar de una refactorización. Los IDs nativos del proveedor funcionan de la misma manera, como
fal-ai/kling-video/v3/standard/text-to-video. - Valide el tamaño y la relación de aspecto localmente, adjunte una idempotency key, luego envíe la llamada de creación. Las comprobaciones económicas pertenecen a su lado de la red.
- Almacene el identificador de la tarea con el registro de la solicitud, luego haga polling o registre un webhook. Si el proceso muere entre la creación y el almacenamiento, habrá pagado por una salida que nadie puede encontrar.
- Al tener éxito, descargue el asset, verifique el checksum y guárdelo en su propio almacenamiento. Esperar hasta la siguiente solicitud del usuario para obtener el archivo es cómo los enlaces que caducan se convierten en tickets de soporte.
- Registre el identificador del modelo, el estado, la duración y la categoría de error para cada job. Esos cuatro campos responden la mayoría de las preguntas de producción sin una sesión de debugging.
- Ejercite las rutas de fallo antes del lanzamiento, incluyendo un 429, un request timeout y un enlace caducado. El código de reintento no probado suele duplicar el recuento de imágenes duplicadas en lugar de reducirlo.
Un breve recorrido vale más que la lista de campos para la primera compilación, especialmente en torno a la recuperación:
Así es como se ve una integración funcional al final de esto: cada job tiene un estado, cada job exitoso tiene un asset en su bucket, y cada asset tiene una versión de modelo registrada a su lado. Ese es todo el estándar. También es la diferencia entre una demo que impresionó a alguien en marzo y una característica que aún puede depurar en noviembre.
Unidades de Facturación y Cómo Comparar Costos Reales
Dos APIs pueden decir "por imagen" y aun así facturarte de manera diferente, porque la unidad, la dependencia del tamaño y la política de fallos cambian la aritmética. Compara la unidad primero, luego calcula el costo por salida utilizable.
| Modalidad | Unidad de facturación habitual | Qué verificar |
|---|---|---|
| Generación de texto | tokens de input y output | input y output se tarifican por separado |
| Generación de imagen | por imagen o por megapixel | el modelo y el tamaño del output cambian el costo unitario |
| Edición de imagen | por edición o por imagen de output | si la imagen de origen añade un cargo |
| Generación de vídeo | por clip o por segundo, según el proveedor | se factura al precio final una vez que la generación se completa |
| Música y voz | por pista, por minuto o por carácter | la unidad que cada modelo utiliza realmente |
| Trabajos fallidos | se cobran por intento, o no se cobran en absoluto | si las generaciones fallidas aparecen en la factura |
La tarificación por megapixel penaliza los outputs grandes de una manera que la tarificación por imagen no lo hace. Un modelo que parece barato a 1024×1024 puede costar varias veces más a resolución de impresión, así que compara al tamaño que tu producto renderiza en lugar de al tamaño de la captura de pantalla de marketing.
El vídeo necesita su propia línea en la previsión. Un clip facturado a su precio final una vez que la generación se completa es más fácil de proyectar que uno medido mientras se ejecuta, porque estás previendo outputs terminados en lugar de la incertidumbre del tiempo real. Las ediciones son la fila engañosa: verifica si la imagen de origen se cobra como un input, ya que un flujo de trabajo de retoque que envía una fuente de 4 MB en cada llamada puede elevar el costo unitario mucho más allá del precio de edición anunciado.
Las generaciones fallidas son el elemento de línea que finalmente decide entre dos proveedores. Toma 1,000 trabajos de imagen con una tasa de fallo del 5%. Si los trabajos fallidos se facturan, pagas por 1,000 trabajos para recibir 950 imágenes utilizables, lo que es aproximadamente 5% más por imagen utilizable de lo que sugiere la etiqueta. Si los trabajos fallidos no se facturan, pagas por 950. Mismo precio de titular, diferente precio efectivo.
La fórmula que usaría para una estimación mensual: volumen esperado × precio unitario × factor de reintento, más un colchón para ediciones y vídeo. El factor de reintento es el número que separa una previsión de un deseo.
Luego compara los precios unitarios con tu propia prueba de aceptación en lugar de con la galería de muestras del proveedor. Si quieres la lógica subyacente de la tarificación de token, imagen y clip en un solo lugar, este desglose de modelos de precios de IA explica cómo se mide cada unidad.
Ejecuta una llamada de prueba antes de elegir tu modelo
Una llamada de prueba debería responder a más que un simple «¿Esta imagen se ve bien?». Verifica si el modelo cumple con tus estándares de calidad, cómo maneja las ediciones y cómo se comporta su respuesta bajo la carga esperada. Una imagen de muestra sólida no puede decirte cómo funcionará la API en producción.
Elige un candidato para texto a imagen y uno que admita edición. Mantén el conjunto de prompts fijo entre los candidatos para que puedas comparar las salidas en las mismas tareas. Con UberLLM, puedes cambiar de modelo modificando el identificador del modelo mientras mantienes la API key y el endpoint.
Prueba en orden: primero, califica las salidas según tus criterios de selección; luego, ejecuta la prueba de aceptación de edición si tu función edita imágenes; después, mide la latencia p50 y p95 con la concurrencia esperada. Finaliza calculando el costo por salida utilizable, incluyendo los reintentos. Un modelo que no cumple con los estándares de calidad no necesita una prueba de carga.
Guarda los prompts, las salidas y los registros de solicitud en tu repositorio. Cuando cambies un identificador de modelo o versión, vuelve a ejecutar el mismo conjunto y compara los resultados. Para las ediciones, inspecciona si el resultado conserva los detalles de origen que tu aplicación necesita; una imagen visualmente plausible aún puede alterar la identidad u otras características importantes.
Aprobado o no aprobado: Promociona un modelo solo si pasa las pruebas de calidad, edición y carga al volumen esperado. Despliega detrás de un feature flag y mantén un segundo candidato disponible para failover. Si falla, prueba el siguiente candidato con el mismo conjunto.
El precio es parte de la decisión, pero no debería guiarla. UberLLM lista la generación de imágenes Nano Banana 2 a $0.015 por imagen, en comparación con un precio de lista de $0.10 por imagen. Para pruebas de video, UberLLM recomienda Kling 3.0 Standard como punto de partida para texto a video o imagen a video. Las solicitudes de imagen y video devuelven una tarea que puedes sondear o rastrear a través de un webhook, así que incluye el tiempo hasta la finalización y la recuperación del resultado en tu prueba.
UberLLM ofrece modelos de texto, imagen, video, música y voz a través de interfaces compatibles con OpenAI y Anthropic. Usa su playground para comparar las salidas de imagen, luego ejecuta los mismos prompts de prueba a través del cliente API de tu aplicación. Evalúa la calidad, la fidelidad de edición, la latencia y el costo por resultado utilizable en conjunto antes de elegir un modelo.