So wählen und integrieren Sie eine Bildgenerierungs-API
Vergleichen Sie Funktionen von Bildgenerierungs-APIs, Anfragefelder, asynchrone Ergebnisse, Modelltests, Fehlerbehandlung und Abrechnung, mit Schritten zur Produktionsintegration.
Mehr als 15 Milliarde Bilder waren bis August 2023, mit Text-zu-Bild-Algorithmen erstellt worden, durchschnittlich etwa 34 Millionen pro Tag, seit dem Start von DALL-E 2, laut einer Everypixel-Analyse der KI-Bildstatistiken. Dieselbe Analyse schreibt etwa 12.6 Milliarden davon, grob 80%, Stable Diffusion-basierten Modellen, Diensten und Anwendungen zu.
Bei diesem Volumen hört die Bilderzeugung auf, eine kreative Demo zu sein, und wird zur Infrastruktur. Die Fragen, die entscheiden, ob ein Produkt ausgeliefert wird, hören auf, sich darum zu drehen, welches Modell schönere Bilder malt, und beginnen, sich um Request-Verträge, Job-Zustände, Timeout-Verhalten und darum zu drehen, ob eine fehlgeschlagene Generierung immer noch auf Ihrer Rechnung landet.
Dies ist ein Leitfaden für Entwickler zur image generation API-Schicht. Er behandelt, wie Requests geformt werden, wie Aufgaben einen Lebenszyklus durchlaufen, wie man ein Modell testet, anstatt einem Leaderboard zu vertrauen, und wo sich Kosten verstecken. Der Preis pro Bild ist die am einfachsten zu vergleichende Zahl und die am wenigsten nützliche für sich allein.
Inhaltsverzeichnis
- Funktionen der Bildgenerierungs-API auf einen Blick
- Anfragemuster und Antwortfelder
- Asynchrone Jobs, Aufgabenstatus und Ergebnisabruf
- Modellauswahlkriterien und wie man sie testet
- Überprüfung der Bearbeitungsgenauigkeit und Herkunft vor dem Start
- Latenz, Fehler und Wiederholungsverhalten in der Produktion
- Wie man eine Bild-API Schritt für Schritt integriert
- Abrechnungseinheiten und wie man reale Kosten vergleicht
- Führen Sie einen Testaufruf durch, bevor Sie Ihr Modell wählen
Funktionen der Bildgenerierungs-API auf einen Blick
| Funktion | Eingabe | Ausgabe | Abrufmuster |
|---|---|---|---|
| Textgenerierung | Nachrichten und Parameter | gestreamter Text | Streaming-Antwort |
| Text zu Bild | Prompt, Größe, Modell-Identifikator | ein oder mehrere Bilder | Task, abgefragt oder Webhook |
| Bildbearbeitung | Quellbild, Anweisung, optionale Maske (falls unterstützt) | bearbeitetes Bild | Task, abgefragt oder Webhook |
| Text zu Video | Prompt, Dauer, Auflösung | Videodatei | Task, abgefragt oder Webhook |
| Bild zu Video | Quellbild, Prompt, Dauer | Videodatei | Task, abgefragt oder Webhook |
| Musikgenerierung | Prompt, Stil, Dauer | Audiodatei | Task, abgefragt oder Webhook |
| Sprachsynthese | Text, Stimme | Audiodatei | gestreamtes Audio oder eine zurückgegebene Datei |
Ein einziger endpoint und ein einziger API key können mehrere Modellfamilien gleichzeitig abdecken, da der Modell-Identifikator die Familie und die Version auswählt. Diese Bequemlichkeit hat jedoch einen Haken. Jede Familie akzeptiert einen anderen Parametersatz, sodass ein Body, der für ein Modell gültig ist, bei einem anderen fehlschlagen kann, und Größen, Masken, Seed-Unterstützung sowie Multi-Output-Limits unterscheiden sich alle zwischen ihnen.
Eine Bildgenerierungs-API ist ein gehosteter Inferenzdienst mit drei Teilen: einem Anfragevertrag, der einen Prompt und Einstellungen in einen signierten Aufruf umwandelt, einem Ergebnisobjekt, das das Bild plus seine Metadaten enthält, und einem Job-Lebenszyklus für Aufgaben, die eine einzelne HTTP-Antwort überdauern. Jeder Teil erfordert eigene Designentscheidungen, und jeder fällt anders aus.
Das Muster ist jünger, als es aussieht. Die öffentliche Veröffentlichung von Stable Diffusion am 22. August 2022 etablierte die Bereitstellungsform, die die meisten Anbieter immer noch verwenden, wie TechCrunch zum Start berichtete: Eine Anwendung sendet einen Prompt und Parameter, der Anbieter führt die GPU-Arbeit aus, und ein Bild oder ein Task kommt zurück. Dieses Modell lief auf High-End-Consumer-Hardware und erzeugte in wenigen Sekunden 512×512-Pixel-Bilder, trainiert auf LAION-5B, einem Datensatz von ungefähr 5.85 Milliarden Bild-Text-Paaren mit einer ästhetisch gefilterten Untermenge von etwa 600 Millionen. Stability AI behauptete, dass mehr als 15,000 Tester während des frühen öffentlichen Zugangs täglich rund 2 Millionen Bilder generierten, was das deutlichste frühe Signal dafür ist, dass gehosteter Zugang und nicht Desktop-Software die Form der Nachfrage war.
Die folgenden Abschnitte folgen der Reihenfolge, in der eine reale Integration auf diese Probleme stößt: zuerst Anfragefelder und Antwortobjekte, dann asynchrone Task-Zustände, Modell-Auswahltests, Bearbeitungsgenauigkeit und Herkunft, Latenz und Wiederholungsversuche, Schritt-für-Schritt-Integration, Abrechnungseinheiten und ein abschließender Testaufruf. Teams, die Generierungen in eine automatisierte Pipeline integrieren, möchten in der Regel den gesamten Ablauf einmal demonstriert bekommen, und diese exemplarische Darstellung einer Bild-API für Automatisierungs-Workflows zeigt den vollständigen Zyklus vom Auslöser bis zum gespeicherten Asset.
Anfragemuster und Antwortfelder
Die meisten ersten Integrationen scheitern am Request Body und selten wegen des Prompts. Erstellen Sie die Felder in der Reihenfolge, in der sie übertragen werden, und das Debugging wird kürzer.
- Modell-ID. Berücksichtigen Sie sie zuerst in Ihren Überlegungen, da sie entscheidet, welche der verbleibenden Felder zulässig sind. Ein negativer Prompt oder eine Maske, die ein Modell akzeptiert, wird vom nächsten abgelehnt.
- Prompt und negativer Prompt. Der negative Prompt ist bei einigen Familien ein unterstütztes Feld und wird bei anderen ignoriert, prüfen Sie also lieber, anstatt anzunehmen.
- Größe oder Seitenverhältnis. Geben Sie es so an, wie das Modell es erwartet, in Pixeln oder in benannten Verhältnissen. Validieren Sie es lokal vor der Inferenz, denn ein abgelehnter Aufruf kostet einen Round Trip, während eine spät fehlschlagende Generierung einen Timeout und einen Warteschlangenslot kostet.
- Anzahl der Ausgaben. Mehrere Ausgaben pro Aufruf wirken effizient, bis Sie bemerken, dass die Abrechnung normalerweise mit der Anzahl, nicht mit dem Aufruf skaliert.
- Ausgabeformat. PNG, JPEG oder WebP verändert Ihre nachgelagerte Konvertierungsarbeit ebenso wie Ihre Byte-Anzahl.
- Seed. Fügen Sie ihn immer dann hinzu, wenn Reproduzierbarkeit wichtig ist. Ohne ihn bedeutet „das noch einmal ausführen“ „die Würfel noch einmal rollen lassen“.
- Webhook URL. Lange Jobs werden beendet, nachdem Ihre Anfrage zurückgekehrt ist, und ein Callback ist günstiger als eine enge Polling-Schleife.
- Idempotenzschlüssel. Die Generierung ist teuer, daher wird ein wiederholter Erstellungsvorgang ohne Schlüssel zu einem zweiten abgerechneten Job und einem doppelten Bild.
Validieren Sie, bevor Sie ausgeben. Überprüfen Sie zuerst das Seitenverhältnis, die Modell-ID und die erforderlichen Felder in Ihrem eigenen Code. Eine lokale Schemaüberprüfung fängt die Fehlerklasse ab, die sonst als 400 nach einer Warteschlange auftaucht, und sie hält fehlerhaften Traffic vollständig von einem kostenpflichtigen Endpoint fern.
Auf der Antwortseite verlieren Teams Assets, für die sie bereits bezahlt haben. Die Bild-API-Referenz von OpenAI zeigt die Form, auf die sich die meisten Anbieter einigen, ein Bildobjekt mit einem base64 Payload, einer gehosteten URL und, falls unterstützt, einem überarbeiteten Prompt. Normalisieren Sie alles, was der Anbieter zurückgibt, in Ihr eigenes stabiles Schema, und bewahren Sie einen rohen Anbieter-Metadatenblock für Steuerelemente auf, die Ihr Schema noch nicht modelliert.
| Feld | Inhalt | Produktionshinweis |
|---|---|---|
| Asset-URL | Link zur generierten Datei | kurzlebig und zugriffsgesteuert, daher vor Ablauf herunterladen |
| b64_json | base64-kodierte Bild-Bytes | gut für kleine synchrone Antworten, speicherintensiv für große Payloads |
| revised_prompt | der Prompt, wie das Modell ihn umformuliert hat | speichern Sie ihn, da er Ausgaben erklärt, die Sie nicht erwartet haben |
| Modell-ID | das Modell und die Version, die die Ausgabe erzeugt haben | erforderlich für Audit und Reproduktion |
| Dimensionen und Format | Breite, Höhe und MIME type | mit dem angeforderten Seitenverhältnis abgleichen |
| Prüfsumme | Integritäts-Hash der Datei | nach dem Download und nach jeder Formatkonvertierung überprüfen |
Behandeln Sie base64 als Transportdetail, nicht als Speicherstrategie. Ein kodiertes Bild bläht den Payload um etwa ein Drittel auf und verbleibt im Speicher, während Ihre App JSON parst. Für Produktionsmedien schreiben Sie die dekodierten Bytes in den Objektspeicher und übergeben Sie Ihrem Frontend stattdessen eine signierte Abruf-URL. Fügen Sie den MIME type und eine Prüfsumme zum Datensatz hinzu, wenn Sie schon dabei sind, damit ein beschädigter Download von Ihrer Pipeline und nicht von einem Benutzer abgefangen wird.
Die Regel, die ich in Code-Reviews durchsetzen würde: jedes gespeicherte Asset trägt die Modell-ID, den Seed, den effektiven Prompt und den Anfrage-Zeitstempel in seinen Metadaten. Ohne diese vier hat ein Support-Ticket über „ein seltsames Bild vom letzten Monat“ keine Antwort.
Diese Gewohnheit zahlt sich aus, wenn sich zum ersten Mal eine Modellversion ändert und die Ausgabe abweicht. Die gespeicherten Metadaten verwandeln eine vage Beschwerde in einen Vergleich, den Sie durchführen können.
Asynchrone Aufträge, Aufgabenstatus und Ergebnisabruf
Bild- und Videoarbeiten werden nicht innerhalb einer Chat-Completion zurückgegeben. Erstellen Sie einen Auftrag, behalten Sie die Kennung und beobachten Sie dann dessen Fortschritt.
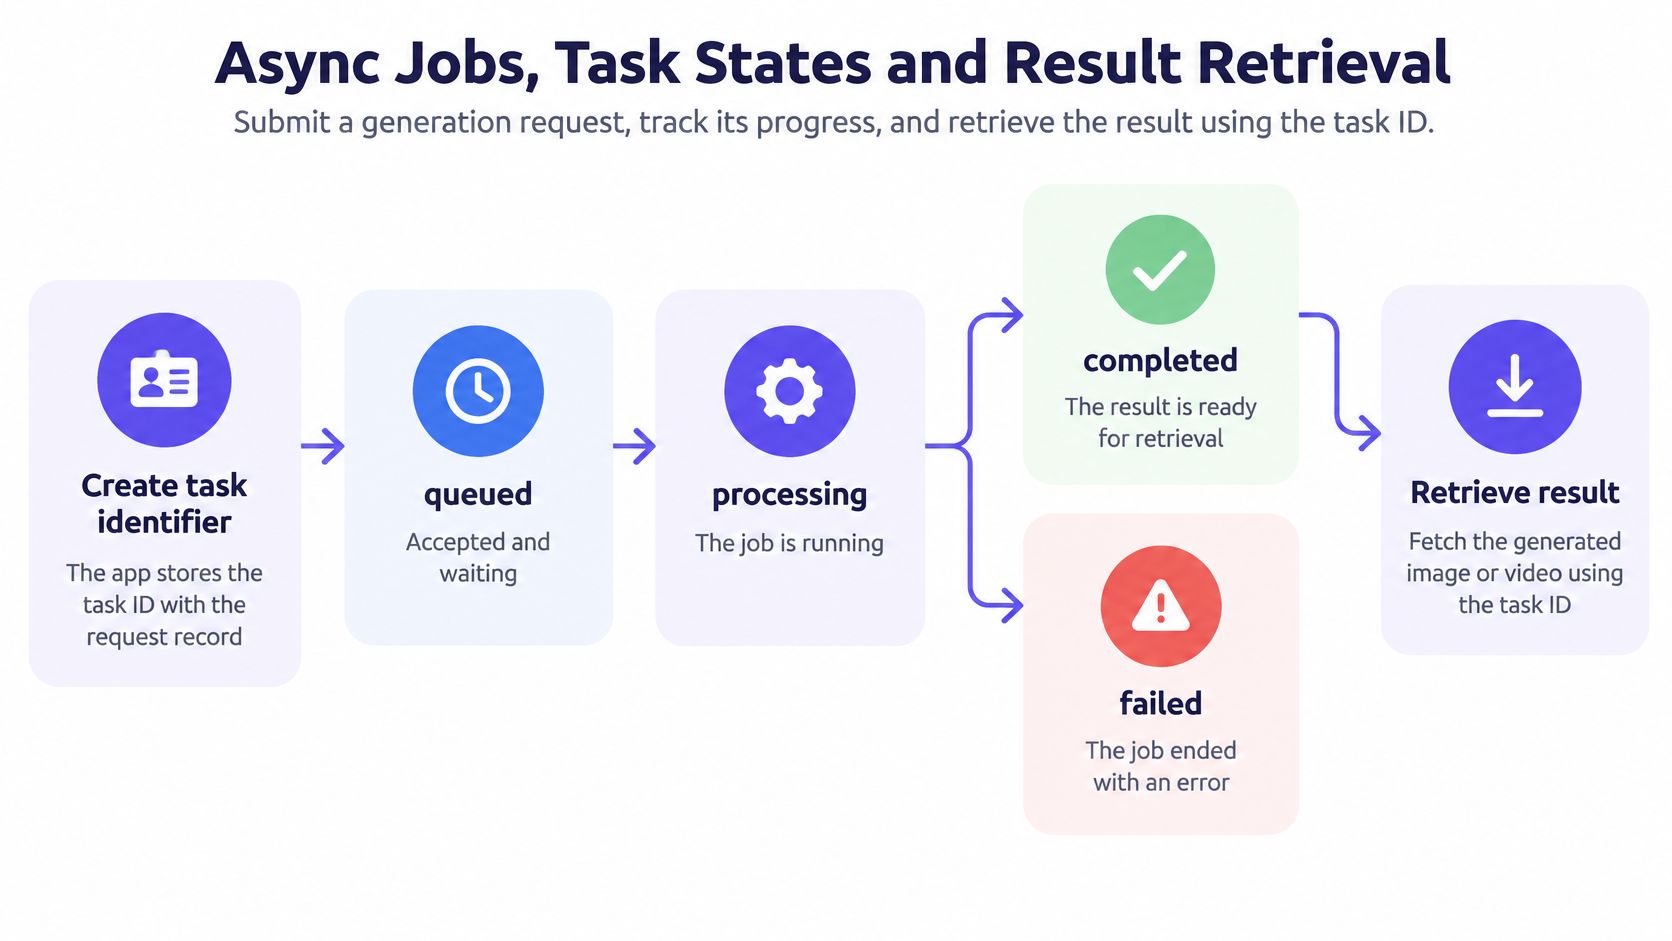
Der create-Aufruf gibt eine task identifier zurück, und Ihre Anwendung schreibt diese in denselben Anforderungsdatensatz, der den Prompt und das Modell enthält. Von dort meldet der Auftrag einen von fünf Status, und jeder erfordert etwas anderes von Ihrem Code.
| Status | Bedeutung | Was die App tut |
|---|---|---|
| queued | akzeptiert und wartet auf Kapazität | task ID beibehalten und nach Zeitplan pollen |
| running | Generierung läuft | warten und einen timeout durchsetzen, der auf die Modalität zugeschnitten ist |
| succeeded | Output ist bereit | Asset sofort herunterladen und speichern |
| failed | Generierung nicht abgeschlossen | Fehlerkategorie vor einem erneuten Versuch lesen |
| expired | Output ist nicht mehr abrufbar | neu generieren und nicht als fehlendes Ergebnis behandeln |
Der Status expired überrascht Teams, weil es wie ein Fehler im eigenen System aussieht. Das ist es aber nicht. Anbieter bewahren Ergebnisdateien für ein begrenztes Zeitfenster auf, und dieses Zeitfenster ist kurz. Bei UberLLM bleiben Bild-Links etwa 15 Minuten lang aktiv, und Video- und Musik-Ergebnisdateien werden etwa 3 Stunden nach Abschluss des Auftrags aufbewahrt. Eine polling loop, die alle zehn Minuten prüft und im nächsten deploy cycle agiert, wird Bild-Links vollständig verpassen.
Der Abruf basiert auf zwei Mechanismen, und ausgereifte Systeme nutzen beide. Polling deckt die Lieferungen ab, die ein webhook verloren hat, und ist die einzige Option, wenn Ihr Dienst keinen öffentlichen endpoint exponieren kann. Webhooks reduzieren verschwendete Anfragen, indem sie Ihnen genau mitteilen, wann sich der Status geändert hat, was wichtig ist, wenn ein Auftrag eine Minute statt einer Sekunde dauert. Die Kompromisse zwischen webhooks und polling laufen auf die Fehlerbehandlung hinaus: webhooks schlagen fehl, wenn Ihr Receiver nicht verfügbar ist, und polling schlägt teuer fehl, wenn Ihr Intervall zu eng ist.
Polling-Intervalle sollten der Modalität folgen, nicht der Codebase. Eine einzelne feste Schleife, die für einen 4-sekündigen Bildauftrag funktioniert, verschwendet Dutzende von Aufrufen bei einem Videoauftrag, der eine Minute oder länger läuft.
Textantworten streamen token für token zurück, während Bild- und Videoaufträge Ihnen eine Aufgabe übergeben, die Sie pollen, oder ein webhook als bereit meldet. Dieser Unterschied ist architektonisch, nicht kosmetisch: Die Anfrage, die sofort zurückkehrt, besitzt immer noch Arbeit, die nicht abgeschlossen ist, und jemand muss sich daran erinnern. Protokollieren Sie die Statusübergangszeiten sowie den Endstatus, denn die Lücke zwischen queued und running ist der Ort, an dem Kapazitätsprobleme auftreten, bevor sie die Benutzer erreichen.
Kriterien für die Modellauswahl und wie man sie testet
Öffentliche Rankings bewerten Modelle anhand von Prompts, die niemand in Ihrem Produkt jemals senden wird. Sie messen die Stichprobenqualität unter Bedingungen, die Sie nicht kontrollieren, und sie sagen nichts über Latenz-Spitzen, Konsistenz bei Ablehnungen oder darüber aus, wie sich Ausgaben zwischen Builds verschieben. Ein Testsatz, der aus Ihren eigenen Bildkategorien erstellt wurde, verrät Ihnen an einem Nachmittag mehr, als eine Bestenliste in einem Monat, und er überlebt die nächste Modellversion.
Die Evaluierung muss ein messbares Verhalten sein, keine Geschmacksfrage. Formale Evaluierungsprogramme behandeln die Bilderzeugung auf die gleiche Weise, wie ein Lasttest den Durchsatz behandelt: definierte Protokolle, feste Eingaben und bewertete Ausgaben anstelle von Rezensenten-Eindrücken. Eine Produktions-API sollte bei jedem Aufruf dieselben reproduzierbaren Dimensionen protokollieren: Prompt-Kategorie, Modell und Version, Seed (falls verfügbar), Auflösung, Latenz, Fehlermodus und Sicherheitsergebnis. Protokollieren Sie die Latenz pro Anfrage, damit die Spitze sichtbar bleibt, denn ein gesunder Median kann über Jobs liegen, die lange genug hängen bleiben, um Ihr Timeout zu erreichen.
| Kriterium | Wie messen | Erfolgssignal |
|---|---|---|
| Prompt-Einhaltung | bewertete Überprüfung eines festen Prompt-Sets pro Kategorie | erforderliche Objekte, Anzahlen und Farben erscheinen in den meisten Ausgaben |
| Wahrnehmungsqualität | blinde Side-by-Side-Überprüfung durch das Team | Rezensenten wählen Ausgaben aus, ohne zu wissen, welches Modell sie erstellt hat |
| Textdarstellung | Prompts, die exakte Wörter oder Beschriftungen erfordern | Wörter sind in den meisten Stichproben korrekt geschrieben |
| Identitätskonsistenz | dasselbe Subjekt über mehrere Generationen hinweg | Gesicht, Produkt oder Charakter bleiben erkennbar |
| Ablehnungsverhalten | Prompts, die abgelehnt werden sollten | Ablehnungen sind konsistent und fallen in klare Kategorien |
| Reproduzierbarkeit | wiederholte Aufrufe mit demselben Seed und derselben Modellversion | Ausgaben bleiben ähnlich, wenn Seed und Version übereinstimmen |
Bewerten Sie jede Zeile separat. Eine aggregierte Zahl verbirgt ein Modell, das Produktetiketten perfekt darstellt und jeden Prompt ablehnt, der ein Kind enthält, oder eines mit schönen Porträts und Text, der wie ein CAPTCHA aussieht. Der Fehler, der schmerzt, ist immer kategoriespezifisch, und ihn in einer einzigen Punktzahl zu mitteln, ist der Weg, wie er unbemerkt in die Produktion gelangt.
Routing fügt ein Governance-Problem hinzu, das der Modelltest nicht erfassen wird. Wenn ein Marktplatz oder eine Failover-Schicht Anbieter wechselt, muss der Ersatz gleichwertige Moderationsgarantien bieten, oder das Ergebnis muss explizit als mit unterschiedlichen Zusicherungseigenschaften gekennzeichnet werden. Die stille Lockerung von Sicherheitsprüfungen ist das schlechteste mögliche Failover-Verhalten: nichts schlägt fehl, und die Ausgabe kommt einfach mit einer schwächeren Überprüfung dahinter an. Halten Sie Moderationsentscheidungen und Modellversionen im Audit-Protokoll fest und legen Sie Fehlerkategorien offen, auf die Ihre Anwendung verzweigen kann.
Stichprobengröße, die in der Praxis funktioniert: einige Dutzend Prompts pro Kategorie für einen ersten Durchlauf, wobei die exakten Prompts und Ausgaben in einem Repo gespeichert werden. Führen Sie den gesamten Satz erneut aus, wann immer sich eine Modellversionszeichenfolge ändert, nicht nur, wenn sich jemand beschwert.
Dieser letzte Punkt ist der, den Teams überspringen. Ein Modell-Identifikator kann auf einen neuen Build verweisen, ohne dass sich auf Ihrer Seite etwas ändert, daher ist der Testsatz kein Start-Artefakt, sondern eine Regression Suite, die in jedem Release-Zyklus läuft. Wenn die Ergebnisse an Stakeholder außerhalb des Engineerings gehen, bietet eine verständliche Erläuterung dessen, was ein einzelnes Modell leistet, erklärt von ImagesArt AI, dieser Unterhaltung eine gemeinsame Grundlage, bevor die Bewertungsdebatte beginnt.
Überprüfung der Bearbeitungstreue und Herkunft vor dem Start
Eine gut aussehende Bearbeitung ist keine erfolgreiche Bearbeitung. Bearbeitungen müssen doppelt bewertet werden, einmal danach, ob die angeforderte Änderung stattgefunden hat, und einmal danach, ob alles andere an seinem Platz geblieben ist. Wenn man sich nur auf die erste Bewertung verlässt, erhält man ein Produktfoto, bei dem das Modell das Logo neu gezeichnet hat.
Die Forschung unterstützt diese Aufteilung. Das HQ-Edit-Paper führt Alignment und Coherence als separate Metriken ein und berichtet, dass Fine-Tuning die Alignment um 12.3 Punkte und die Coherence um 5.64 Punkte in einem evaluierten System verbessert hat. Zwei sich unabhängig voneinander bewegende Zahlen sind das ganze Argument: Eine Ausgabe kann der Anweisung folgen und trotzdem die Teile zerstören, die Sie erhalten wollten, oder alles erhalten und die Anweisung ignorieren.
Der Akzeptanztest, den ich vor dem Start durchführen würde:
- Wählen Sie 20 bis 30 Quellbilder, die Gesichter, gedruckten Text, Logos und unruhige Hintergründe enthalten. Allein beschnittene Produktfotos würden ein Modell bestehen lassen, das bei einem Gesicht versagt.
- Schreiben Sie eine Anweisung pro Bild und notieren Sie die erwartete Änderung in derselben Zeile. Mehrdeutige Anweisungen führen zu Diskussionen über Ergebnisse statt zu Erkenntnissen.
- Maskieren Sie den bearbeiteten Bereich und vergleichen Sie den Rest mit der Quelle. Die Pixel außerhalb der Maske sind Ihr Erhaltungswert, und ein numerischer Vergleich klärt, was das bloße Auge nicht kann.
- Bewerten Sie Alignment und Preservation in separaten Spalten, und betrachten Sie dann die Fälle, in denen sie nicht übereinstimmen. Das sind die Prompts, die neu formuliert werden müssen, oder das Modell, das ersetzt werden muss.
- Führen Sie jede Ausgabe durch Größenänderung und Formatkonvertierung, und bestätigen Sie dann, dass Wasserzeichen oder Inhaltsnachweise überlebt haben. Herkunft, die in Ihrer CDN-Pipeline verloren geht, ist Herkunft, die Sie nie hatten.
- Bestätigen Sie die Inhaltsrichtlinie des Anbieters und jede Offenlegungspflicht, die in den Märkten gilt, in die Sie liefern. Die Richtlinie variiert je nach Anbieter, und eine weitergeleitete Anfrage kann unter einer anderen landen.
- Protokollieren Sie die Nachweiskette von der Quelldatei bis zum gelieferten Asset, einschließlich der Modellversion, die es bearbeitet hat.
Schritt fünf ist der, den Teams spät entdecken. Anmeldeinformationen und unsichtbare Wasserzeichen sind Beweise für die Herkunft, nicht der Beweis, dass ein dargestelltes Ereignis wahr ist. Die Zuverlässigkeit hängt von vertrauenswürdigen Identitäten, dem Signaturprozess und davon ab, ob jeder nachfolgende Schritt die Metadaten bewahrt, daher müssen Größenänderung, Zuschneiden und Neukodierung alle überprüft werden. Ein Herkunftssignal verbessert die Rückverfolgbarkeit, kann aber weder die faktische Authentizität feststellen noch bestätigen, dass die Rechte geklärt sind.
Die unbequeme Schlussfolgerung für jeden, der eine Bearbeitungsfunktion entwickelt: Metadaten zur Herkunft beantworten die Frage "woher kam das?", und sie beantworten niemals die Frage "ist diese Behauptung korrekt" oder "haben wir die Lizenz". Das bleiben rechtliche und redaktionelle Fragen.
Wenn die Bearbeitungsoberfläche das Produkt ist, behandeln Sie die Bereichserhaltung als ein K.O.-Kriterium statt als einen Qualitätswert. Ein Leitfaden für Foto-Bearbeitungs-APIs ist ein nützlicher Begleiter für die Endpoint- und Parameterseite, und dieser AskYourQA-Leitfaden zum Testen von KI hilft, die Bewertung so zu strukturieren, dass Alignment und Preservation nicht zu einem einzigen Eindruck verschmelzen.
Latenz, Fehler und Wiederholungsverhalten in der Produktion
Die meisten Vergleiche von Bild-APIs bewerten den Preis pro Bild und die Beispielqualität und hören dann auf. Latenz-Spitzen, Fehlerraten und Wiederherstellungsverhalten sind die Zahlen, die darüber entscheiden, ob Ihr Feature fehlerhaft wirkt, und es sind die Zahlen, die niemand veröffentlicht. Ein Benchmark für die Bilderzeugung besagt ausdrücklich, dass Latenz und beobachtete Verfügbarkeit für eine zukünftige Phase reserviert sind, während ein unabhängiger Test feststellte, dass Anbieter im Allgemeinen keine tatsächlichen Latenzwerte veröffentlichen und selbst Antwortzeiten, Fehlerraten, Kaltstarts und Durchsatz messen mussten, wie die API Benchmarks Bildgenerierungsanalyse dokumentiert.
Messen Sie Perzentile, nicht Durchschnitte. Verfolgen Sie p50, p95 und p99 separat für synchrone und asynchrone Bildaufrufe, und fügen Sie dann die Timeout-Rate, die Kaltstart-Strafe, die Zeit von der Erstellung bis zum abrufbaren Ergebnis und die Erfolgsrate der Ausgabe hinzu. Ein einziger Durchschnitt verbirgt die Spitze, die Benutzer erleben, nämlich die zwei Sekunden, in denen die meisten Anfragen landen, und die vierzig, in denen einige nicht landen.
Zeitliche Überraschungen hängen meist mit der Modalität zusammen. In unserem Test auf 29. Oktober 2026 dauerte die Generierung eines 5-sekündigen Kling 3.0 Clips etwa 80 Sekunden. Nichts war falsch; Video kostet einfach Minuten, wo Bilder Sekunden kosten, und ein vom Bildpfad kopiertes Timeout bricht Jobs ab, die normal voranschritten.
| Symptom | Wahrscheinliche Ursache | Lösung |
|---|---|---|
| Aufgaben bleiben über das Timeout hinaus im Status "running" | langsamer oder nicht verfügbarer Anbieter | abbrechen, dann mit demselben Idempotenzschlüssel erneut versuchen oder, falls verfügbar, umleiten |
| Duplizierte Bilder nach einem Netzwerk-Timeout | Erstellungsaufruf ohne Idempotenzschlüssel wiederholt | senden Sie einen Idempotenzschlüssel mit jeder Erstellungsanfrage |
| 429 Antworten während Bursts | Ratenbegrenzung erreicht | exponentiell mit Jitter zurücktreten und Anfragen in die Warteschlange stellen |
| 503 Antworten | Anbieter oder Route vorübergehend nicht verfügbar | später mit einer Obergrenze erneut versuchen und nur bei Einhaltung der Sicherheitsgarantien ein Failover durchführen |
| 402 Antworten | Guthaben- oder Zahlungsprüfung fehlgeschlagen | Guthaben aufladen, dann dieselbe Anfrage erneut senden |
| 404 Antworten | Modell-ID oder Route nicht gefunden | die ID mit dem aktuellen Katalog abgleichen |
| Bildlink lädt nicht mehr | signierte URL ist abgelaufen | bei Erfolg herunterladen und die Datei im eigenen Speicher ablegen |
Wiederholen Sie nur das, was wiederholbar ist. Ein 429 oder ein 503 ist transient und verdient einen exponentiellen Backoff mit Jitter und einer harten Obergrenze. Ein 402 oder ein 404 wird für immer identisch fehlschlagen, also beheben Sie zuerst das Guthaben oder die Modell-ID. Unsere API lehnt Aufrufe mit 402, 404, 429 und 503, ab, und die Kategorie ist das Signal, nicht nur der HTTP-Status.
Die gegenteilige Lesart der Kosten: die günstigste API pro Bild ist in der Produktion oft die teuerste. Wiederholungsversuche, fehlgeschlagene Generierungen und unvorhersehbare Latenz-Spitzen drängen die Arbeit zurück in Ihre Anwendung und die Benutzer aus Ihrem Funnel.
Zuverlässigkeit ist bereits ein Kaufkriterium, bei 37% der Organisationen, hinter Kostenoptimierung bei 58%, Modellverfügbarkeit bei 49% und Geschwindigkeit bei 41%, laut derselben Benchmarking-Analyse. Und der Kompromiss des Marktplatzes ist real: Das Routing über Anbieter hinweg reduziert Ausfälle, fügt aber auch Varianz in der Warteschlangenzeit, der regionalen Leistung und der Verzögerung des Sicherheitsfilters hinzu. Jede umgeleitete Anfrage sollte als eigene Route mit eigenen Perzentilen gemessen werden, sonst verbirgt das aggregierte Dashboard genau den Pfad, der fehlschlägt.
Wie man eine Image API Schritt für Schritt integriert
Eine Produktionsintegration ist eine kurze Liste von Entscheidungen, und die meisten davon betreffen Datensätze statt Anfragen. Hier ist die Reihenfolge, die den Kontakt mit echtem Traffic überlebt.
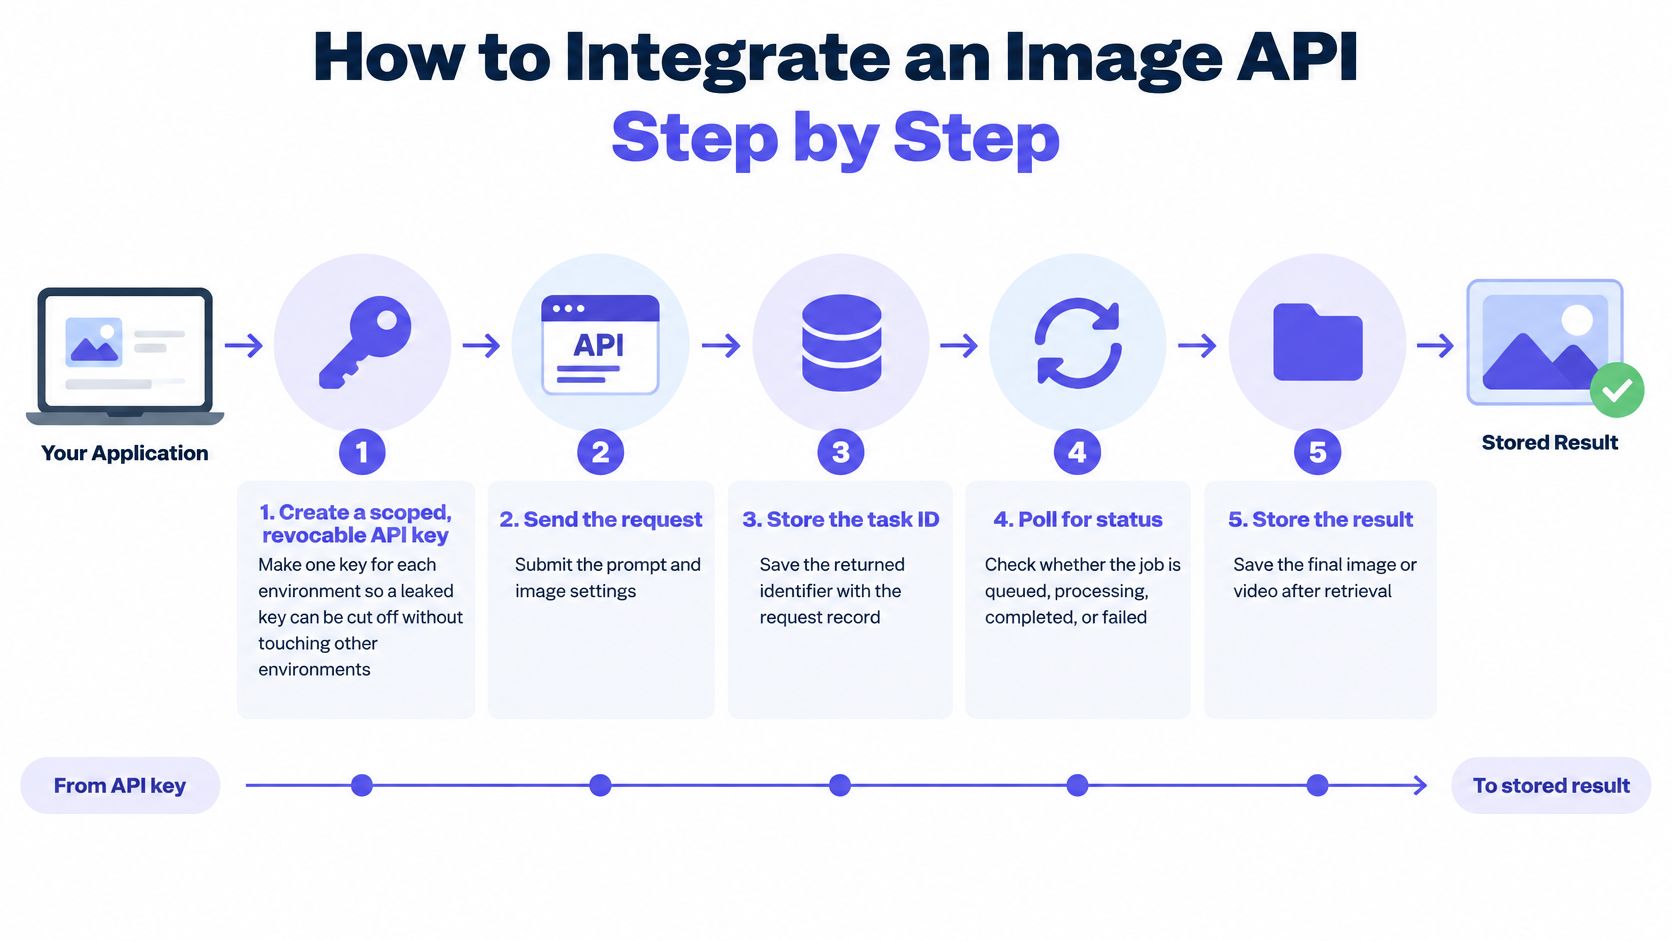
- Erstellen Sie einen bereichsbezogenen, widerrufbaren Schlüssel für jede Umgebung. Separate Schlüssel bedeuten, dass ein durchgesickertes Staging-Zugangsdaten widerrufen werden kann, ohne den Produktions-Traffic zu beeinträchtigen.
- Richten Sie Ihren bestehenden Client auf die neue base URL aus. Die OpenAI-kompatible base ist die UberLLM OpenAI-kompatible base URL, und da die Plattform sowohl OpenAI- als auch Anthropic-Wire-Formate akzeptiert, funktionieren bestehende Clients, sobald die base URL und die credentials geändert werden. Bestätigen Sie, welche image endpoints, von denen Sie abhängen, unterstützt werden, bevor Sie umstellen.
- Kopieren Sie den model identifier als vollständigen String aus dem aktuellen Katalog. Das Wechseln von Modellen ändert dann genau einen Wert, was ein Ein-Zeilen-Diff anstelle eines Refactorings ist. Provider-native IDs funktionieren auf die gleiche Weise, wie zum Beispiel
fal-ai/kling-video/v3/standard/text-to-video. - Validieren Sie Größe und Seitenverhältnis lokal, fügen Sie einen idempotency key hinzu und senden Sie dann den create call. Die günstigen Prüfungen gehören auf Ihre Seite des Netzwerks.
- Speichern Sie den task identifier zusammen mit dem request record, dann pollen Sie oder registrieren Sie einen webhook. Wenn der Prozess zwischen create und store stirbt, haben Sie für eine Ausgabe bezahlt, die niemand finden kann.
- Bei Erfolg laden Sie das asset herunter, überprüfen die checksum und speichern es in Ihrem eigenen storage. Das Warten bis zur nächsten Benutzeranfrage, um die Datei abzurufen, ist der Weg, wie ablaufende Links zu Support-Tickets werden.
- Protokollieren Sie den model identifier, den state, die duration und die error category für jeden job. Diese vier Felder beantworten die meisten Produktionsfragen ohne eine debugging session.
- Testen Sie die Fehlerpfade vor dem Start, einschließlich eines 429,, eines request timeout und eines abgelaufenen Links. Ungetesteter retry code verdoppelt normalerweise die Anzahl der doppelten Bilder, anstatt sie zu reduzieren.
Ein kurzer Walkthrough ist mehr wert als die Feldliste für den ersten Build, besonders im Bereich retrieval:
So sieht eine funktionierende Integration am Ende aus: Jeder job hat einen state, jeder erfolgreiche job hat ein asset in Ihrem bucket, und jedes asset hat eine protokollierte model version daneben. Das ist der ganze Standard. Es ist auch der Unterschied zwischen einer Demo, die jemanden im März beeindruckt hat, und einer Funktion, die Sie im November noch debuggen können.
Abrechnungseinheiten und wie man die tatsächlichen Kosten vergleicht
Zwei APIs können beide "pro Bild" angeben und Sie trotzdem unterschiedlich abrechnen, da die Einheit, die Größenabhängigkeit und die Fehlerrichtlinie die Berechnung verändern. Vergleichen Sie zuerst die Einheit, dann berechnen Sie die Kosten pro nutzbarer Ausgabe.
| Modalität | Übliche Abrechnungseinheit | Was zu prüfen ist |
|---|---|---|
| Texterzeugung | Eingabe- und Ausgabe-tokens | Eingabe und Ausgabe werden separat berechnet |
| Bilderzeugung | pro Bild oder pro Megapixel | Modell und Ausgabegröße ändern die Stückkosten |
| Bildbearbeitung | pro Bearbeitung oder pro Ausgabebild | ob das Quellbild eine Gebühr verursacht |
| Videoerzeugung | pro Clip oder pro Sekunde, je nach Anbieter | wird zum Endpreis abgerechnet, sobald die Erzeugung abgeschlossen ist |
| Musik und Sprache | pro Titel, pro Minute oder pro Zeichen | die Einheit, die jedes Modell tatsächlich verwendet |
| Fehlgeschlagene Aufträge | pro Versuch berechnet oder gar nicht berechnet | ob fehlgeschlagene Erzeugungen auf der Rechnung erscheinen |
Die Abrechnung pro Megapixel bestraft große Ausgaben auf eine Weise, wie es die Abrechnung pro Bild nicht tut. Ein Modell, das bei 1024×1024 günstig aussieht, kann bei Druckauflösung ein Vielfaches kosten, vergleichen Sie also in der Größe, in der Ihr Produkt rendert, und nicht in der Größe des Marketing-Screenshots.
Video benötigt eine eigene Position in der Prognose. Ein Clip, der zum Endpreis abgerechnet wird, sobald die Erzeugung abgeschlossen ist, ist einfacher zu prognostizieren als einer, der während der Laufzeit gemessen wird, weil Sie fertige Ausgaben prognostizieren und nicht die Unsicherheit der Echtzeit. Bearbeitungen sind die heimtückische Zeile: prüfen Sie, ob das Quellbild als Eingabe berechnet wird, da ein Retusche-Workflow, der bei jedem Aufruf eine 4 MB Quelle sendet, die Stückkosten weit über den beworbenen Bearbeitungspreis hinaus treiben kann.
Fehlgeschlagene Erzeugungen sind der Posten, der letztendlich zwischen zwei Anbietern entscheidet. Nehmen wir 1,000 Bildaufträge mit einer 5% Fehlerrate. Wenn fehlgeschlagene Aufträge berechnet werden, zahlen Sie für 1,000 Aufträge, um 950 nutzbare Bilder zu erhalten, was ungefähr 5% mehr pro nutzbarem Bild ist, als der Aufkleber vermuten lässt. Wenn fehlgeschlagene Aufträge nicht berechnet werden, zahlen Sie für 950. Gleicher Listenpreis, anderer effektiver Preis.
Die Formel, die ich für eine monatliche Schätzung verwenden würde: erwartetes Volumen × Stückpreis × Wiederholungsfaktor, plus einen Puffer für Bearbeitungen und Video. Der Wiederholungsfaktor ist die Zahl, die eine Prognose von einem Wunsch trennt.
Vergleichen Sie dann die Stückpreise mit Ihrem eigenen Akzeptanztest und nicht mit der Mustergalerie des Anbieters. Wenn Sie die zugrunde liegende Logik der token-, Bild- und Clip-Preise an einem Ort haben möchten, erklärt diese Aufschlüsselung der KI-Preismodelle, wie jede Einheit gemessen wird.
Führen Sie einen Testaufruf durch, bevor Sie Ihr Modell wählen
Ein Testaufruf sollte mehr beantworten als nur „Sieht dieses Bild gut aus?“ Prüfen Sie, ob das Modell Ihre Qualitätsanforderungen erfüllt, wie es mit Bearbeitungen umgeht und wie sich seine Antwort unter erwarteter Last verhält. Ein überzeugendes Beispielbild kann Ihnen nicht sagen, wie die API in der Produktion funktionieren wird.
Wählen Sie einen Kandidaten für Text-zu-Bild und einen, der Bearbeitungen unterstützt. Halten Sie den Prompt-Satz über alle Kandidaten hinweg fest, damit Sie die Ausgaben für dieselben Aufgaben vergleichen können. Mit UberLLM können Sie Modelle wechseln, indem Sie den Modell-Identifier ändern, während Sie den API key und den endpoint beibehalten.
Testen Sie der Reihe nach: Bewerten Sie zuerst die Ausgaben anhand Ihrer Auswahlkriterien; als Nächstes führen Sie den Bearbeitungs-Akzeptanztest durch, wenn Ihre Funktion Bilder bearbeitet; messen Sie dann die p50- und p95-latency bei erwarteter Parallelität. Schließen Sie ab, indem Sie die Kosten pro nutzbarer Ausgabe berechnen, einschließlich Wiederholungsversuchen. Ein Modell, das die Qualitätsanforderungen nicht erfüllt, benötigt keinen Lasttest.
Speichern Sie Prompts, Ausgaben und Anfrage-Logs in Ihrem Repository. Wenn Sie einen Modell-Identifier oder eine Version ändern, führen Sie denselben Satz erneut aus und vergleichen Sie die Ergebnisse. Bei Bearbeitungen prüfen Sie, ob das Ergebnis die Quelldetails bewahrt, die Ihre Anwendung benötigt; ein visuell plausibles Bild kann dennoch die Identität oder andere wichtige Merkmale verändern.
Go oder No-Go: Bewerben Sie ein Modell nur, wenn es die Qualitäts-, Bearbeitungs- und Lasttests bei erwartetem Volumen besteht. Liefern Sie es hinter einem Feature Flag aus und halten Sie einen zweiten Kandidaten für den Failover bereit. Wenn es fehlschlägt, testen Sie den nächsten Kandidaten mit demselben Satz.
Der Preis gehört zur Entscheidung, sollte sie aber nicht anführen. UberLLM listet die Bilderzeugung mit Nano Banana 2 zu $0.015 pro Bild auf, verglichen mit einem Listenpreis von $0.10 pro Bild. Für Videotests empfiehlt UberLLM Kling 3.0 Standard als Ausgangspunkt für Text-zu-Video oder Bild-zu-Video. Bild- und Videoanfragen geben eine Aufgabe zurück, die Sie abfragen oder über einen Webhook verfolgen können. Berücksichtigen Sie daher die Zeit bis zur Fertigstellung und zum Abruf des Ergebnisses in Ihrem Test.
UberLLM bietet Text-, Bild-, Video-, Musik- und Sprachmodelle über OpenAI- und Anthropic-kompatible Schnittstellen an. Nutzen Sie den Playground, um Bildausgaben zu vergleichen, und führen Sie dann dieselben Test-Prompts über den API client Ihrer Anwendung aus. Bewerten Sie Qualität, Bearbeitungsgenauigkeit, latency und Kosten pro nutzbarem Ergebnis gemeinsam, bevor Sie ein Modell wählen.