Come scegliere e integrare un'API per la generazione di immagini
Confronta le capacità delle API di generazione di immagini, i campi di richiesta, i risultati asincroni, i test dei modelli, la gestione degli errori e la fatturazione, con i passaggi per l'integrazione in produzione.
Più di 15 miliardo di immagini erano state create con algoritmi text-to-image entro agosto 2023,, una media di circa 34 milioni al giorno dal lancio di DALL-E 2, secondo un'analisi di Everypixel sulle statistiche delle immagini AI](https://journal.everypixel.com/ai-image-statistics). La stessa analisi attribuisce circa 12.6 miliardi di esse, circa il 80%, a modelli, servizi e applicazioni basati su Stable Diffusion.
A quel volume, la generazione di immagini smette di essere una demo creativa e diventa infrastruttura. Le domande che decidono se un prodotto viene rilasciato smettono di riguardare quale modello dipinge immagini più belle e iniziano a riguardare i contratti di richiesta, gli stati dei job, il comportamento del timeout e se una generazione fallita finisce comunque sulla tua fattura.
Questa è una guida per sviluppatori al livello API di generazione di immagini. Copre come vengono strutturate le richieste, come i task si muovono attraverso un ciclo di vita, come testare un modello invece di fidarsi di una classifica e dove si nascondono i costi. Il prezzo per immagine è il numero più facile da confrontare e il meno utile da solo.
Indice
- Funzionalità dell'API di generazione immagini a colpo d'occhio
- Pattern di richiesta e campi di risposta
- Lavori asincroni, stati dei task e recupero dei risultati
- Criteri di selezione del modello e come testarli
- Verifica della fedeltà delle modifiche e della provenienza prima del lancio
- Latenza, errori e comportamento di retry in produzione
- Come integrare un'API di immagini passo dopo passo
- Unità di fatturazione e come confrontare i costi reali
- Esegui una chiamata di test prima di scegliere il tuo modello
Funzionalità dell'API di Generazione Immagini a Colpo d'Occhio
| Funzionalità | Input | Output | Pattern di recupero |
|---|---|---|---|
| Generazione di testo | messaggi e parametri | testo in streaming | risposta in streaming |
| Testo a immagine | prompt, dimensione, identificatore del modello | una o più immagini | task, polling o webhook |
| Modifica immagine | immagine sorgente, istruzione, maschera opzionale dove supportata | immagine modificata | task, polling o webhook |
| Testo a video | prompt, durata, risoluzione | file video | task, polling o webhook |
| Immagine a video | immagine sorgente, prompt, durata | file video | task, polling o webhook |
| Generazione musicale | prompt, stile, durata | file audio | task, polling o webhook |
| Sintesi vocale | testo, voce | file audio | audio in streaming o un file restituito |
Un singolo endpoint e una singola chiave possono coprire più famiglie di modelli contemporaneamente, perché l'identificatore del modello è ciò che seleziona la famiglia e la versione. Questa comodità ha un rovescio della medaglia. Ogni famiglia accetta un set di parametri diverso, quindi un corpo che è valido per un modello può fallire su un altro, e dimensioni, maschere, supporto per il seed e limiti di output multiplo differiscono tutti tra loro.
Un'API di generazione immagini è un servizio di inferenza ospitato con tre parti: un contratto di richiesta che trasforma un prompt e le impostazioni in una chiamata firmata, un oggetto risultato che contiene l'immagine più i suoi metadati, e un ciclo di vita del job per il lavoro che sopravvive a una singola risposta HTTP. Ogni parte richiede le proprie decisioni di progettazione, e ognuna fallisce in modo diverso.
Il pattern è più recente di quanto sembri. Il rilascio pubblico di Stable Diffusion il 22 agosto 2022 ha stabilito la forma di servizio che la maggior parte dei provider utilizza ancora, come riportato da TechCrunch al lancio: un'applicazione invia un prompt e dei parametri, il provider esegue il lavoro sulla GPU, e un'immagine o un task viene restituito. Quel modello girava su hardware consumer di fascia alta e produceva immagini da 512×512 pixel in pochi secondi, addestrato su LAION-5B, un dataset di circa 5.85 miliardi di coppie immagine-testo con un sottoinsieme filtrato per l'estetica di circa 600 milioni. Stability AI ha dichiarato che più di 15,000 tester stavano generando circa 2 milioni di immagini al giorno durante l'accesso pubblico iniziale, il che è il segnale precoce più chiaro che l'accesso ospitato, non il software desktop, era la forma della domanda.
Le sezioni seguenti seguono l'ordine in cui una vera integrazione incontra questi problemi: campi di richiesta e oggetti di risposta per primi, poi stati dei task asincroni, test di selezione del modello, fedeltà e provenienza delle modifiche, latenza e tentativi, integrazione passo-passo, unità di fatturazione e una chiamata di test finale. I team che integrano le generazioni in una pipeline automatizzata di solito vogliono che l'intero ciclo sia dimostrato una volta, e questa guida dettagliata di un'API di immagini per flussi di lavoro di automazione mostra il ciclo completo dal trigger all'asset memorizzato.
Schemi di Richiesta e Campi di Risposta
La maggior parte delle prime integrazioni si interrompe nel corpo della richiesta, e raramente a causa del prompt. Costruisci i campi nell'ordine in cui vengono trasmessi e il debug sarà più breve.
- Identificatore del modello. Invialo per primo nel tuo ragionamento, perché decide quali dei campi rimanenti sono validi. Un prompt negativo o una maschera che un modello accetta sarà rifiutata dal successivo.
- Prompt e prompt negativo. Il prompt negativo è un campo supportato su alcune famiglie e ignorato su altre, quindi verifica piuttosto che supporre.
- Dimensione o rapporto d'aspetto. Esprimilo nel modo in cui il modello si aspetta, in pixel o in rapporti denominati. Convalidalo localmente prima dell'inferenza, perché una chiamata rifiutata costa un round trip mentre una generazione che fallisce tardi costa un timeout e uno slot in coda.
- Numero di output. Output multipli per chiamata sembrano efficienti finché non noti che la fatturazione di solito scala con il numero, non con la chiamata.
- Formato di output. PNG, JPEG o WebP cambiano il tuo lavoro di conversione a valle tanto quanto il tuo conteggio di byte.
- Seed. Includilo ogni volta che la riproducibilità è importante. Senza di esso, "eseguilo di nuovo" significa "tira di nuovo i dadi".
- Webhook URL. I lavori lunghi terminano dopo che la tua richiesta è stata restituita, e una callback è più economica di un ciclo di polling stretto.
- Chiave di idempotenza. La generazione è costosa, quindi un tentativo di creazione ripetuto senza una chiave diventa un secondo lavoro fatturato e un'immagine duplicata.
Convalida prima di spendere. Controlla prima il rapporto d'aspetto, l'identificatore del modello e i campi richiesti nel tuo codice. Un controllo locale dello schema cattura la classe di errore che altrimenti emerge come un 400 dopo un'attesa in coda, e mantiene il traffico malformato completamente lontano da un endpoint a consumo.
Il lato della risposta è dove i team perdono asset per i quali hanno già pagato. La documentazione dell'API di immagine di OpenAI mostra la forma su cui la maggior parte dei provider converge, un oggetto immagine con un payload base64, un URL ospitato e, dove supportato, un prompt rivisto. Normalizza ciò che il provider restituisce nel tuo schema stabile e conserva un blocco di metadati grezzi del provider per i controlli che il tuo schema non modella ancora.
| Campo | Contenuto | Nota di produzione |
|---|---|---|
| Asset URL | link al file generato | di breve durata e con controllo degli accessi, quindi scarica prima che scada |
| b64_json | byte immagine codificati in base64 | va bene per risposte sincrone piccole, pesante sulla memoria per payload grandi |
| revised_prompt | il prompt come riformulato dal modello | memorizzalo, perché spiega output che non ti aspettavi |
| Identificatore del modello | il modello e la versione che hanno prodotto l'output | richiesto per audit e riproduzione |
| Dimensioni e formato | larghezza, altezza e tipo MIME | conferma rispetto al rapporto d'aspetto richiesto |
| Checksum | hash di integrità del file | verifica dopo il download e dopo qualsiasi conversione di formato |
Tratta base64 come un dettaglio di trasporto, non una strategia di archiviazione. Un'immagine codificata gonfia il payload di circa un terzo e rimane in memoria mentre la tua app analizza il JSON. Per i media di produzione, scrivi i byte decodificati nello storage oggetti e consegna al tuo front end un URL di recupero firmato invece. Aggiungi il tipo MIME e un checksum al record mentre ci sei, così un download corrotto viene intercettato dalla tua pipeline piuttosto che da un utente.
La regola che farei rispettare nella code review: ogni asset memorizzato porta l'identificatore del modello, il seed, il prompt effettivo e il timestamp della richiesta nei suoi metadati. Senza questi quattro, un ticket di supporto su "un'immagine strana del mese scorso" non ha risposta.
Questa abitudine ripaga la prima volta che una versione del modello cambia e l'output deriva. I metadati memorizzati trasformano un reclamo vago in un confronto che puoi eseguire.
Lavori Asincroni, Stati dei Task e Recupero dei Risultati
Il lavoro di immagini e video non viene restituito all'interno di un completamento di chat. Crea un lavoro, conserva l'identificatore, quindi osservalo progredire.
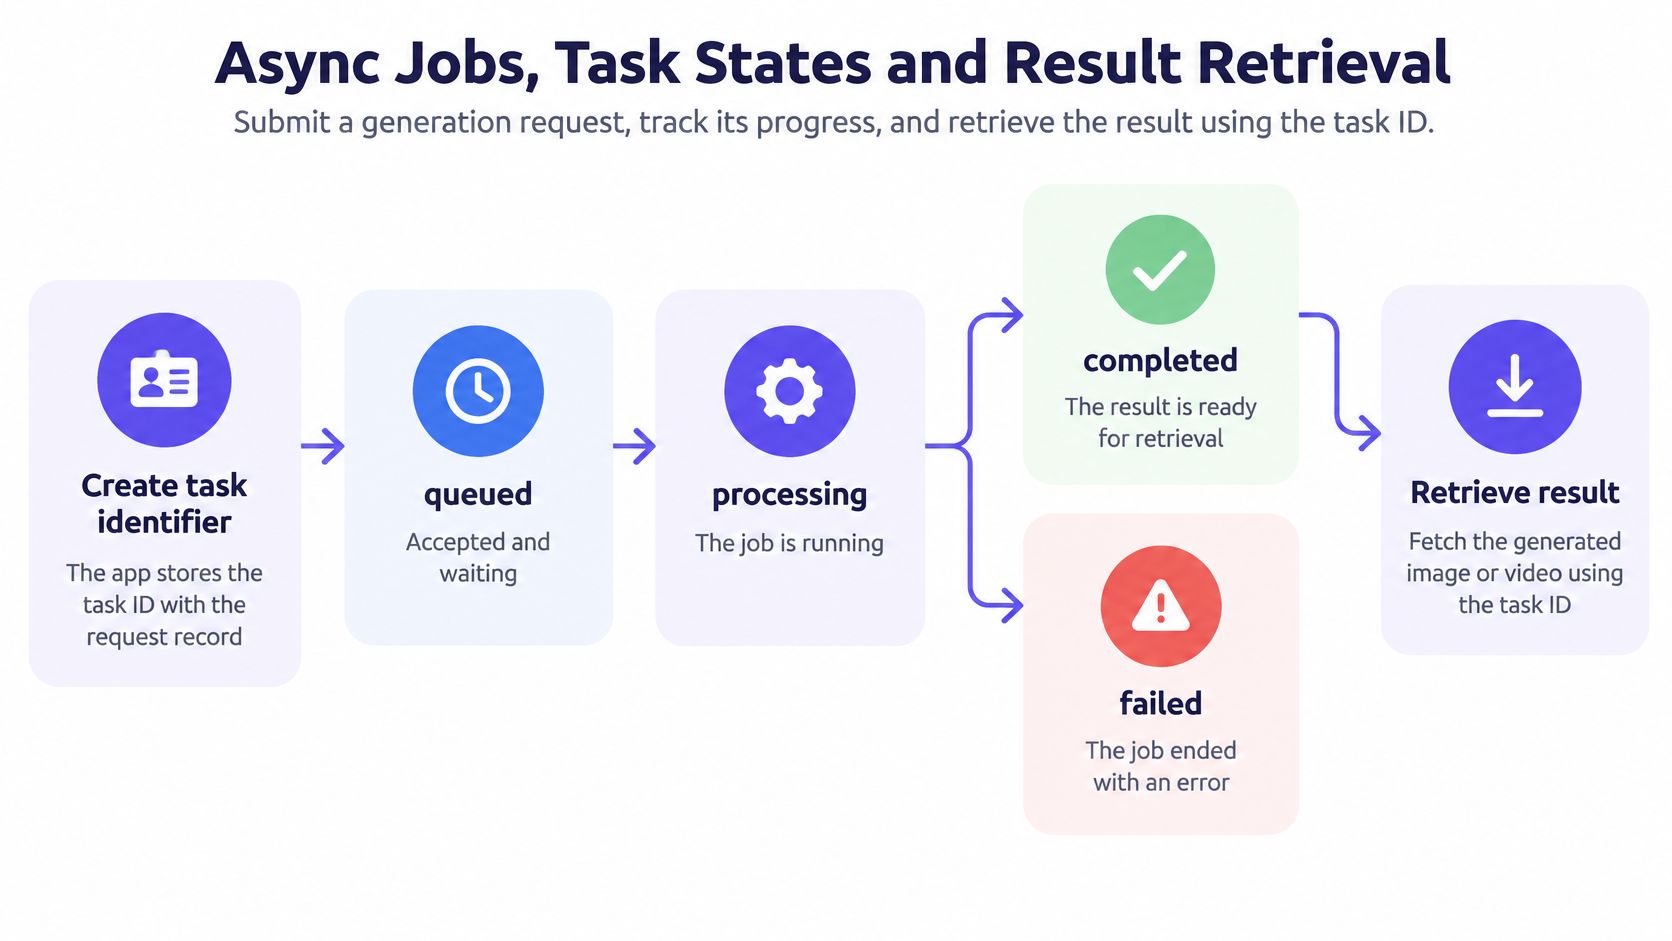
La chiamata di creazione restituisce un identificatore di task, e la tua applicazione lo scrive nello stesso record di richiesta che contiene il prompt e il modello. Da lì il lavoro riporta uno dei cinque stati, e ognuno richiede qualcosa di diverso al tuo codice.
| Stato | Significato | Cosa fa l'app |
|---|---|---|
| queued | accettato e in attesa di capacità | conserva l'ID del task ed esegui il polling secondo una pianificazione |
| running | generazione in corso | attendi e applica un timeout dimensionato per la modalità |
| succeeded | output è pronto | scarica e archivia l'asset immediatamente |
| failed | generazione non completata | leggi la categoria di errore prima di qualsiasi tentativo |
| expired | output non più recuperabile | rigenera e non trattarlo come un risultato mancante |
Lo stato expired coglie di sorpresa i team perché sembra un bug nel loro sistema. Non lo è. I provider mantengono i file dei risultati per una finestra temporale limitata, e quella finestra è breve. Su UberLLM, i link delle immagini rimangono attivi per circa 15 minuti, e i file dei risultati di video e musica sono conservati per circa 3 ore dopo il completamento del lavoro. Un ciclo di polling che controlla ogni dieci minuti e agisce al ciclo di deploy successivo mancherà completamente i link delle immagini.
Il recupero si basa su due meccanismi, e i sistemi maturi li usano entrambi. Il polling copre le consegne che un webhook ha perso, ed è l'unica opzione quando il tuo servizio non può esporre un endpoint pubblico. I webhook riducono le richieste sprecate dicendoti esattamente quando lo stato è cambiato, il che è importante quando un lavoro richiede un minuto anziché un secondo. I compromessi tra webhook e polling si riducono alla gestione dei fallimenti: i webhook falliscono quando il tuo ricevitore è inattivo, e il polling fallisce in modo costoso quando il tuo intervallo è troppo stretto.
Gli intervalli di polling dovrebbero seguire la modalità, non la codebase. Un singolo ciclo fisso che funziona per un lavoro di immagine di 4 secondi spreca decine di chiamate su un lavoro video che dura un minuto o più.
Le risposte testuali vengono trasmesse in streaming token per token, mentre i lavori di immagini e video ti consegnano un task che esegui il polling o che un webhook segnala come pronto. Questa differenza è architetturale, non cosmetica: la richiesta che ritorna istantaneamente possiede ancora un lavoro che non è terminato, e qualcuno deve ricordarsene. Registra i tempi di transizione dello stato così come lo stato finale, perché il divario tra queued e running è dove i problemi di capacità si manifestano prima che raggiungano gli utenti.
Criteri di selezione del modello e come testarli
Le classifiche pubbliche valutano i modelli su prompt che nessuno nel tuo prodotto invierà mai. Misurano la qualità dei campioni in condizioni che non controlli, e non dicono nulla sulle code di latency, sulla coerenza dei rifiuti o su come gli output si modificano tra le build. Un set di test costruito dalle tue categorie di immagini ti dice di più in un pomeriggio di quanto una classifica ti dica in un mese, e sopravvive al prossimo rilascio del modello.
La valutazione deve essere un comportamento misurabile, non una questione di gusto. I programmi di valutazione formale trattano la generazione di immagini allo stesso modo in cui un test di carico tratta il throughput: protocolli definiti, input fissi e output con punteggio anziché impressioni del revisore. Una produzione API dovrebbe registrare le stesse dimensioni riproducibili ad ogni chiamata: categoria del prompt, modello e versione, seed se disponibile, risoluzione, latency, modalità di errore e risultato di sicurezza. Registra la latency per richiesta in modo che la coda rimanga visibile, perché una mediana sana può nascondere lavori che si bloccano abbastanza a lungo da raggiungere il tuo timeout.
| Criterio | Come misurare | Segnale di superamento |
|---|---|---|
| Aderenza al prompt | revisione con punteggio di un set di prompt fisso per categoria | gli oggetti, i conteggi e i colori richiesti appaiono nella maggior parte degli output |
| Qualità percettiva | revisione cieca affiancata dal team | i revisori scelgono gli output senza sapere quale modello li ha creati |
| Rendering del testo | prompt che richiedono parole o etichette esatte | le parole sono scritte correttamente nella maggior parte dei campioni |
| Coerenza dell'identità | lo stesso soggetto attraverso diverse generazioni | il volto, il prodotto o il personaggio rimangono riconoscibili |
| Comportamento di rifiuto | prompt che dovrebbero essere rifiutati | i rifiuti sono coerenti e rientrano in categorie chiare |
| Riproducibilità | chiamate ripetute con lo stesso seed e versione del modello | gli output rimangono simili quando seed e versione corrispondono |
Valuta ogni riga separatamente. Un numero aggregato nasconde un modello che rende perfettamente le etichette dei prodotti e rifiuta ogni prompt contenente un bambino, o uno con bellissimi ritratti e testo che sembra un CAPTCHA. Il fallimento che fa male è sempre specifico per categoria, e farne una media in un unico punteggio è il modo in cui raggiunge la produzione inosservato.
Il routing aggiunge un problema di governance che il test del modello non rileverà. Quando un marketplace o un livello di failover scambia i provider, la sostituzione deve portare garanzie di moderazione equivalenti, oppure il risultato deve essere esplicitamente contrassegnato come avente caratteristiche di garanzia diverse. Il rilassamento silenzioso dei controlli di sicurezza è il peggior comportamento di failover possibile: nulla va in errore, e l'output arriva semplicemente con una revisione più debole alle spalle. Mantieni le decisioni di moderazione e le versioni del modello nel registro di audit, ed esponi le categorie di errore su cui la tua applicazione può ramificarsi.
Dimensione del campione che funziona in pratica: alcune decine di prompt per categoria per una prima passata, con i prompt e gli output esatti salvati in un repo. Riesegui l'intero set ogni volta che una stringa di versione del modello cambia, non ogni volta che qualcuno si lamenta.
Quest'ultimo punto è quello che i team saltano. Un identificatore di modello può puntare a una nuova build senza alcun cambiamento da parte tua, quindi il set di test non è un artefatto di lancio, è una regression suite che viene eseguita ad ogni ciclo di rilascio. Quando i risultati vanno agli stakeholder al di fuori dell'ingegneria, una spiegazione in linguaggio semplice di ciò che fa un singolo modello, spiegata da ImagesArt AI, fornisce a quella conversazione una base comune prima che inizi il dibattito sul punteggio.
Verifica della fedeltà e della provenienza delle modifiche prima del lancio
Una modifica esteticamente gradevole non è una modifica riuscita. La modifica deve essere valutata due volte: una per verificare se la modifica richiesta è avvenuta e una per verificare se tutto il resto è rimasto al suo posto. Spedire basandosi solo sul primo punteggio è il modo in cui si ottiene una foto del prodotto in cui il modello ha ridisegnato il logo.
La ricerca supporta questa distinzione. Il paper HQ-Edit introduce Allineamento e Coerenza come metriche separate e riporta che il fine-tuning ha migliorato l'Allineamento di 12.3 punti e la Coerenza di 5.64 punti in un sistema valutato. Due numeri che si muovono indipendentemente è l'intero argomento: un output può seguire l'istruzione e comunque distruggere le parti che dovevano essere preservate, o preservare tutto e ignorare l'istruzione.
Il test di accettazione che eseguirei prima del lancio:
- Scegliere da 20 a 30 immagini sorgente che includano volti, testo stampato, loghi e sfondi complessi. Le sole foto di prodotti ritagliate supereranno un modello che si scompone su un volto.
- Scrivere un'istruzione per immagine e registrare la modifica attesa nella stessa riga. Istruzioni ambigue producono discussioni sui risultati piuttosto che scoperte.
- Mascherare la regione modificata e confrontare il resto con la sorgente. I pixel al di fuori della maschera sono il tuo punteggio di preservazione, e un confronto numerico risolve ciò che l'osservazione a occhio nudo non può.
- Valutare allineamento e preservazione in colonne separate, quindi esaminare i casi in cui non concordano. Questi sono i prompt che necessitano di essere riformulati o il modello che necessita di essere sostituito.
- Sottoporre ogni output a ridimensionamento e conversione di formato, quindi confermare che filigrane o credenziali di contenuto siano sopravvissute. La provenienza che muore nella tua pipeline CDN è una provenienza che non hai mai avuto.
- Confermare la politica sui contenuti del provider e qualsiasi obbligo di divulgazione che si applica nei mercati in cui spedisci. La politica varia a seconda del provider, e una richiesta instradata può ricadere sotto una politica diversa.
- Registrare la catena di custodia dal file sorgente all'asset consegnato, inclusa la versione del modello che lo ha gestito.
Il quinto passo è quello che i team scoprono tardi. Le credenziali e le filigrane invisibili sono prove sull'origine, non prove che un evento raffigurato sia vero. L'affidabilità dipende da identità fidate, dal processo di firma e dal fatto che ogni passaggio a valle preservi i metadati, quindi ridimensionamento, ritaglio e ricodifica necessitano tutti di un controllo. Un segnale di provenienza migliora la tracciabilità, e non può stabilire l'autenticità fattuale o confermare che i diritti siano stati autorizzati.
La scomoda conclusione per chiunque stia costruendo una funzionalità di modifica: i metadati di provenienza rispondono a "da dove proviene questo," e non rispondono mai a "questa affermazione è accurata" o "abbiamo la licenza." Queste rimangono questioni legali ed editoriali.
Se la superficie di modifica è il prodotto, trattare la preservazione della regione come un requisito imprescindibile piuttosto che un punteggio di qualità. Una guida all'API di fotoritocco è un utile compagno per il lato endpoint e parametri, e questa guida di AskYourQA al testing AI aiuta a strutturare il punteggio in modo che allineamento e preservazione non si fondano in un'unica impressione.
Latenza, Errori e Comportamento di Retry in Produzione
La maggior parte dei confronti tra API di immagini classifica il prezzo per immagine e la qualità del campione, poi si ferma. Le code di latenza, i tassi di errore e il comportamento di recupero sono i numeri che decidono se la tua funzionalità sembra rotta, e sono i numeri che nessuno pubblica. Un benchmark di generazione di immagini afferma chiaramente che la latenza e l'uptime osservato sono riservati a una fase futura, mentre un test indipendente ha rilevato che i provider generalmente non pubblicano i dati effettivi di latenza e hanno dovuto misurare autonomamente i tempi di risposta, i tassi di errore, gli avvii a freddo e il throughput, come documentato da l'analisi di generazione di immagini di API Benchmarks.
Misura i percentili, non le medie. Tieni traccia di p50, p95 e p99 separatamente per le chiamate di immagini sincrone e asincrone, quindi aggiungi il tasso di timeout, la penalità di avvio a freddo, il tempo dalla creazione al risultato recuperabile e il tasso di output riuscito. Una singola media nasconde la coda che gli utenti sperimentano, ovvero i due secondi in cui la maggior parte delle richieste arriva e i quaranta in cui alcune non arrivano.
Le sorprese sui tempi di solito riguardano la modalità. Nel nostro test su 29 ottobre 2026, un clip Kling 3.0 di 5 secondi ha impiegato circa 80 secondi per essere generato. Non c'era nulla di sbagliato; il video costa semplicemente minuti dove le immagini costano secondi, e un timeout copiato dal percorso delle immagini annullerà i lavori che stavano progredendo normalmente.
| Sintomo | Causa probabile | Soluzione |
|---|---|---|
| I task rimangono in esecuzione oltre il timeout | provider lento o non disponibile | annulla, quindi riprova con la stessa idempotency key o reindirizza se disponibile |
| Immagini duplicate dopo un timeout di rete | chiamata di creazione riprovata senza una idempotency key | invia una idempotency key con ogni richiesta di creazione |
| risposte 429 durante i picchi | limite di velocità raggiunto | ritira esponenzialmente con jitter e metti in coda le richieste |
| risposte 503 | provider o rotta temporaneamente non disponibile | riprova più tardi con un limite, e passa a un altro solo se le garanzie di sicurezza sono valide |
| risposte 402 | controllo del saldo o del pagamento fallito | ricarica il saldo, quindi reinvia la stessa richiesta |
| risposte 404 | identificatore del modello o rotta non trovata | controlla l'identificatore rispetto al catalogo attuale |
| Il link dell'immagine non si carica più | l'URL firmato è scaduto | scarica al successo e memorizza il file nel tuo storage |
Riprova solo ciò che è riprovabile. Un 429 o un 503 è transitorio e merita un backoff esponenziale con jitter e un limite massimo. Un 402 o un 404 fallirà identicamente per sempre, quindi correggi prima il saldo o l'identificatore del modello. La nostra API rifiuta le chiamate con 402, 404, 429 e 503, e la categoria è il segnale, non solo lo stato HTTP.
La lettura controcorrente sui costi: l'API per immagine più economica è spesso la più costosa in produzione. I tentativi, le generazioni fallite e la latenza di coda imprevedibile spingono il lavoro nella tua applicazione e gli utenti fuori dal tuo funnel.
L'affidabilità è già un criterio di acquisto, per 37% delle organizzazioni, dietro l'ottimizzazione dei costi al 58%, la disponibilità del modello al 49% e la velocità al 41%, secondo la stessa analisi di benchmarking. E il compromesso del marketplace è reale: il routing tra provider riduce le interruzioni, ma aggiunge anche varianza nel tempo di coda, nelle prestazioni regionali e nel ritardo del filtro di sicurezza. Ogni richiesta reindirizzata dovrebbe essere misurata come una propria rotta, con i propri percentili, altrimenti la dashboard aggregata nasconderà esattamente il percorso che sta fallendo.
Come Integrare un'API per Immagini Passo Dopo Passo
Un'integrazione in produzione è un breve elenco di decisioni, e la maggior parte di esse riguarda i record piuttosto che le richieste. Ecco la sequenza che resiste al contatto con il traffico reale.
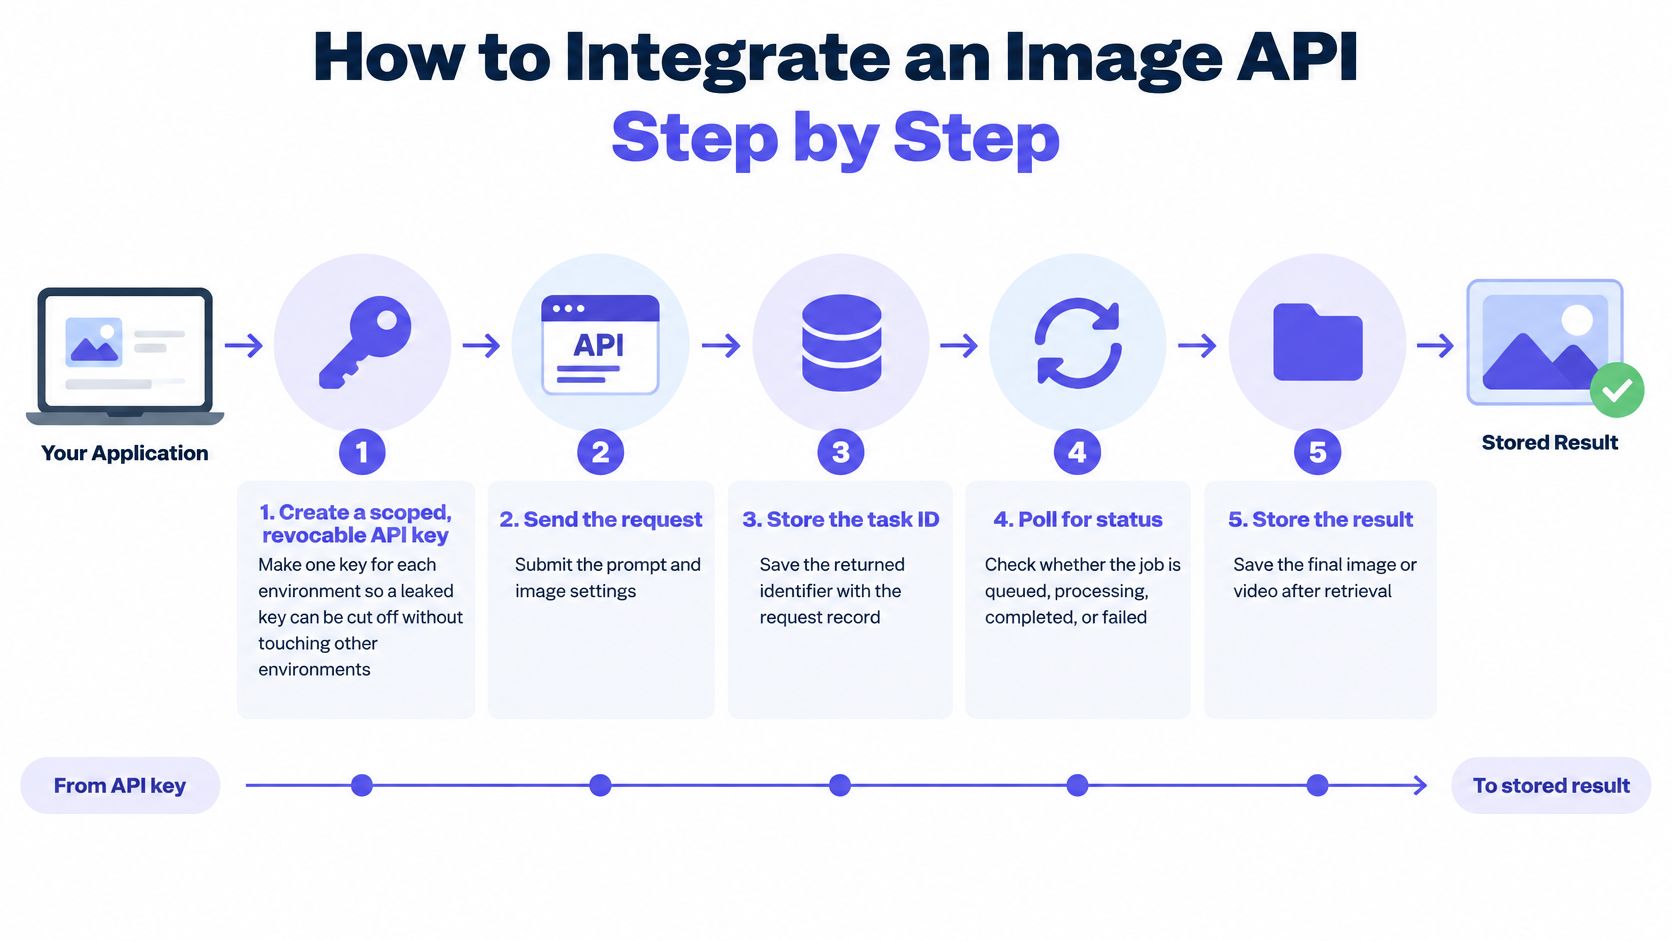
- Crea una API key con ambito limitato e revocabile per ogni ambiente. Chiavi separate significano che una credenziale di staging trapelata può essere revocata senza intaccare il traffico di produzione.
- Punta il tuo client esistente al nuovo base URL. La base compatibile con OpenAI è il base URL compatibile con OpenAI di UberLLM, e poiché la piattaforma accetta entrambi i formati wire di OpenAI e Anthropic, i client esistenti funzionano una volta che il base URL e le credenziali cambiano. Conferma quali endpoint di immagine da cui dipendi sono supportati prima di passare.
- Copia l'identifier del modello come stringa completa dal catalogo attuale. Cambiare modello modifica quindi esattamente un valore, il che è una diff di una riga invece di un refactor. Gli id nativi del provider funzionano allo stesso modo, come
fal-ai/kling-video/v3/standard/text-to-video. - Valida localmente le dimensioni e l'aspect ratio, allega una idempotency key, quindi invia la chiamata di creazione. I controlli economici appartengono al tuo lato della rete.
- Memorizza l'identifier del task con il record della richiesta, quindi effettua il polling o registra un webhook. Se il processo si interrompe tra la creazione e la memorizzazione, hai pagato per un output che nessuno può trovare.
- In caso di successo, scarica l'asset, verifica il checksum e salvalo nel tuo storage. Aspettare la prossima richiesta dell'utente per recuperare il file è il modo in cui i link che scadono si trasformano in ticket di supporto.
- Logga l'identifier del modello, lo state, la duration e la error category per ogni job. Questi quattro campi rispondono alla maggior parte delle domande di produzione senza una sessione di debugging.
- Esercita i percorsi di fallimento prima del lancio, inclusi un 429, un request timeout e un link scaduto. Il codice di retry non testato di solito raddoppia il conteggio delle immagini duplicate invece di ridurlo.
Una breve dimostrazione vale più dell'elenco dei campi per la prima build, specialmente per quanto riguarda il retrieval:
Ecco come appare un'integrazione funzionante alla fine di questo processo: ogni job ha uno state, ogni job di successo ha un asset nel tuo bucket, e ogni asset ha una versione del modello loggata accanto. Questo è l'intero standard. È anche la differenza tra una demo che ha impressionato qualcuno a marzo e una feature che puoi ancora debuggare a novembre.
Unità di Fatturazione e Come Confrontare i Costi Reali
Due API possono entrambe dichiarare "per immagine" e comunque fatturarti in modo diverso, perché l'unità, la dipendenza dalle dimensioni e la politica di gestione dei fallimenti cambiano tutte l'aritmetica. Confronta prima l'unità, poi calcola il costo per output utilizzabile.
| Modalità | Unità di fatturazione usuale | Cosa verificare |
|---|---|---|
| Generazione di testo | token di input e output | input e output sono prezzati separatamente |
| Generazione di immagini | per immagine o per megapixel | modello e dimensione dell'output cambiano il costo unitario |
| Modifica di immagini | per modifica o per immagine di output | se l'immagine sorgente comporta un costo aggiuntivo |
| Generazione di video | per clip o per secondo, a seconda del provider | fatturato al prezzo finale una volta completata la generazione |
| Musica e parlato | per traccia, per minuto o per carattere | l'unità che ogni modello utilizza effettivamente |
| Lavori falliti | addebitati per tentativo, o non addebitati affatto | se le generazioni fallite compaiono in fattura |
La tariffazione per megapixel penalizza gli output di grandi dimensioni in un modo che la tariffazione per immagine non fa. Un modello che sembra economico a 1024×1024 può costare diverse volte di più a risoluzione di stampa, quindi confronta alla dimensione che il tuo prodotto renderizza piuttosto che alla dimensione nello screenshot di marketing.
Il video necessita di una sua riga nella previsione. Una clip fatturata al suo prezzo finale una volta completata la generazione è più facile da prevedere rispetto a una misurata mentre è in esecuzione, perché stai prevedendo output finiti piuttosto che incertezze di tempo reale. Le modifiche sono la riga insidiosa: verifica se l'immagine sorgente viene addebitata come input, poiché un flusso di lavoro di ritocco che invia una sorgente da 4 MB a ogni chiamata può spostare il costo unitario ben oltre il prezzo di modifica pubblicizzato.
Le generazioni fallite sono la voce che alla fine decide tra due fornitori. Prendi 1,000 lavori di immagine con un tasso di fallimento del 5%. Se i lavori falliti vengono fatturati, paghi per 1,000 lavori per ricevere 950 immagini utilizzabili, il che è circa 5% in più per immagine utilizzabile di quanto suggerisce l'etichetta. Se i lavori falliti non vengono fatturati, paghi per 950. Stesso prezzo di listino, prezzo effettivo diverso.
La formula che userei per una stima mensile: volume atteso × prezzo unitario × fattore di riprova, più un buffer per modifiche e video. Il fattore di riprova è il numero che separa una previsione da un desiderio.
Poi confronta i prezzi unitari rispetto al tuo test di accettazione piuttosto che alla galleria di esempi del fornitore. Se vuoi la logica sottostante della tariffazione di token, immagini e clip in un unico posto, questa analisi dei modelli di prezzo dell'IA spiega come viene misurata ogni unità.
Esegui una Chiamata di Test Prima di Scegliere il Tuo Modello
Una chiamata di test dovrebbe rispondere a più di “Questa immagine ha un bell'aspetto?” Verifica se il modello soddisfa i tuoi standard di qualità, come gestisce le modifiche e come si comporta la sua risposta sotto il carico previsto. Un'immagine di esempio forte non può dirti come l'API si comporterà in produzione.
Scegli un candidato per il text-to-image e uno che supporti la modifica. Mantieni il set di prompt fisso tra i candidati in modo da poter confrontare gli output sugli stessi compiti. Con UberLLM, puoi cambiare modello modificando l'identificatore del modello pur mantenendo la API key e l'endpoint.
Testa in ordine: prima, valuta gli output rispetto ai tuoi criteri di selezione; poi, esegui il test di accettazione delle modifiche se la tua funzionalità modifica le immagini; quindi misura la latenza p50 e p95 alla concorrenza prevista. Termina calcolando il costo per output utilizzabile, inclusi i tentativi. Un modello che non soddisfa gli standard di qualità non ha bisogno di un test di carico.
Salva prompt, output e log delle richieste nel tuo repository. Quando cambi un identificatore o una versione del modello, riesegui lo stesso set e confronta i risultati. Per le modifiche, ispeziona se il risultato preserva i dettagli della fonte di cui la tua applicazione ha bisogno; un'immagine visivamente plausibile può comunque alterare l'identità o altre caratteristiche importanti.
Via libera o stop: Promuovi un modello solo se supera i test di qualità, modifica e carico al volume previsto. Distribuisci dietro un feature flag e tieni un secondo candidato disponibile per il failover. Se fallisce, testa il prossimo candidato contro lo stesso set.
Il prezzo rientra nella decisione, ma non dovrebbe guidarla. UberLLM elenca la generazione di immagini Nano Banana 2 a $0.015 per immagine, rispetto a un prezzo di listino di $0.10 per immagine. Per i test video, UberLLM raccomanda Kling 3.0 Standard come punto di partenza per il text-to-video o l'image-to-video. Le richieste di immagini e video restituiscono un task che puoi interrogare (poll) o tracciare tramite un webhook, quindi includi il tempo di completamento e il recupero del risultato nel tuo test.
UberLLM fornisce modelli di testo, immagine, video, musica e voce tramite interfacce compatibili con OpenAI e Anthropic. Usa il suo playground per confrontare gli output delle immagini, quindi esegui gli stessi prompt di test tramite il client API della tua applicazione. Valuta insieme qualità, fedeltà delle modifiche, latenza e costo per risultato utilizzabile prima di scegliere un modello.