Como Escolher e Integrar uma API de Geração de Imagens
Compare capacidades de APIs de geração de imagens, campos de requisição, resultados assíncronos, testes de modelo, tratamento de erros e faturamento, com passos para integração em produção.
Mais de 15 bilhão de imagens foram criadas com algoritmos de texto para imagem até agosto de 2023,, uma média de aproximadamente 34 milhões por dia desde o lançamento do DALL-E 2, de acordo com uma análise da Everypixel sobre estatísticas de imagens de IA. A mesma análise atribui cerca de 12.6 bilhões delas, aproximadamente 80%, a modelos, serviços e aplicativos baseados em Stable Diffusion.
Nesse volume, a geração de imagens deixa de ser uma demonstração criativa e se torna infraestrutura. As perguntas que decidem se um produto é lançado deixam de ser sobre qual modelo pinta as imagens mais bonitas e passam a ser sobre contratos de solicitação, estados de trabalho (job states), comportamento de timeout e se uma geração falha ainda aparece na sua fatura.
Este é um guia para desenvolvedores sobre a camada de API de geração de imagens. Ele aborda como as solicitações são estruturadas, como as tarefas se movem através de um ciclo de vida, como testar um modelo em vez de confiar em um ranking (leaderboard) e onde os custos se escondem. O preço por imagem é o número mais fácil de comparar e o menos útil por si só.
Sumário
- Recursos da API de Geração de Imagens em Resumo
- Padrões de Requisição e Campos de Resposta
- Tarefas Assíncronas, Estados da Tarefa e Recuperação de Resultados
- Critérios de Seleção de Modelo e Como Testá-los
- Verificando a Fidelidade da Edição e Proveniência Antes do Lançamento
- Latência, Erros e Comportamento de Retentativa em Produção
- Como Integrar uma API de Imagem Passo a Passo
- Unidades de Cobrança e Como Comparar Custos Reais
- Faça uma Chamada de Teste Antes de Escolher Seu Modelo
Visão Geral dos Recursos da API de Geração de Imagens
| Recurso | Entrada | Saída | Padrão de recuperação |
|---|---|---|---|
| Geração de texto | mensagens e parâmetros | texto em streaming | resposta em streaming |
| Texto para imagem | prompt, tamanho, identificador do modelo | uma ou mais imagens | tarefa, por polling ou webhook |
| Edição de imagem | imagem de origem, instrução, máscara opcional onde suportado | imagem editada | tarefa, por polling ou webhook |
| Texto para vídeo | prompt, duração, resolução | arquivo de vídeo | tarefa, por polling ou webhook |
| Imagem para vídeo | imagem de origem, prompt, duração | arquivo de vídeo | tarefa, por polling ou webhook |
| Geração de música | prompt, estilo, duração | arquivo de áudio | tarefa, por polling ou webhook |
| Síntese de fala | texto, voz | arquivo de áudio | áudio em streaming ou um arquivo retornado |
Um único endpoint e uma única API key podem cobrir várias famílias de modelos de uma vez, porque o identificador do modelo é o que seleciona a família e a versão. Essa conveniência tem um porém. Cada família aceita um conjunto de parâmetros diferente, então um corpo que é válido para um modelo pode falhar em outro, e tamanhos, máscaras, suporte a seed e limites de múltiplas saídas diferem entre eles.
Uma API de geração de imagens é um serviço de inferência hospedado com três partes: um contrato de requisição que transforma um prompt e configurações em uma chamada assinada, um objeto de resultado que carrega a imagem mais seus metadados, e um ciclo de vida de trabalho para tarefas que duram mais que uma única resposta HTTP. Cada parte exige suas próprias decisões de design, e cada uma falha de maneira diferente.
O padrão é mais recente do que parece. O lançamento público do Stable Diffusion em 22 de agosto de 2022 estabeleceu o formato de serviço que a maioria dos provedores ainda usa, conforme TechCrunch relatou no lançamento: um aplicativo envia um prompt e parâmetros, o provedor executa o trabalho da GPU, e uma imagem ou uma tarefa é retornada. Esse modelo rodava em hardware de consumo de ponta e produzia imagens de 512×512 pixels em poucos segundos, treinado no LAION-5B, um conjunto de dados de aproximadamente 5.85 bilhões de pares imagem-texto com um subconjunto filtrado por estética de cerca de 600 milhões. A Stability AI afirmou que mais de 15,000 testadores estavam gerando cerca de 2 milhões de imagens por dia durante o acesso público inicial, o que é o sinal inicial mais claro de que o acesso hospedado, e não o software de desktop, era o formato da demanda.
As seções a seguir acompanham a ordem em que uma integração real encontra esses problemas: campos de requisição e objetos de resposta primeiro, depois estados de tarefas assíncronas, testes de seleção de modelo, fidelidade e proveniência de edição, latência e retentativas, integração passo a passo, unidades de faturamento e uma chamada de teste final. Equipes que integram gerações em um pipeline automatizado geralmente querem que o ciclo completo seja demonstrado uma vez, e este passo a passo de uma API de imagem para fluxos de trabalho de automação mostra o ciclo completo, do gatilho ao ativo armazenado.
Padrões de Requisição e Campos de Resposta
A maioria das primeiras integrações falha no corpo da requisição, e raramente por causa do prompt. Construa os campos na ordem em que são transmitidos e a depuração será mais curta.
- Identificador do modelo. Envie-o primeiro em sua própria lógica, porque ele decide quais dos campos restantes são válidos. Um prompt negativo ou uma máscara que um modelo aceita será rejeitado pelo próximo.
- Prompt e prompt negativo. O prompt negativo é um campo suportado em algumas famílias e ignorado em outras, então verifique em vez de assumir.
- Tamanho ou proporção. Expresse-o da forma que o modelo espera, em pixels ou em proporções nomeadas. Valide-o localmente antes da inferência, porque uma chamada rejeitada custa uma ida e volta, enquanto uma geração que falha tardiamente custa um timeout e um slot na fila.
- Contagem de saída. Múltiplas saídas por chamada parecem eficientes até você notar que a cobrança geralmente escala com a contagem, não com a chamada.
- Formato de saída. PNG, JPEG ou WebP muda seu trabalho de conversão posterior tanto quanto sua contagem de bytes.
- Seed. Inclua-o sempre que a reprodutibilidade for importante. Sem ele, "execute isso novamente" significa "jogue os dados novamente".
- Webhook URL. Tarefas longas terminam depois que sua requisição retorna, e um callback é mais barato do que um loop de polling intenso.
- Idempotency key. A geração é cara, então uma criação retentada sem uma chave se torna um segundo trabalho cobrado e uma imagem duplicada.
Valide antes de gastar. Verifique a proporção, o identificador do modelo e os campos obrigatórios em seu próprio código primeiro. Uma verificação de esquema local detecta a classe de erro que, de outra forma, aparece como um 400 após uma espera na fila, e mantém o tráfego malformado completamente fora de um endpoint medido.
O lado da resposta é onde as equipes perdem ativos pelos quais já pagaram. A referência da API de imagem da OpenAI mostra o formato em que a maioria dos provedores converge: um objeto de imagem com um payload base64, uma URL hospedada e, onde suportado, um prompt revisado. Normalize o que quer que o provedor retorne em seu próprio esquema estável e mantenha um bloco de metadados brutos do provedor para controles que seu esquema ainda não modela.
| Campo | O que ele contém | Nota de produção |
|---|---|---|
| Asset URL | link para o arquivo gerado | de curta duração e com controle de acesso, então baixe antes que expire |
| b64_json | bytes de imagem codificados em base64 | bom para pequenas respostas síncronas, pesado em memória para grandes payloads |
| revised_prompt | o prompt como o modelo o reformulou | armazene-o, porque ele explica saídas que você não esperava |
| Identificador do modelo | o modelo e a versão que produziram a saída | necessário para auditoria e reprodução |
| Dimensões e formato | largura, altura e tipo MIME | confirme em relação à proporção solicitada |
| Checksum | hash de integridade do arquivo | verifique após o download e após qualquer conversão de formato |
Trate base64 como um detalhe de transporte, não uma estratégia de armazenamento. Uma imagem codificada infla o payload em aproximadamente um terço e permanece na memória enquanto seu aplicativo analisa JSON. Para mídia de produção, escreva os bytes decodificados para o armazenamento de objetos e entregue ao seu front end uma URL de recuperação assinada. Adicione o tipo MIME e um checksum ao registro enquanto estiver lá, para que um download corrompido seja detectado pelo seu pipeline em vez de por um usuário.
A regra que eu aplicaria na revisão de código: todo ativo armazenado carrega o identificador do modelo, o seed, o prompt efetivo e o timestamp da requisição em seus metadados. Sem esses quatro, um ticket de suporte sobre "uma imagem estranha do mês passado" não tem resposta.
Esse hábito compensa na primeira vez que uma versão de modelo muda sob você e a saída se desvia. Os metadados armazenados transformam uma reclamação vaga em uma comparação que você pode executar.
Trabalhos Assíncronos, Estados da Tarefa e Recuperação de Resultados
Trabalhos de imagem e vídeo não retornam dentro de uma conclusão de chat. Crie um trabalho, guarde o identificador e, em seguida, observe seu progresso.
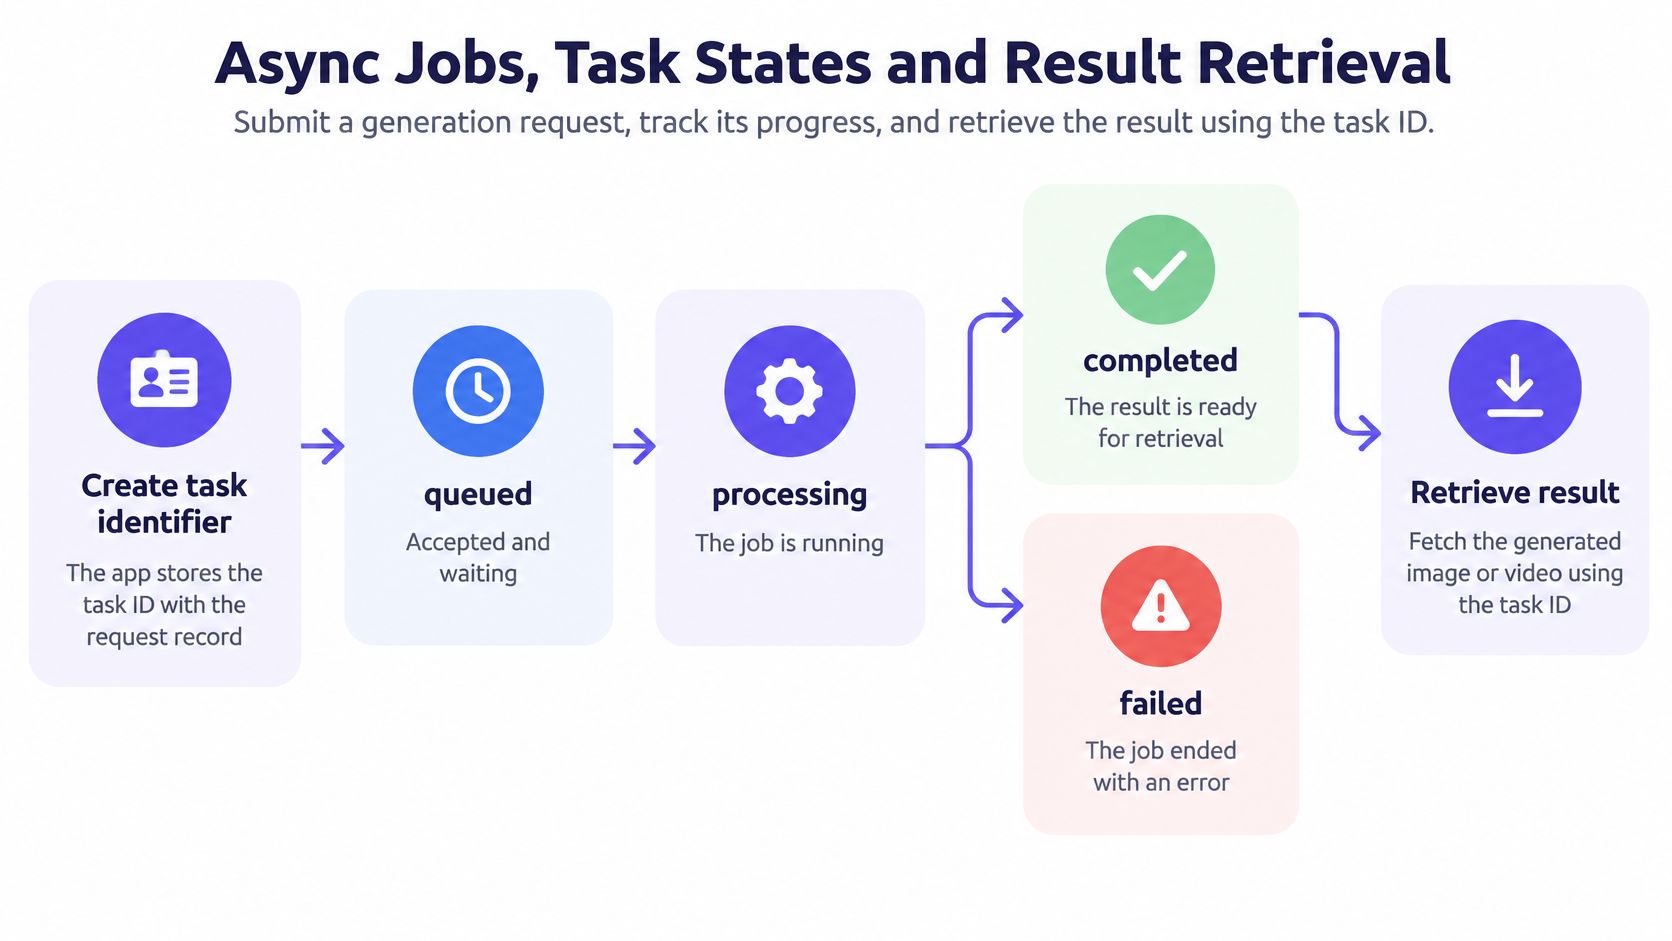
A chamada de criação retorna um identificador de tarefa, e sua aplicação o grava no mesmo registro de requisição que contém o prompt e o modelo. A partir daí, o trabalho reporta um de cinco estados, e cada um exige algo diferente do seu código.
| Estado | Significado | O que o app faz |
|---|---|---|
| em fila | aceito e aguardando capacidade | guarde o ID da tarefa e faça polling em um cronograma |
| em execução | geração em andamento | aguarde e aplique um timeout dimensionado para a modalidade |
| bem-sucedido | saída está pronta | baixe e armazene o ativo imediatamente |
| falhou | geração não foi concluída | leia a categoria do erro antes de qualquer nova tentativa |
| expirado | saída não é mais recuperável | regenere e não trate como um resultado ausente |
O estado expirado pega as equipes de surpresa porque parece um bug em seu próprio sistema. Não é. Provedores mantêm arquivos de resultado por uma janela limitada, e essa janela é curta. No UberLLM, links de imagem permanecem ativos por cerca de 15 minutos, e arquivos de resultado de vídeo e música são mantidos por cerca de 3 horas após a conclusão do trabalho. Um loop de polling que verifica a cada dez minutos e age no próximo ciclo de deploy perderá os links de imagem completamente.
A recuperação funciona com dois mecanismos, e sistemas maduros usam ambos. Polling cobre as entregas que um webhook perdeu, e é a única opção quando seu serviço não pode expor um endpoint público. Webhooks cortam requisições desperdiçadas informando exatamente quando o estado mudou, o que é importante quando um trabalho leva um minuto em vez de um segundo. As vantagens e desvantagens entre webhooks e polling se resumem ao tratamento de falhas: webhooks falham quando seu receptor está inativo, e polling falha de forma cara quando seu intervalo é muito apertado.
Intervalos de polling devem seguir a modalidade, não a base de código. Um único loop fixo que funciona para um trabalho de imagem de 4 segundos desperdiça dezenas de chamadas em um trabalho de vídeo que dura um minuto ou mais.
Respostas de texto são transmitidas token por token, enquanto trabalhos de imagem e vídeo entregam uma tarefa que você faz polling ou um webhook reporta como pronta. Essa diferença é arquitetônica, não cosmética: a requisição que retorna instantaneamente ainda é responsável por um trabalho que não foi concluído, e alguém precisa se lembrar disso. Registre os tempos de transição de estado, bem como o estado final, porque a lacuna entre 'em fila' e 'em execução' é onde os problemas de capacidade aparecem antes de chegarem aos usuários.
Critérios de Seleção de Modelos e Como Testá-los
Classificações públicas avaliam modelos com prompts que ninguém no seu produto jamais enviará. Elas medem a qualidade da amostra sob condições que você não controla, e não dizem nada sobre caudas de latência, consistência de recusa ou como as saídas variam entre as builds. Um conjunto de testes construído a partir das suas próprias categorias de imagem lhe diz mais em uma tarde do que um placar lhe diz em um mês, e sobrevive ao próximo lançamento do modelo.
A avaliação precisa ser um comportamento mensurável, não uma questão de gosto. Programas de avaliação formais tratam a geração de imagens da mesma forma que um teste de carga trata o throughput: protocolos definidos, entradas fixas e saídas pontuadas em vez de impressões de revisores. Uma API de produção deve registrar as mesmas dimensões reproduzíveis em cada chamada: categoria do prompt, modelo e versão, seed quando disponível, resolução, latência, modo de falha e resultado de segurança. Registre a latência por requisição para que a cauda permaneça visível, porque uma mediana saudável pode estar sobreposta a trabalhos que demoram tempo suficiente para atingir seu timeout.
| Critério | Como medir | Sinal de aprovação |
|---|---|---|
| Aderência ao prompt | revisão pontuada de um conjunto fixo de prompts por categoria | objetos, contagens e cores exigidos aparecem na maioria das saídas |
| Qualidade perceptual | revisão cega lado a lado pela equipe | revisores escolhem as saídas sem saber qual modelo as criou |
| Renderização de texto | prompts que exigem palavras ou rótulos exatos | palavras são escritas corretamente na maioria das amostras |
| Consistência de identidade | o mesmo assunto em várias gerações | o rosto, produto ou personagem permanece reconhecível |
| Comportamento de recusa | prompts que devem ser recusados | recusas são consistentes e se enquadram em categorias claras |
| Reprodutibilidade | chamadas repetidas com a mesma seed e versão do modelo | saídas permanecem próximas quando seed e versão correspondem |
Pontue cada linha separadamente. Um número agregado esconde um modelo que renderiza rótulos de produtos perfeitamente e recusa todo prompt contendo uma criança, ou um com belos retratos e texto que parece um CAPTCHA. A falha que prejudica é sempre específica da categoria, e a média dela em uma única pontuação é como ela chega à produção despercebida.
O roteamento adiciona um problema de governança que o teste do modelo não detectará. Quando um marketplace ou camada de failover troca de provedores, o substituto deve oferecer garantias de moderação equivalentes, ou o resultado deve ser explicitamente marcado como tendo características de garantia diferentes. O relaxamento silencioso das verificações de segurança é o pior comportamento de failover possível: nada gera erros, e a saída simplesmente chega com uma revisão mais fraca por trás. Mantenha as decisões de moderação e as versões do modelo no registro de auditoria, e exponha categorias de erro nas quais sua aplicação pode se ramificar.
Tamanho da amostra que funciona na prática: algumas dezenas de prompts por categoria para uma primeira passagem, com os prompts e saídas exatos salvos em um repo. Execute novamente todo o conjunto sempre que uma string de versão do modelo mudar, não sempre que alguém reclamar.
Esse último ponto é o que as equipes pulam. Um identificador de modelo pode apontar para uma nova build sem qualquer alteração do seu lado, então o conjunto de testes não é um artefato de lançamento, é uma suíte de regressão que roda em cada ciclo de lançamento. Quando os resultados vão para stakeholders fora da engenharia, uma explicação em linguagem simples do que um único modelo faz, explicada pela ImagesArt AI, dá a essa conversa uma base comum antes que o debate sobre a pontuação comece.
Verificando a Fidelidade e Proveniência da Edição Antes do Lançamento
Uma edição com boa aparência não é uma edição bem-sucedida. A edição precisa ser avaliada duas vezes: uma para verificar se a mudança solicitada ocorreu e outra para verificar se todo o resto permaneceu no lugar. Lançar apenas com a primeira pontuação é como você obtém uma foto de produto onde o modelo redesenhou o logotipo.
A pesquisa apoia essa divisão. O artigo HQ-Edit apresenta Alinhamento e Coerência como métricas separadas e relata que o fine-tuning melhorou o Alinhamento em 12.3 pontos e a Coerência em 5.64 pontos em um sistema avaliado. Dois números se movendo independentemente é o argumento principal: uma saída pode seguir a instrução e ainda destruir as partes que você precisava preservar, ou preservar tudo e ignorar a instrução.
O teste de aceitação que eu executaria antes do lançamento:
- Escolha 20 a 30 imagens de origem que incluam rostos, texto impresso, logotipos e fundos complexos. Fotos de produtos cortadas sozinhas passarão por um modelo que falha em um rosto.
- Escreva uma instrução por imagem e registre a mudança esperada na mesma linha. Instruções ambíguas produzem discussões sobre os resultados, em vez de descobertas.
- Mascare a região editada e faça um diff do restante com a origem. Os pixels fora da máscara são sua pontuação de preservação, e um diff numérico resolve o que a inspeção visual não consegue.
- Pontue o alinhamento e a preservação em colunas separadas, depois observe os casos em que eles discordam. Esses são os prompts que precisam ser reformulados ou o modelo que precisa ser substituído.
- Passe cada saída por redimensionamento e conversão de formato, depois confirme que as marcas d'água ou credenciais de conteúdo sobreviveram. Proveniência que morre no seu pipeline de CDN é proveniência que você nunca teve.
- Confirme a política de conteúdo do provedor e qualquer dever de divulgação que se aplica nos mercados onde você atua. A política varia por provedor, e uma solicitação roteada pode ser regida por uma política diferente.
- Registre a cadeia de custódia do arquivo de origem ao ativo entregue, incluindo qual versão do modelo o processou.
O quinto passo é aquele que as equipes descobrem tarde. Credenciais e marcas d'água invisíveis são evidências sobre a origem, não prova de que um evento retratado é verdadeiro. A confiabilidade depende de identidades confiáveis, do processo de assinatura e de se cada etapa downstream preserva os metadados, então redimensionamento, corte e recodificação precisam de uma verificação. Um sinal de proveniência melhora a rastreabilidade, e não pode estabelecer autenticidade factual ou confirmar que os direitos estão liberados.
A conclusão desconfortável para quem está construindo um recurso de edição: metadados de proveniência respondem "de onde isso veio", e nunca respondem "esta afirmação é precisa" ou "temos a licença". Essas permanecem questões legais e editoriais.
Se a superfície de edição é o produto, trate a preservação da região como um critério eliminatório em vez de uma pontuação de qualidade. Um guia de API de edição de fotos é um companheiro útil para o lado do endpoint e dos parâmetros, e este guia AskYourQA para testes de IA ajuda a estruturar a pontuação para que o alinhamento e a preservação não se transformem em uma única impressão.
Latência, Erros e Comportamento de Retentativa em Produção
A maioria das comparações de API de imagem classifica o preço por imagem e a qualidade da amostra, e depois para. As caudas de latência, as taxas de falha e o comportamento de recuperação são os números que decidem se seu recurso parece quebrado, e são os números que ninguém publica. Um benchmark de geração de imagem afirma abertamente que a latência e o tempo de atividade observado são reservados para uma fase futura, enquanto um teste independente descobriu que os provedores geralmente não publicam números reais de latência e tiveram que medir os tempos de resposta, taxas de erro, inícios a frio (cold starts) e throughput por conta própria, conforme a análise de geração de imagem do API Benchmarks documenta.
Meça percentis, não médias. Acompanhe p50, p95 e p99 separadamente para chamadas de imagem síncronas e assíncronas, depois adicione a taxa de timeout, penalidade de cold-start, tempo desde a criação até o resultado recuperável e a taxa de saída bem-sucedida. Uma única média esconde a cauda que os usuários experimentam, que são os dois segundos onde a maioria das requisições chegam e os quarenta onde algumas não chegam.
Surpresas de tempo geralmente são sobre modalidade. Em nosso teste em 29 de outubro de 2026, um clipe Kling 3.0 de 5 segundos levou cerca de 80 segundos para gerar. Nada estava errado; vídeo simplesmente custa minutos onde imagens custam segundos, e um timeout copiado do caminho da imagem cancelará trabalhos que estavam progredindo normalmente.
| Sintoma | Causa provável | Solução |
|---|---|---|
| Tarefas permanecem em execução após o timeout | provedor lento ou indisponível | cancelar, depois tentar novamente com a mesma chave de idempotência ou redirecionar se disponível |
| Imagens duplicadas após um timeout de rede | chamada de criação retentada sem uma chave de idempotência | enviar uma chave de idempotência com cada requisição de criação |
| respostas 429 durante picos | limite de taxa atingido | recuar exponencialmente com jitter e enfileirar requisições |
| respostas 503 | provedor ou rota temporariamente indisponível | tentar novamente mais tarde com um limite, e fazer failover apenas se as garantias de segurança forem mantidas |
| respostas 402 | saldo ou verificação de pagamento falhou | recarregar o saldo, depois reenviar a mesma requisição |
| respostas 404 | identificador do modelo ou rota não encontrado | verificar o identificador em relação ao catálogo atual |
| Link da imagem não carrega mais | URL assinado expirou | baixar ao ter sucesso e armazenar o arquivo em seu próprio armazenamento |
Tente novamente apenas o que é retentável. Um 429 ou um 503 é transitório e merece um recuo exponencial com jitter e um limite rígido. Um 402 ou um 404 falhará identicamente para sempre, então corrija o saldo ou o identificador do modelo primeiro. Nossa API recusa chamadas com 402, 404, 429 e 503, e a categoria é o sinal, não apenas o status HTTP.
A leitura contrária sobre o custo: a API por imagem mais barata é frequentemente a mais cara em produção. Retentativas, gerações falhas e latência de cauda imprevisível empurram o trabalho de volta para sua aplicação e os usuários para fora do seu funil.
A confiabilidade já é um critério de compra, em 37% das organizações, atrás da otimização de custos em 58%, disponibilidade do modelo em 49% e velocidade em 41%, de acordo com a mesma análise de benchmarking. E a troca do marketplace é real: o roteamento entre provedores reduz interrupções, mas também adiciona variação no tempo de fila, desempenho regional e atraso do filtro de segurança. Cada requisição redirecionada deve ser medida como sua própria rota, com seus próprios percentis, ou o painel agregado esconderá exatamente o caminho que está falhando.
Como Integrar uma API de Imagem Passo a Passo
Uma integração em produção é uma pequena lista de decisões, e a maioria delas é sobre registros em vez de requisições. Aqui está a sequência que sobrevive ao contato com tráfego real.
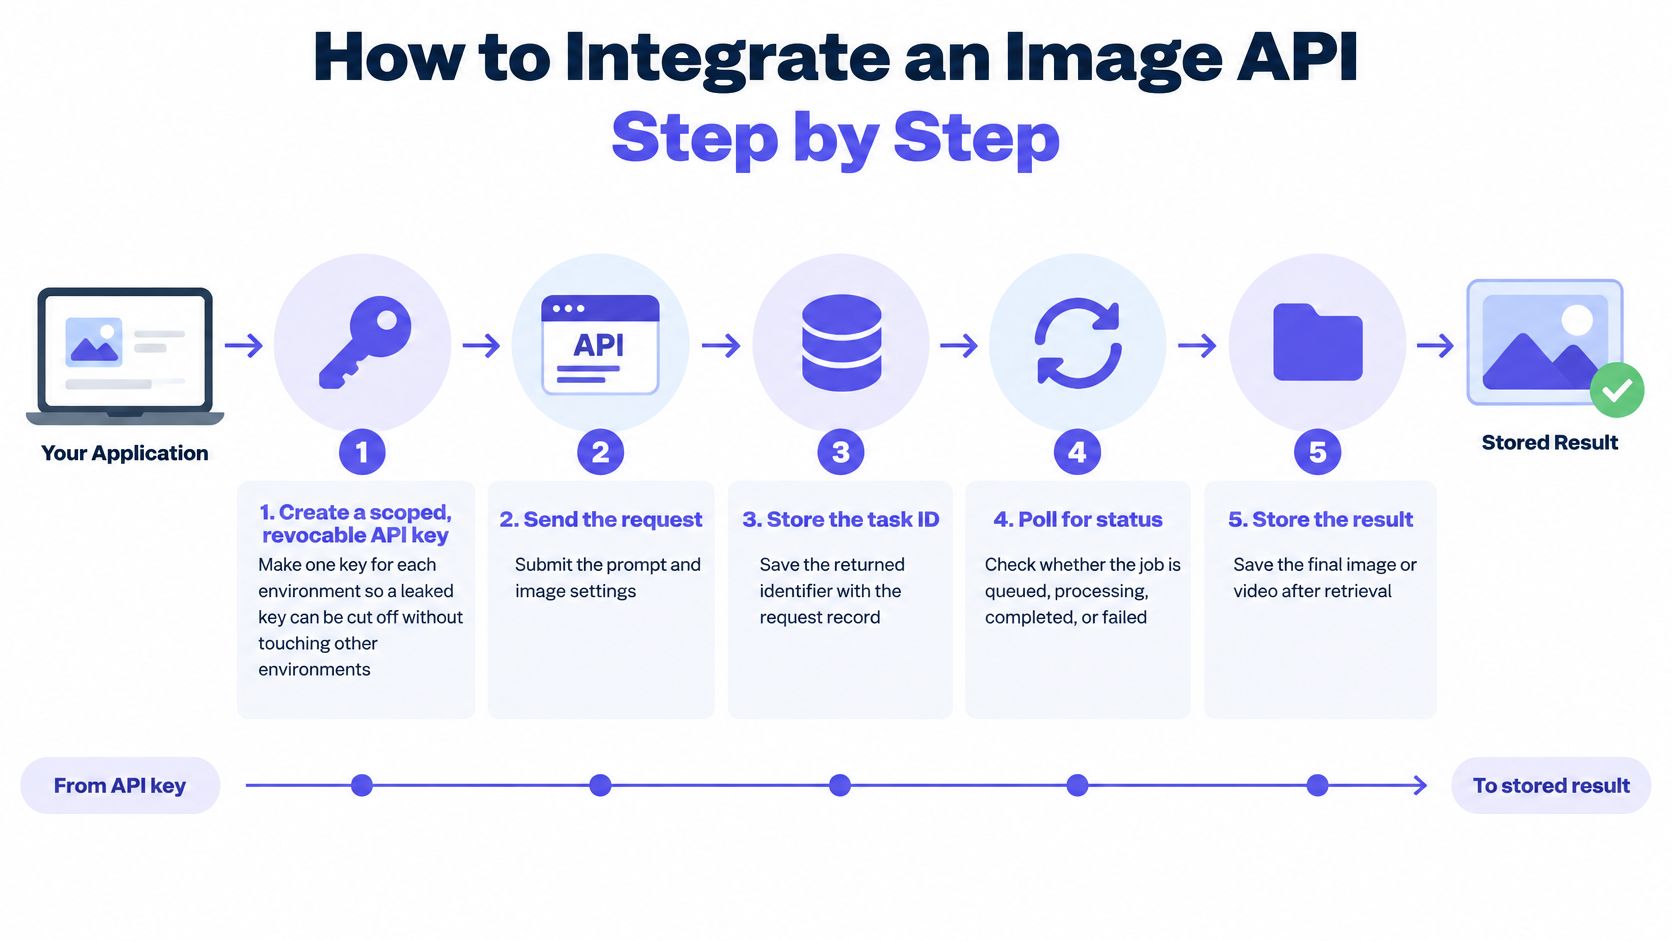
- Crie uma API key com escopo e revogável para cada ambiente. Chaves separadas significam que uma credencial de staging vazada pode ser revogada sem afetar o tráfego de produção.
- Aponte seu cliente existente para a nova base URL. A base compatível com OpenAI é a base URL compatível com OpenAI da UberLLM, e como a plataforma aceita os wire formats da OpenAI e da Anthropic, os clientes existentes funcionam assim que a base URL e as credenciais mudam. Confirme quais image endpoints dos quais você depende são suportados antes de fazer a transição.
- Copie o identificador do modelo como uma string completa do catálogo atual. Mudar de modelo então altera exatamente um valor, o que é um diff de uma linha em vez de um refactor. IDs nativos do provedor funcionam da mesma forma, como
fal-ai/kling-video/v3/standard/text-to-video. - Valide o tamanho e a proporção localmente, anexe uma idempotency key e, em seguida, envie a chamada de criação. As verificações baratas pertencem ao seu lado da rede.
- Armazene o identificador da tarefa com o registro da requisição e, em seguida, faça polling ou registre um webhook. Se o processo morrer entre a criação e o armazenamento, você pagou por uma saída que ninguém consegue encontrar.
- Em caso de sucesso, baixe o asset, verifique o checksum e salve-o no seu próprio armazenamento. Esperar até a próxima requisição do usuário para buscar o arquivo é como links expirados se transformam em tickets de suporte.
- Faça o log do identificador do modelo, do estado, da duração e da categoria de erro para cada job. Esses quatro campos respondem à maioria das perguntas de produção sem uma sessão de debugging.
- Exercite os caminhos de falha antes do lançamento, incluindo um 429, um request timeout e um link expirado. Código de retry não testado geralmente dobra a contagem de imagens duplicadas em vez de reduzi-la.
Um breve walkthrough vale mais do que a lista de campos para a primeira construção, especialmente em torno da recuperação:
Como uma integração funcional se parece no final disso: cada job tem um estado, cada job bem-sucedido tem um asset no seu bucket, e cada asset tem uma versão de modelo logada ao lado. Esse é o padrão completo. É também a diferença entre uma demo que impressionou alguém em março e uma funcionalidade que você ainda pode depurar em novembro.
Unidades de Cobrança e Como Comparar Custos Reais
Duas APIs podem ambas dizer "por imagem" e ainda assim cobrar de você de maneiras diferentes, porque a unidade, a dependência de tamanho e a política de falhas mudam a aritmética. Compare a unidade primeiro, depois calcule o custo por saída utilizável.
| Modalidade | Unidade de cobrança usual | O que verificar |
|---|---|---|
| Geração de texto | tokens de entrada e saída | entrada e saída são precificadas separadamente |
| Geração de imagem | por imagem ou por megapixel | modelo e tamanho da saída mudam o custo unitário |
| Edição de imagem | por edição ou por imagem de saída | se a imagem de origem adiciona uma cobrança |
| Geração de vídeo | por clipe ou por segundo, dependendo do provedor | cobrado pelo preço final assim que a geração é concluída |
| Música e fala | por faixa, por minuto ou por caractere | a unidade que cada modelo realmente usa |
| Trabalhos falhos | cobrado por tentativa, ou não cobrado de forma alguma | se as gerações falhas aparecem na fatura |
A precificação por megapixel penaliza saídas grandes de uma forma que a precificação por imagem não faz. Um modelo que parece barato em 1024×1024 pode custar várias vezes mais em resolução de impressão, então compare no tamanho que seu produto renderiza em vez do tamanho na captura de tela de marketing.
Vídeo precisa de sua própria linha na previsão. Um clipe cobrado pelo seu preço final assim que a geração é concluída é mais fácil de projetar do que um medido enquanto está em execução, porque você está prevendo saídas finalizadas em vez de incerteza de tempo real. Edições são a linha sorrateira: verifique se a imagem de origem é cobrada como uma entrada, já que um fluxo de trabalho de retoque que envia uma fonte de 4 MB em cada chamada pode levar o custo unitário bem além do preço de edição anunciado.
Gerações falhas são o item de linha que, em última análise, decide entre dois fornecedores. Considere 1,000 trabalhos de imagem com uma taxa de falha de 5%. Se os trabalhos falhos forem cobrados, você paga por 1,000 trabalhos para receber 950 imagens utilizáveis, o que é aproximadamente 5% a mais por imagem utilizável do que o preço de tabela sugere. Se os trabalhos falhos não forem cobrados, você paga por 950. Mesmo preço de manchete, preço efetivo diferente.
A fórmula que eu usaria para uma estimativa mensal: volume esperado × preço unitário × fator de repetição, mais um buffer para edições e vídeo. O fator de repetição é o número que separa uma previsão de um desejo.
Então compare os preços unitários com seu próprio teste de aceitação, em vez da galeria de amostras do fornecedor. Se você quiser a lógica subjacente da precificação de token, imagem e clipe em um só lugar, esta análise de modelos de precificação de IA explica como cada unidade é medida.
Execute uma Chamada de Teste Antes de Escolher Seu Modelo
Uma chamada de teste deve responder mais do que “Esta imagem parece boa?” Verifique se o modelo atende ao seu padrão de qualidade, como ele lida com edições e como sua resposta se comporta sob a carga esperada. Uma imagem de amostra forte não pode dizer como a API se comportará em produção.
Escolha um candidato para texto-para-imagem e um que suporte edição. Mantenha o conjunto de prompts fixo entre os candidatos para que você possa comparar as saídas nas mesmas tarefas. Com o UberLLM, você pode trocar de modelo alterando o identificador do modelo, mantendo a API key e o endpoint.
Teste em ordem: primeiro, avalie as saídas em relação aos seus critérios de seleção; em seguida, execute o teste de aceitação de edição se seu recurso edita imagens; depois, meça a latência p50 e p95 na concorrência esperada. Finalize calculando o custo por saída utilizável, incluindo retentativas. Um modelo que não atinge o padrão de qualidade não precisa de um teste de carga.
Salve prompts, saídas e logs de requisição em seu repositório. Ao alterar um identificador ou versão de modelo, execute novamente o mesmo conjunto e compare os resultados. Para edições, inspecione se o resultado preserva os detalhes da fonte que sua aplicação precisa; uma imagem visualmente plausível ainda pode alterar a identidade ou outras características importantes.
Aprovar ou não aprovar: Promova um modelo apenas se ele passar nos testes de qualidade, edição e carga no volume esperado. Implante por trás de um feature flag e mantenha um segundo candidato disponível para failover. Se falhar, teste o próximo candidato contra o mesmo conjunto.
O preço faz parte da decisão, mas não deve liderá-la. O UberLLM lista a geração de imagens Nano Banana 2 a $0.015 por imagem, em comparação com um preço de tabela de $0.10 por imagem. Para testes de vídeo, o UberLLM recomenda o Kling 3.0 Standard como ponto de partida para texto-para-vídeo ou imagem-para-vídeo. Requisições de imagem e vídeo retornam uma task que você pode consultar (poll) ou rastrear através de um webhook, então inclua o tempo de conclusão e recuperação do resultado em seu teste.
O UberLLM oferece modelos de texto, imagem, vídeo, música e fala através de interfaces compatíveis com OpenAI e Anthropic. Use seu playground para comparar saídas de imagem, então execute os mesmos prompts de teste através do cliente API da sua aplicação. Avalie qualidade, fidelidade de edição, latência e custo por resultado utilizável juntos antes de escolher um modelo.