画像生成APIの選び方と統合方法
画像生成APIの機能、リクエストフィールド、非同期結果、モデルテスト、エラー処理、課金を比較し、本番環境への統合手順を説明します。
EverypixelのAI画像統計分析]によると、DALL-E 2のリリース以来、テキストから画像を生成するアルゴリズムによって、2023,年8月までに15億枚以上の画像が作成され、1日あたり平均およそ34百万枚に上ります。同じ分析では、そのうち約**12.6億枚、およそ80%**がStable Diffusionベースのモデル、サービス、アプリケーションによるものとされています。
この量になると、画像生成はクリエイティブなデモではなくなり、インフラストラクチャとなります。製品が出荷されるかどうかを決定する論点は、どのモデルがより美しい絵を描くかというものではなく、リクエスト契約、ジョブの状態、タイムアウトの挙動、そして失敗した生成が請求書に載るかどうか、といったことになります。
これは、画像生成APIレイヤーに関する開発者向けガイドです。リクエストがどのように形成されるか、タスクがライフサイクルをどのように進むか、リーダーボードを信頼するのではなくモデルをテストする方法、そしてコストがどこに隠れているか、を網羅しています。画像あたりの価格は比較しやすい数字ですが、それだけでは最も役に立たないものです。
目次
- 画像生成APIの機能概要
- リクエストパターンとレスポンスフィールド
- 非同期ジョブ、タスクの状態、結果の取得
- モデル選択の基準とテスト方法
- リリース前の編集の忠実度と出所の確認
- 本番環境でのレイテンシー、エラー、リトライ動作
- 画像APIの段階的な統合方法
- 課金単位と実際のコストの比較方法
- モデル選択前のテストコール実行
画像生成APIの機能概要
| 機能 | 入力 | 出力 | 取得パターン |
|---|---|---|---|
| テキスト生成 | メッセージとパラメーター | ストリーミングテキスト | ストリーミング応答 |
| テキストから画像 | プロンプト、サイズ、モデル識別子 | 1つ以上の画像 | タスク、ポーリングまたはWebhook |
| 画像編集 | ソース画像、指示、サポートされている場合はオプションのマスク | 編集された画像 | タスク、ポーリングまたはWebhook |
| テキストから動画 | プロンプト、期間、解像度 | 動画ファイル | タスク、ポーリングまたはWebhook |
| 画像から動画 | ソース画像、プロンプト、期間 | 動画ファイル | タスク、ポーリングまたはWebhook |
| 音楽生成 | プロンプト、スタイル、期間 | 音声ファイル | タスク、ポーリングまたはWebhook |
| 音声合成 | テキスト、音声 | 音声ファイル | ストリーミング音声または返されたファイル |
1つのエンドポイントと1つのキーで複数のモデルファミリーを一度にカバーできます。なぜなら、モデル識別子がファミリーとバージョンを選択するからです。この利便性には注意点があります。各ファミリーは異なるパラメーターセットを受け入れるため、あるモデルで有効なボディが別のモデルでは失敗する可能性があり、サイズ、マスク、シードサポート、複数出力の制限もすべて異なります。
画像生成APIは、ホスト型推論サービスであり、3つの部分で構成されています。プロンプトと設定を署名付き呼び出しに変換するリクエスト契約、画像とそのメタデータを含む結果オブジェクト、そして単一のHTTP応答よりも長く続く作業のためのジョブライフサイクルです。各部分には独自の設計上の決定が必要であり、それぞれ異なる方法で失敗します。
このパターンは見た目よりも新しいものです。2022年8月22日にStable Diffusionが一般公開されたことで、ほとんどのプロバイダーが現在も使用しているサービス提供の形が確立されました。これはTechCrunchがローンチ時に報じた通りです。アプリケーションがプロンプトとパラメーターを投稿し、プロバイダーがGPU処理を実行し、画像またはタスクが返されます。そのモデルはハイエンドの消費者向けハードウェアで動作し、数秒で512×512ピクセルの画像を生成しました。これは、約5.85億の画像とテキストのペアからなるLAION-5Bというデータセットでトレーニングされ、そのうち約600万は美的フィルターが適用されたサブセットでした。Stability AIは、早期公開アクセス中に15,000人以上のテスターが1日あたり約2万枚の画像を生成していたと主張しました。これは、デスクトップソフトウェアではなく、ホスト型アクセスが需要の形であったことを示す最も明確な初期の兆候です。
今後のセクションでは、実際の実装でこれらの問題に遭遇する順序に従って説明します。まずリクエストフィールドとレスポンスオブジェクト、次に非同期タスクの状態、モデル選択テスト、編集の忠実度と出所、レイテンシーとリトライ、段階的な統合、課金単位、そして最終的なテスト呼び出しです。自動化されたパイプラインに生成機能を組み込むチームは、通常、ループ全体が一度実演されることを望んでいます。この自動化ワークフロー向け画像APIのウォークスルーでは、トリガーから保存されたアセットまでの全サイクルが示されています。
リクエストパターンとレスポンスフィールド
最初の統合のほとんどは、プロンプトではなくリクエストボディで問題が発生します。フィールドをワイヤー上で送信される順序で構築すれば、デバッグが短縮されます。
- モデル識別子。 最初に検討してください。なぜなら、残りのフィールドのどれが有効かを決定するからです。あるモデルが受け入れるネガティブプロンプトやマスクは、次のモデルでは拒否されるでしょう。
- プロンプトとネガティブプロンプト。 ネガティブプロンプトは一部のファミリーでサポートされていますが、他のファミリーでは無視されるため、仮定するのではなく確認してください。
- サイズまたはアスペクト比。 モデルが期待する方法で、ピクセル単位または指定された比率で表現してください。推論の前にローカルで検証してください。なぜなら、拒否された呼び出しはラウンドトリップのコストがかかり、遅れて失敗する生成はタイムアウトとキューのスロットのコストがかかるからです。
- 出力数。 呼び出しあたりの複数の出力は効率的に見えますが、課金が通常、呼び出しではなく数に比例して増えることに気づくまでは、そう見えます。
- 出力フォーマット。 PNG、JPEG、WebPは、バイト数と同じくらい、下流の変換作業に影響を与えます。
- シード。 再現性が重要な場合は必ず含めてください。これがないと、「もう一度実行」は「もう一度サイコロを振る」を意味します。
- Webhook URL。 長時間かかるジョブはリクエストが返された後に完了するため、密なポーリングループよりもコールバックの方が安価です。
- 冪等性キー。 生成は高価であるため、キーなしで再試行された作成は、2番目の課金対象ジョブとなり、重複した画像が生成されます。
費用をかける前に検証してください。 まず、アスペクト比、モデル識別子、および必須フィールドを独自のコードで確認してください。ローカルでのスキーマチェックは、キュー待機後に400として現れるようなエラーのクラスを捕捉し、不正なトラフィックを従量制のendpointから完全に排除します。
レスポンス側は、チームがすでに支払ったアセットを失う場所です。OpenAIの画像APIリファレンスは、ほとんどのプロバイダーが収束する形を示しています。これは、base64ペイロード、ホストされたURL、そしてサポートされている場合は修正されたプロンプトを含む画像オブジェクトです。プロバイダーが返すものを独自の安定したスキーマに正規化し、スキーマがまだモデル化していない制御のために生のプロバイダーメタデータブロックを保持してください。
| フィールド | 内容 | 本番環境での注意点 |
|---|---|---|
| アセットURL | 生成されたファイルへのリンク | 短命でアクセス制御されているため、期限切れになる前にダウンロードしてください |
| b64_json | base64エンコードされた画像バイト | 小規模な同期レスポンスには適していますが、大規模なペイロードではメモリを大量に消費します |
| revised_prompt | モデルが言い換えたプロンプト | 予期しない出力を説明するため、保存してください |
| モデル識別子 | 出力を生成したモデルとバージョン | 監査と再現のために必須 |
| 寸法とフォーマット | 幅、高さ、MIMEタイプ | 要求されたアスペクト比と照合して確認してください |
| チェックサム | ファイルの整合性ハッシュ | ダウンロード後およびフォーマット変換後に検証してください |
base64は転送の詳細として扱い、ストレージ戦略として扱わないでください。 エンコードされた画像はペイロードを約3分の1膨張させ、アプリがJSONをパースしている間メモリに留まります。本番環境のメディアでは、デコードされたバイトをオブジェクトストレージに書き込み、代わりに署名付き取得URLをフロントエンドに渡してください。その際にMIMEタイプとチェックサムをレコードに追加することで、破損したダウンロードがユーザーではなくパイプラインによって捕捉されるようになります。
コードレビューで強制したいルール: 保存されるすべてのアセットは、そのメタデータにモデル識別子、シード、有効なプロンプト、およびリクエストタイムスタンプを保持すること。これら4つがなければ、「先月の変な画像」に関するサポートチケットには答えがありません。
この習慣は、モデルのバージョンが変更されて出力がずれたときに初めて報われます。保存されたメタデータは、漠然とした苦情を実行可能な比較に変えます。
非同期ジョブ、タスクの状態、および結果の取得
画像や動画の処理はチャット完了時に返されません。ジョブを作成し、その識別子を保持し、進行状況を監視してください。
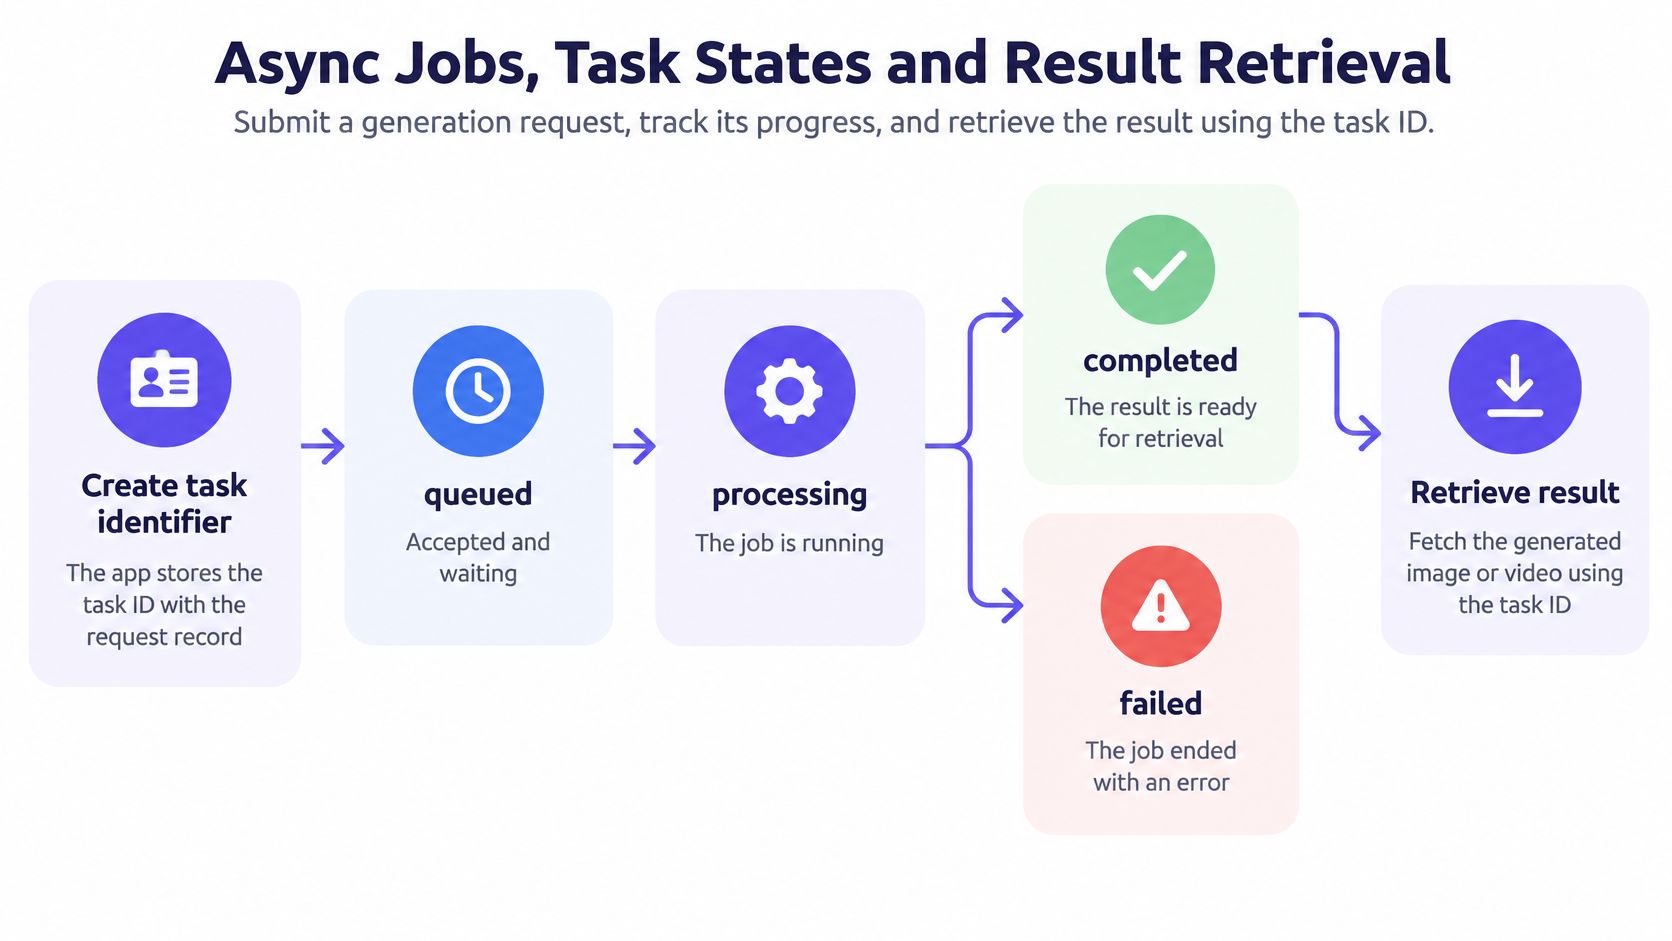
作成呼び出しはタスク識別子を返し、アプリケーションはそれをプロンプトとモデルを保持する同じリクエストレコードに書き込みます。そこからジョブは5つの状態のいずれかを報告し、それぞれがコードに異なる処理を要求します。
| 状態 | 意味 | アプリがすること |
|---|---|---|
| queued | 受理され、容量を待機中 | タスクIDを保持し、スケジュールに従ってポーリングする |
| running | 生成処理中 | 待機し、モダリティに合わせたタイムアウトを適用する |
| succeeded | 出力が準備完了 | アセットを直ちにダウンロードして保存する |
| failed | 生成が完了しなかった | 再試行する前にエラーカテゴリを読み取る |
| expired | 出力が取得できなくなった | 再生成し、結果の欠落として扱わない |
expired状態は、チームが自社システムのバグのように見えるため、見落としがちです。しかし、そうではありません。プロバイダーは結果ファイルを限られた期間保持し、その期間は短いです。UberLLMでは、画像リンクは約15分間有効であり、動画や音楽の結果ファイルはジョブ完了後約3時間保持されます。10分ごとにチェックし、次のデプロイサイクルで処理するポーリングループでは、画像リンクを完全に見逃してしまいます。
結果の取得は2つのメカニズムで実行され、成熟したシステムでは両方を使用します。ポーリングはウェブフックが失った配信をカバーし、サービスが公開endpointを公開できない場合の唯一の選択肢です。ウェブフックは、状態がいつ変更されたかを正確に通知することで、無駄なリクエストを削減します。これは、ジョブが1秒ではなく1分かかる場合に重要です。ウェブフックとポーリングのトレードオフは、障害処理に帰着します。ウェブフックはレシーバーがダウンしているときに失敗し、ポーリングは間隔が短すぎるとコストのかかる失敗をします。
ポーリング間隔は、コードベースではなくモダリティに従うべきです。4秒の画像ジョブで機能する単一の固定ループは、1分以上かかる動画ジョブでは数十回の呼び出しを無駄にします。
テキスト応答はtokenごとにstreamingで返されますが、画像や動画のジョブは、ポーリングするか、ウェブフックが準備完了を報告するタスクを渡します。この違いは、表面的なものではなくアーキテクチャ上のものです。即座に返されるリクエストでも、まだ完了していない作業を所有しており、誰かがそれを記憶しておく必要があります。最終状態だけでなく、状態遷移の時間もログに記録してください。queuedとrunningの間のギャップは、容量の問題がユーザーに到達する前に現れる場所だからです。
モデル選定基準とテスト方法
公開されているランキングは、あなたの製品では誰も送信しないようなプロンプトでモデルを評価しています。それらは、あなたが制御できない条件下でのサンプル品質を測定するものであり、レイテンシのテール、拒否の一貫性、ビルド間で出力がどのように変化するかについては何も語りません。あなた自身の画像カテゴリから構築されたテストセットは、リーダーボードが1ヶ月かけて伝えるよりも多くのことを、たった半日で教えてくれます。そして、それは次のモデルリリース後も有効です。
評価は、好みの問題ではなく、測定可能な行動でなければなりません。正式な評価プログラムは、画像生成をロードテストがスループットを扱うのと同じ方法で扱います。つまり、レビュアーの印象ではなく、定義されたプロトコル、固定された入力、スコア化された出力です。本番環境のAPIは、すべての呼び出しで同じ再現可能な次元をログに記録すべきです。プロンプトカテゴリ、モデルとバージョン、利用可能な場合はシード、解像度、レイテンシ、失敗モード、安全性の結果などです。リクエストごとのレイテンシをログに記録し、テールが見えるようにしてください。健全な中央値であっても、タイムアウトに達するほど長くハングするジョブの上に成り立っている可能性があるからです。
| 基準 | 測定方法 | 合格シグナル |
|---|---|---|
| プロンプトへの忠実性 | カテゴリごとの固定プロンプトセットのスコア付きレビュー | 必須のオブジェクト、数、色が出力のほとんどに現れる |
| 知覚品質 | チームによるブラインドでの並列レビュー | レビュアーはどのモデルが作成したかを知らずに出力を選ぶ |
| テキストレンダリング | 正確な単語やラベルを要求するプロンプト | ほとんどのサンプルで単語が正しくスペルされている |
| アイデンティティの一貫性 | 複数の生成にわたる同じ被写体 | 顔、製品、またはキャラクターが認識可能なままである |
| 拒否動作 | 拒否されるべきプロンプト | 拒否が一貫しており、明確なカテゴリに分類される |
| 再現性 | 同じシードとモデルバージョンでの繰り返し呼び出し | シードとバージョンが一致する場合、出力は近い状態を保つ |
各行を個別に採点してください。 集計された数値は、製品ラベルを完璧にレンダリングするが子供を含むすべてのプロンプトを拒否するモデルや、美しいポートレートを生成するがCAPTCHAのように読めるテキストを生成するモデルを隠してしまいます。痛手となる失敗は常にカテゴリ固有のものであり、それを単一のスコアに平均化してしまうと、気づかれずに本番環境に到達してしまいます。
ルーティングは、モデルテストでは捕捉できないガバナンスの問題を追加します。マーケットプレイスやフェイルオーバー層がプロバイダーを交換する場合、代替品は同等のモデレーション保証を備えている必要があります。そうでない場合、結果は異なる保証特性を持つものとして明示的にマークされなければなりません。安全チェックのサイレントな緩和は、最悪のフェイルオーバー動作です。エラーは発生せず、出力は単に弱いレビューの背後にある状態で届きます。モデレーションの決定とモデルのバージョンを監査記録に保持し、アプリケーションが分岐できるエラーカテゴリを公開してください。
実用的なサンプルサイズ: 最初のパスではカテゴリごとに数十個のプロンプトを用意し、正確なプロンプトと出力をリポジトリに保存します。誰かが不平を言うたびにではなく、モデルのバージョン文字列が変更されるたびに、セット全体を再実行してください。
最後のポイントは、チームが見落としがちな点です。モデル識別子は、あなたの側で何も変更することなく新しいビルドを指す可能性があります。そのため、テストセットはローンチ成果物ではなく、すべてのリリースサイクルで実行される回帰テストスイートです。結果がエンジニアリング以外のステークホルダーに渡される場合、単一のモデルが何をするのかを平易な言葉で説明したImagesArt AIによる解説]は、採点に関する議論が始まる前に共通の認識基盤を提供します。
リリース前の編集の正確性と出所の確認
見た目が良い編集が、必ずしも成功した編集とは限りません。編集は2つの観点から評価する必要があります。1つは要求された変更が適用されたか、もう1つはそれ以外の部分が元の状態を維持しているかです。最初の評価だけでリリースしてしまうと、モデルがロゴを書き換えてしまった製品写真ができてしまう、といった事態になりかねません。
この分離は研究によって裏付けられています。HQ-Edit論文]では、アライメント(Alignment)とコヒーレンス(Coherence)を別々の指標として導入し、ある評価システムにおいて、ファインチューニングによってアライメントが12.3ポイント、コヒーレンスが5.64ポイント改善されたと報告しています。2つの数値が独立して動くという点が、この議論の核心です。出力は指示に従いつつも、保持したかった部分を破壊してしまうこともあれば、すべてを保持しつつも指示を無視してしまうこともあります。
リリース前に実施すべき受け入れテストは次のとおりです。
- 顔、印刷されたテキスト、ロゴ、複雑な背景が含まれる20〜30枚のソース画像を選択します。トリミングされた製品写真だけでは、顔で破綻するモデルでも合格してしまいます。
- 画像ごとに1つの指示を記述し、期待される変更を同じ行に記録します。曖昧な指示は、発見ではなく結果に関する議論を生み出します。
- 編集された領域をマスクし、残りの部分をソースと比較して差分を取ります。マスクの外側のピクセルが保存スコアとなり、目視では判断できないことを数値的な差分が解決します。
- アライメントと保存を別々の列でスコアリングし、それらが一致しないケースを確認します。それらは、プロンプトの修正が必要な場合、またはモデルの置き換えが必要な場合です。
- すべての出力をリサイズとフォーマット変換に通し、ウォーターマークやコンテンツクレデンシャルが残っていることを確認します。CDNパイプラインで失われる出所情報は、最初からなかったものと同じです。
- 出荷先の市場で適用されるプロバイダーのコンテンツポリシーと開示義務を確認します。ポリシーはプロバイダーによって異なり、ルーティングされたリクエストは別のポリシーの適用を受ける可能性があります。
- ソースファイルから納品されたアセットまで、どのモデルバージョンが処理したかを含め、カストディチェーンを記録します。
5番目のステップは、チームが後になって気づくことが多いものです。クレデンシャルや不可視のウォーターマークは、出所に関する証拠であり、描写された出来事が真実であることの証明ではありません。信頼性は、信頼できるID、署名プロセス、そしてすべてのダウンストリームステップがメタデータを保持しているかどうかにかかっています。そのため、リサイズ、クロップ、再エンコードのすべてをチェックする必要があります。出所情報はトレーサビリティを向上させますが、事実の真正性を確立したり、権利がクリアされていることを確認したりすることはできません。
編集機能を構築する人にとって、不都合な結論は次のとおりです。出所メタデータは「これはどこから来たのか」という問いに答えますが、「この主張は正確か」や「ライセンスは取得済みか」という問いには決して答えません。それらは法務および編集上の問題として残ります。
編集インターフェースが製品である場合、領域の保存は品質スコアではなく、厳格なゲートとして扱うべきです。写真編集APIガイド]は、エンドポイントとパラメーターの側面で役立つ参考資料であり、このAskYourQAのAIテストガイド]は、アライメントと保存が単一の印象に集約されないようにスコアリングを構造化するのに役立ちます。
本番環境でのレイテンシー、エラー、およびリトライ動作
ほとんどの画像API比較では、画像あたりの価格とサンプル品質を評価し、そこで終わります。レイテンシーのテール、障害発生率、回復動作は、機能が壊れていると感じるかどうかを決定する数値であり、誰も公開しない数値です。ある画像生成ベンチマークでは、レイテンシーと観測された稼働時間は将来のフェーズのために予約されていると明言しており、独立したテストでは、プロバイダーが実際のレイテンシー数値を一般的に公開しておらず、API Benchmarksの画像生成分析]が文書化しているように、応答時間、エラー率、コールドスタート、スループット自体を測定する必要があることが判明しました。
平均ではなく、パーセンタイルを測定してください。同期および非同期の画像呼び出しについて、p50, p95 および p99 を個別に追跡し、タイムアウト率、コールドスタートペナルティ、作成から取得可能な結果までの時間、および成功出力率を追加します。単一の平均は、ユーザーが経験するテールを隠します。それは、ほとんどのリクエストが到達する2秒と、一部のリクエストが到達しない40秒です。
タイミングの予期せぬ事態は、通常、モダリティに関するものです。2026年10月29日でのテストでは、5秒のKling 3.0クリップの生成に約80秒かかりました。何も問題はありませんでした。ビデオは画像が秒単位であるのに対し、分単位のコストがかかるだけであり、画像パスからコピーされたタイムアウトは、正常に進行していたジョブをキャンセルしてしまいます。
| 症状 | 考えられる原因 | 解決策 |
|---|---|---|
| タスクがタイムアウトを超えて実行中のままになる | プロバイダーが遅い、または利用できない | キャンセルし、同じidempotency keyで再試行するか、利用可能であればルーティングを変更する |
| ネットワークタイムアウト後に画像が重複する | idempotency keyなしで作成呼び出しが再試行された | すべての作成リクエストにidempotency keyを送信する |
| バースト時の429応答 | レート制限に達した | ジッターを伴う指数関数的バックオフを行い、リクエストをキューに入れる |
| 503応答 | プロバイダーまたはルートが一時的に利用できない | 上限を設けて後で再試行し、安全保証が保持される場合にのみフェイルオーバーする |
| 402応答 | 残高または支払いチェックが失敗した | 残高を補充し、同じリクエストを再送信する |
| 404応答 | モデル識別子またはルートが見つからない | 現在のカタログに対して識別子を確認する |
| 画像リンクが読み込まれなくなる | 署名付きURLの有効期限が切れた | 成功時にダウンロードし、ファイルを独自のストレージに保存する |
再試行可能なものだけを再試行してください。429または503は一時的なものであり、ジッターとハードキャップを伴う指数関数的バックオフに値します。402または404は永久に同じように失敗するため、まず残高またはモデル識別子を修正してください。当社のAPIは、402, 404, 429 および 503, の呼び出しを拒否し、HTTPステータスだけでなく、カテゴリがシグナルとなります。
コストに関する逆説的な見方: 最も安価な画像あたりのAPIは、本番環境では最も高価になることがよくあります。再試行、失敗した生成、予測不能なテールレイテンシーは、作業をアプリケーションに押し戻し、ユーザーをファネルから押し出します。
同じベンチマーク分析によると、信頼性はすでに購入基準となっており、コスト最適化の58%、モデル可用性の49%、速度の41%に次いで、**組織の37%**で重視されています。そして、マーケットプレイスのトレードオフは現実的です。プロバイダー間でのルーティングは停止を減らしますが、キュー時間、地域パフォーマンス、安全フィルターの遅延にばらつきも加えます。ルーティングが変更されたすべてのリクエストは、独自のパーセンタイルを持つ独自のルートとして測定されるべきです。そうしないと、集計ダッシュボードは、まさに失敗しているパスを隠してしまいます。
画像APIを段階的に統合する方法
本番環境での統合は、決定事項の短いリストであり、そのほとんどはリクエストよりもレコードに関するものです。ここでは、実際のトラフィックに耐えうるシーケンスを紹介します。
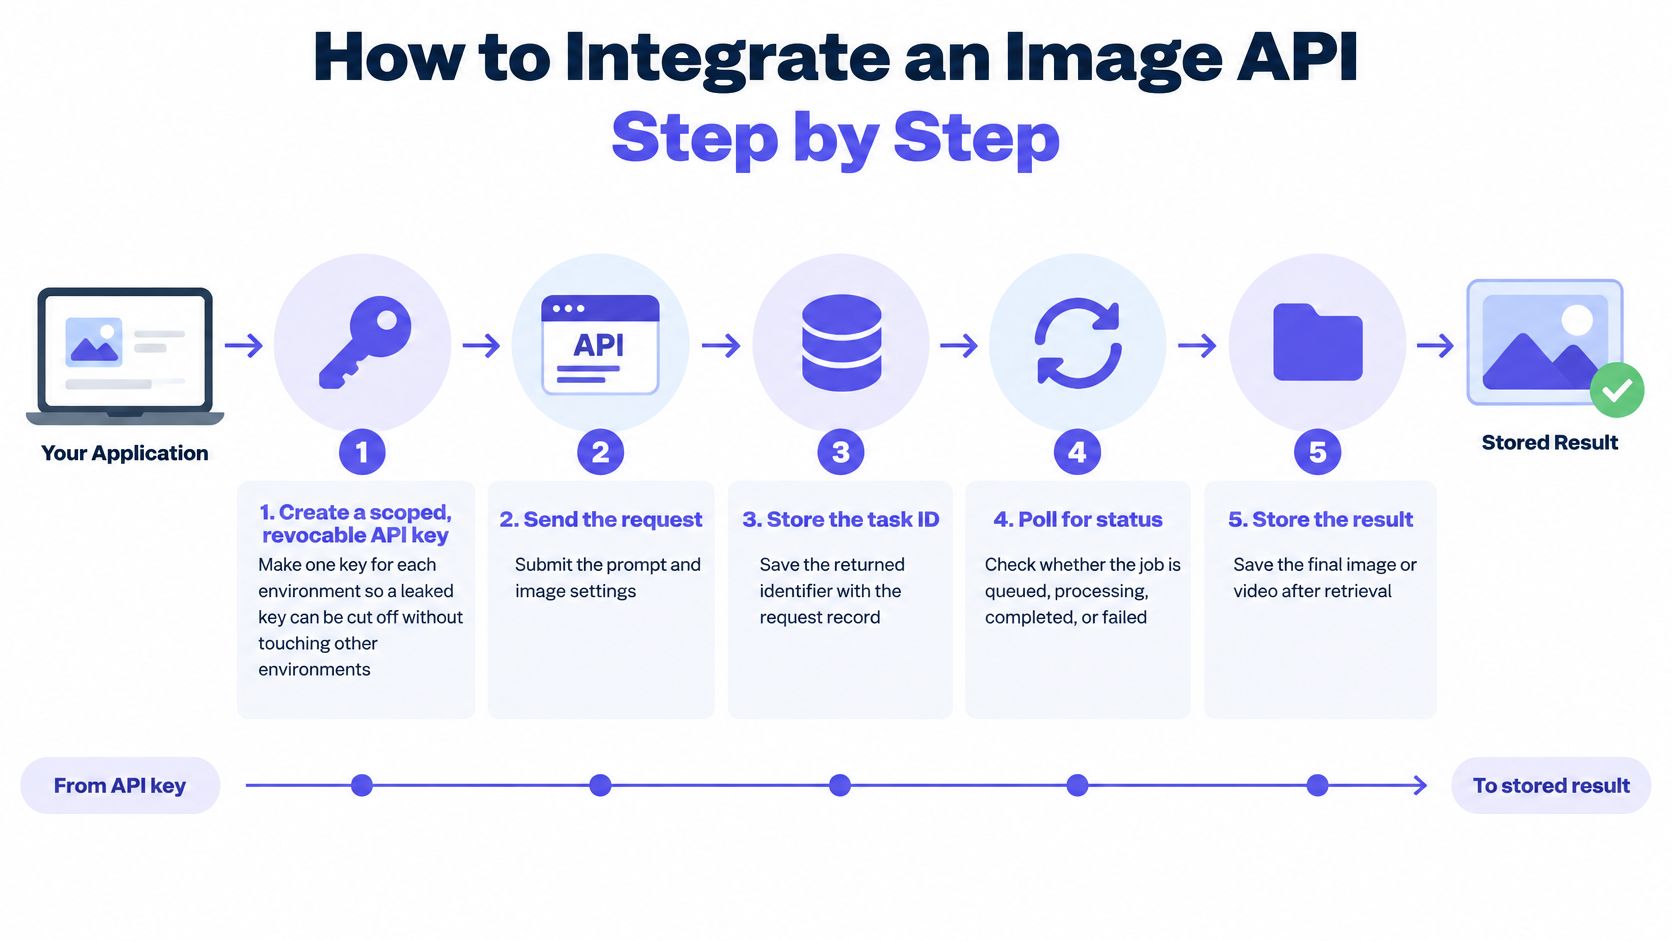
- 各環境にスコープ付きで取り消し可能なキーを作成します。 キーを分けることで、ステージング環境の認証情報が漏洩した場合でも、本番環境のトラフィックに影響を与えることなく取り消すことができます。
- 既存のクライアントを新しいbase URLに向けます。 OpenAI互換のベースはUberLLM OpenAI互換base URLであり、プラットフォームがOpenAIとAnthropicの両方のワイヤーフォーマットを受け入れるため、base URLと認証情報を変更すれば既存のクライアントが機能します。切り替える前に、依存する画像endpointがサポートされていることを確認してください。
- 現在のカタログからモデル識別子を完全な文字列としてコピーします。 モデルを切り替える際は、正確に1つの値が変更されるだけで、refactorではなく1行のdiffになります。プロバイダーネイティブのIDも同様に機能します。例えば
fal-ai/kling-video/v3/standard/text-to-videoです。 - サイズとアスペクト比をローカルで検証し、冪等性キーを付与してから、作成呼び出しを送信します。 安価なチェックはネットワークのあなたの側で行うべきです。
- タスク識別子をリクエストレコードと共に保存し、その後pollするか、webhookを登録します。 作成と保存の間にプロセスが停止した場合、誰も見つけられない出力に対して料金を支払ったことになります。
- 成功したら、アセットをダウンロードし、チェックサムを検証して、自身のストレージに保存します。 次のユーザーリクエストまでファイルの取得を待つと、期限切れのリンクがサポートチケットに変わる原因となります。
- すべてのジョブについて、モデル識別子、状態、期間、エラーカテゴリをログに記録します。 これら4つのフィールドがあれば、debugging sessionなしでほとんどの本番環境の質問に答えることができます。
- ローンチ前に失敗パスをテストします。これには
429,、リクエストタイムアウト、期限切れリンクが含まれます。テストされていないリトライコードは、通常、重複画像の数を減らすのではなく、倍増させます。
最初のビルドでは、フィールドリストよりも短いウォークスルーの方が価値があります。特に取得に関して言えば、
この統合の最終的な姿は、すべてのジョブに状態があり、すべての成功したジョブにはあなたのバケットにアセットがあり、すべてのアセットにはログに記録されたモデルバージョンが隣接していることです。それが標準のすべてです。それはまた、3月に誰かを感動させたデモと、11月になってもdebugできる機能との違いでもあります。
請求単位と実際のコストを比較する方法
2つのAPIがどちらも「画像あたり」と謳っていても、請求方法は異なる場合があります。単位、サイズ依存性、および失敗ポリシーによって計算が変わるためです。まず単位を比較し、次に利用可能な出力あたりのコストを計算してください。
| モダリティ | 通常の請求単位 | 確認事項 |
|---|---|---|
| テキスト生成 | 入力および出力トークン | 入力と出力は別々に課金されます |
| 画像生成 | 画像あたりまたはメガピクセルあたり | モデルと出力サイズによって単位コストが変わります |
| 画像編集 | 編集あたりまたは出力画像あたり | ソース画像に追加料金が発生するかどうか |
| 動画生成 | プロバイダーによってクリップあたりまたは秒あたり | 生成完了時に最終価格で請求されます |
| 音楽と音声 | トラックあたり、分あたりまたは文字あたり | 各モデルが実際に使用する単位 |
| 失敗したジョブ | 試行ごとに課金されるか、まったく課金されないか | 失敗した生成が請求書に記載されるかどうか |
メガピクセルあたりの価格設定は、画像あたりの価格設定とは異なり、大きな出力に不利に働きます。 1024×1024では安価に見えるモデルでも、印刷解像度では数倍のコストがかかることがあります。そのため、マーケティングのスクリーンショットのサイズではなく、製品がレンダリングするサイズで比較してください。
動画は予測において独自の項目が必要です。生成完了時に最終価格で請求されるクリップは、実行中に計測されるものよりも予測が容易です。なぜなら、ウォールクロックの不確実性ではなく、完成した出力を予測するからです。編集は厄介な項目です。ソース画像が入力として課金されるかどうかを確認してください。なぜなら、呼び出しごとに4 MBのソースを送信するレタッチワークフローでは、単位コストが広告されている編集価格をはるかに超える可能性があるからです。
失敗した生成は、最終的に2つのベンダーを決定する項目です。5%の失敗率で1,000の画像ジョブを考えてみましょう。失敗したジョブが課金される場合、950の利用可能な画像を受け取るために1,000のジョブに対して支払うことになり、これは表示価格よりも利用可能な画像あたりおよそ5%多くなります。失敗したジョブが課金されない場合、950を支払います。見出し価格は同じでも、実質価格は異なります。
月間見積もりに使用する式: 予想量 × 単位価格 × リトライ係数、これに編集と動画のバッファを加える。リトライ係数は、予測と希望を分ける数値です。
次に、ベンダーのサンプルギャラリーではなく、独自の受け入れテストに対して単位価格を比較してください。トークン、画像、クリップの価格設定の根底にあるロジックをまとめて知りたい場合は、AI pricing modelsのこの内訳で、各単位がどのように計測されるかが説明されています。
モデルを選ぶ前にテストコールを実行する
テストコールは、「この画像は良く見えるか?」という問い以上の答えを出すべきです。モデルが品質基準を満たしているか、編集をどのように処理するか、そして想定される負荷の下でその応答がどのように振る舞うかを確認してください。強力なサンプル画像だけでは、APIが本番環境でどのように機能するかを伝えることはできません。
テキストから画像への生成モデルと、編集をサポートするモデルをそれぞれ1つずつ候補として選びます。同じタスクで出力を比較できるように、候補全体でプロンプトセットを固定してください。UberLLMでは、API keyとendpointを維持したまま、model identifierを変更することでモデルを切り替えることができます。
次の順序でテストします。まず、選択基準に基づいて出力を評価します。次に、機能が画像を編集する場合は、編集受け入れテストを実行します。その後、想定されるconcurrencyでp50とp95のlatencyを測定します。最後に、リトライを含めた利用可能な出力あたりのコストを計算します。品質基準を満たさないモデルは、load testを必要としません。
プロンプト、出力、およびrequest logsをrepositoryに保存します。model identifierまたはバージョンを変更した場合は、同じセットを再実行し、結果を比較します。編集については、結果がアプリケーションに必要なソースの詳細を保持しているかを確認します。視覚的に妥当な画像でも、identityやその他の重要な特徴が変更される可能性があります。
採用可否: モデルは、想定されるボリュームで品質、編集、およびload testsに合格した場合にのみ採用してください。feature flagの背後でデプロイし、failoverのために2番目の候補を用意しておきます。失敗した場合は、同じセットで次の候補をテストします。
価格は決定要素の一つですが、それが主導すべきではありません。UberLLMでは、Nano Banana 2の画像生成を画像あたり$0.015で提供しており、これは画像あたり$0.10のリスト価格と比較されます。動画テストには、UberLLMはtext-to-videoまたはimage-to-videoの出発点としてKling 3.0 Standardを推奨しています。画像および動画のrequestは、pollまたはwebhookを通じて追跡できるtaskを返すため、テストには完了までの時間と結果の取得を含めてください。
UberLLMは、OpenAIおよびAnthropic互換のinterfacesを通じて、テキスト、画像、動画、音楽、および音声モデルを提供しています。そのplaygroundを使用して画像の出力を比較し、その後、アプリケーションのAPI clientを通じて同じテストプロンプトを実行してください。モデルを選択する前に、品質、編集の忠実度、latency、および利用可能な結果あたりのコストを総合的に評価してください。